
使用pandas库实现csv行和列的获取
1、读取csv
import pandas as pd

df = pd.read_csv('路径/py.csv')
2、取行号
index_num = df.index
举个例子:
import pandas as pd

df = pd.read_csv('./IP2LOCATION.csv',encoding= 'utf-8')

index_num = df.index

print(index_num)

3、取出行
import pandas as pd

df = pd.read_csv('./IP2LOCATION.csv',encoding= 'utf-8',header=None)

# print(type(df))

df.columns = ['a','b','c','d','e','f']

# 获取行数

# index_num = df.index

# print(index_num)

# 取出某一行

# row_data_1 = df.iloc[0]

# row_data_2 = df.iloc[[0]]

# 取出连续的行

# row_data_3 = df.iloc[0:2]

# row_data_4 = df[0:2]

# 取出不连续的行

# row_data_5 = df.iloc[[0,2]]

# print(row_data_5)
只取一行
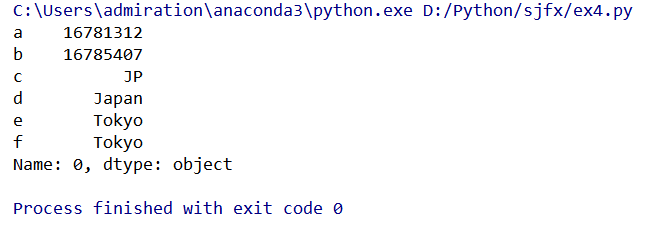
可以使用df.iloc[行号],得到的是series
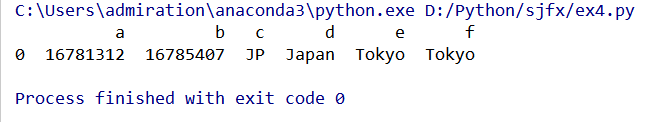
也可以使用df.iloc[[行号]],得到的是dataframe
row_data_1 = df.iloc[0] # pandas series
row_data_2 = df.iloc[[0]] # dataframe
loc是显式的索引,默认第一行的行号为1,行号从1计数
iloc是隐式的索引,默认第一行的行号为0,行号从0计数
row_data_1
row_data_2
取连续的几行
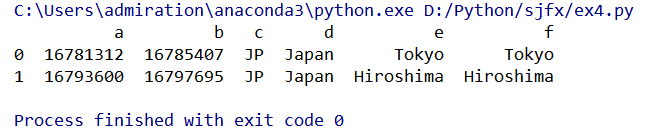
可以用df.iloc[行号:行号],也可以用df[行号:行号],得到的都是dataframe
row_data_3 = df.iloc[0:2]

row_data_3 = df[0:2]
row_data_3
row_data_4

取出不连续的几行
使用df.iloc[[行号,行号]],特别注意是两个方括号,中间是逗号,得到的是dataframe
row_data_5 = df.iloc[[0,2]]
row_data_5

4、取出列
import pandas as pd

df = pd.read_csv('./IP2LOCATION.csv',encoding= 'utf-8',header=None)

# print(type(df))

df.columns = ['a','b','c','d','e','f']

# 只取一列

# col_data_1 = df['a']   # 单独一列是个series

# col_data_2 = df.loc[:,'a']   # 同上,但比较复杂,一般不用

# col_data_3 = df.iloc[:,0]    # 同上,可以在不知道列名的时候用

#

# col_data_4 = df[['a']]  # 单独一列是个df

# col_data_5 = df.loc[:,['a']]    # 同上,但比较复杂,一般不用

# col_data_6 = df.iloc[:,[0]]     # 同上,可以在不知道列名的时候用

# print(col_data_4)

# 获取指定的几列

# cols_data_1 = df[['a','b']]    # DataFrame, 指定某几列,直接用列名

# cols_data_2 = df.loc[:,['a','b']]   # 同上,但比较复杂,一般不用

# cols_data_3 = df.iloc[:,[0,2]]     # 同上,可以在不知道列名的时候用

# print(cols_data_1)

# 获取指定的连续列

# cols_data_4 = df.loc[:,'a':'d']  # 指定连续列,用列名

# cols_data_5 = df.iloc[:,0:4]    # 指定连续列,用数字

# print(cols_data_4)
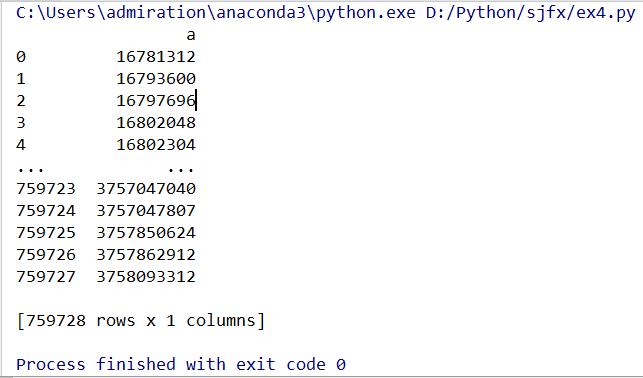
只取一列
col_data_1 = df['a']# 单独一列是个seriescol_data_2 = df.loc[:,'a']# 同上,但比较复杂,一般不用col_data_3 = df.iloc[:,0] # 同上,可以在不知道列名的时候用
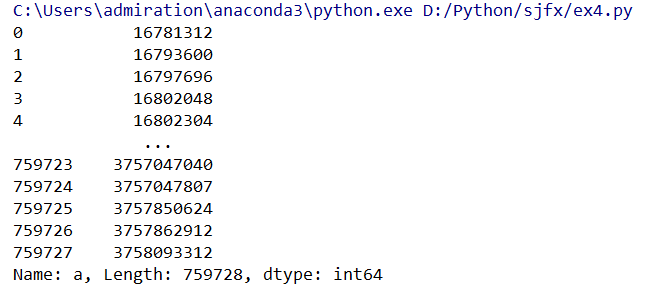
以上三种均为只取一列的操作,并且是等效的,获取的都是series类型
下面三种也是等效的,但是获取的是dataframe类型
col_data_4 = df[['a']]  # 单独一列是个df

col_data_5 = df.loc[:,['a']]    # 同上,但比较复杂,一般不用

col_data_6 = df.iloc[:,[0]]     # 同上,可以在不知道列名的时候用
取指定的某几列
cols_data_1 = df[['a','b']]    # DataFrame, 指定某几列,直接用列名

cols_data_2 = df.loc[:,['a','b']]   # 同上,但比较复杂,一般不用

cols_data_3 = df.iloc[:,[0,2]]     # 同上,可以在不知道列名的时候用

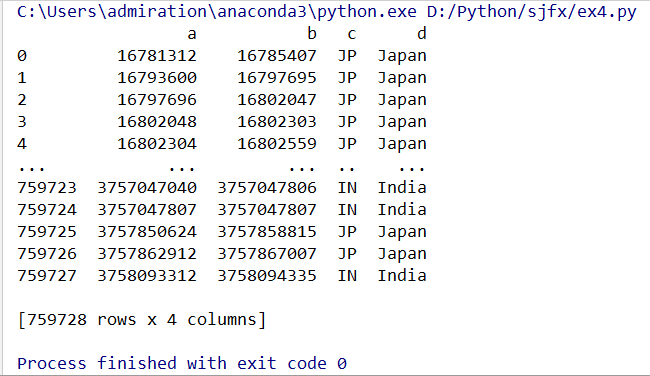
获取指定的连续几列
cols_data_4 = df.loc[:,'a':'d']  # 指定连续列,用列名

cols_data_5 = df.iloc[:,0:4]    # 指定连续列,用数字
5、取指定行和列
import pandas as pd

df = pd.read_csv('./IP2LOCATION.csv',encoding= 'utf-8',header=None)

# print(type(df))

df.columns = ['a','b','c','d','e','f']

# 获取指定行列

# 第一种,列索引用数字表示

# data_1 = df.iloc[[1,3],[0]]

# data_2 = df.iloc[[1,3],0]

# data_3 = df.iloc[[1,3],1:3]

# data_4 = df.iloc[[1,3],[1,3]]

# print(data_4)

# 第二种,列索引直接引用列名

# data_5 = df.loc[1,['a','d']]

# data_6 = df.loc[[1],['a','d']]

# data_7 = df.loc[[1,3],'a':'d']

# data_8 = df.loc[[1,3],['a','d']]

# print(data_8)
列索引用数字表示
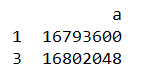
第一种情况是列索引用数字表示, df.iloc[行索引表达,列索引表达],规则跟上面行索引一模一样。
data_1 = df.iloc[[1,3],[0]]
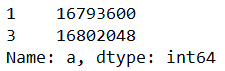
data_2 = df.iloc[[1,3],0] # series
data_3 = df.iloc[[1,3],1:3]
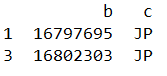
data_4 = df.iloc[[1,3],[1,3]]
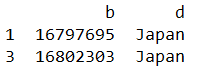
列索引直接引列名
第二种情况是列索引直接引列名(行索引不存在这个问题,因为pandas没有所谓'行名'),就要用df.loc[行索引,列名索引。
data_5 = df.loc[1,['a','d']] # series
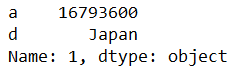
data_6 = df.loc[[1],['a','d']]
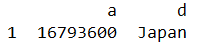
data_7 = df.loc[[1,3],'a':'d']
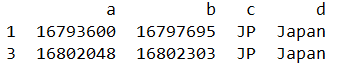
data_8 = df.loc[[1,3],['a','d']]

使用pandas库实现csv行和列的获取的更多相关文章
- POI教程之第二讲:创建一个时间格式的单元格,处理不同内容格式的单元格,遍历工作簿的行和列并获取单元格内容,文本提取
第二讲 1.创建一个时间格式的单元格 Workbook wb=new HSSFWorkbook(); // 定义一个新的工作簿 Sheet sheet=wb.createSheet("第一个 ...
- python的pandas库读取csv
首先建立test.csv原始数据,内容如下 时间,地点 一月,北京 二月,上海 三月,广东 四月,深圳 五月,河南 六月,郑州 七月,新密 八月,大连 九月,盘锦 十月,沈阳 十一月,武汉 十二月,南 ...
- 用pandas库对csv文件中的文本数据进行分析处理
#数据分析 import pandas import csv old_path = r'd:\2000W\200W-400W.csv' f = open(old_path,'r',encoding=' ...
- Python之文件读写(csv文件,CSV库,Pandas库)
前言 一.Python文件读取 二.读取CSV文件 一.Python文件读取 1. open函数是内置函数之with操作 - 关于路径设置的问题斜杠设置成D:\\文件夹\\文件或是D:/文件夹/文件 ...
- Python之使用Pandas库实现MySQL数据库的读写
本次分享将介绍如何在Python中使用Pandas库实现MySQL数据库的读写.首先我们需要了解点ORM方面的知识. ORM技术 对象关系映射技术,即ORM(Object-Relational ...
- python做数据分析pandas库介绍之DataFrame基本操作
怎样删除list中空字符? 最简单的方法:new_list = [ x for x in li if x != '' ] 这一部分主要学习pandas中基于前面两种数据结构的基本操作. 设有DataF ...
- Pandas库常用函数和操作
1. DataFrame 处理缺失值 dropna() df2.dropna(axis=0, how='any', subset=[u'ToC'], inplace=True) 把在ToC列有缺失值 ...
- python pandas库——pivot使用心得
python pandas库——pivot使用心得 2017年12月14日 17:07:06 阅读数:364 最近在做基于python的数据分析工作,引用第三方数据分析库——pandas(versio ...
- 建议42:使用pandas处理大型CSV文件
# -*- coding:utf-8 -*- ''' CSV 常用API 1)reader(csvfile[, dialect='excel'][, fmtparam]),主要用于CSV 文件的读取, ...
随机推荐
- mysql错误代码对照表较完整
mysql错误代码对照表较完整 mysql_errno() From: http://blog.csdn.net/aidenliu/article/details/5925604 mysql错误代码对 ...
- 创建线程的方式三:实现Callable接口-----JDK5.0 新增
package com.yhqtv.java2; /* * 创建线程的方式三:实现Callable接口-----JDK5.0 新增 * * 如何理解实现Callable接口的方式创建多线程比实现Run ...
- c语言解一元二次方程
C语言解一元二次方程,输入系数a,b,c; #include <stdio.h> #include <math.h> int main(int argc, char *argv ...
- OC的消息机制简单介绍
在OC的消息机制中主要分为三个阶段,分别为: 1.消息发送阶段:从类以及父类的方法缓存列表和方法列表查找方法. 2.动态解析阶段:在消息发送阶段没有找到方法,则会进入这个阶段,负责动态添加方法实现. ...
- 二、Vue基础语法
六:Vue的v-bind指令作用:绑定标签上的所有属性其简写 ":" 6.1: 例如:<p v-bind:id="test">Hello wo ...
- web前端开发中的各种居中
居中是我们使用css来布局时常遇到的情况.使用css来进行居中时,有时一个属性就能搞定,有时则需要一定的技巧才能兼容到所有浏览器,本文就居中的一些常用方法做个简单的介绍. 注:本文所讲方法除了特别说明 ...
- Spring IOC 之注册解析的 BeanDefinition
2019独角兽企业重金招聘Python工程师标准>>> DefaultBeanDefinitionDocumentReader.processBeanDefinition() 完成 ...
- BeanDefinition源码解析
我们知道BeanDefintion定义了Bean在IoC容器内的基本数据结构.在学习IoC之前先了解BeanDefition对我们理解IoC容器是有帮助的. 首先BeanDefinition是一个接口 ...
- CF思维联系– Codeforces-988C Equal Sums (哈希)
ACM思维题训练集合 You are given k sequences of integers. The length of the i-th sequence equals to ni. You ...
- python(For 循环语句)
一.For循环 Python for 循环可以遍历任何序列的项目,如一个列表或者一个字符串或者字典等. 语法模式:for var in sequence: (1)从某个集合(列表等)里顺次取值 #遍历 ...