
Flink集群模式部署及案例执行
一.软件要求
Flink在所有类UNIX的环境【例如linux,mac os x和cygwin】上运行,并期望集群由一个 主节点和一个或多个工作节点组成。在开始设置系统之前,确保在每个节点上都安装了一下软件:
1.Java1.8.x或更高版本
2.ssh,必须运行sshd才能使用管理远程组件的Flink脚本
在所有集群节点上都具有免密码的ssh和相同的目录结构,将使你可以使用flink脚本来控制所有内容。
二.Flink Standalone模式设置
1.下载
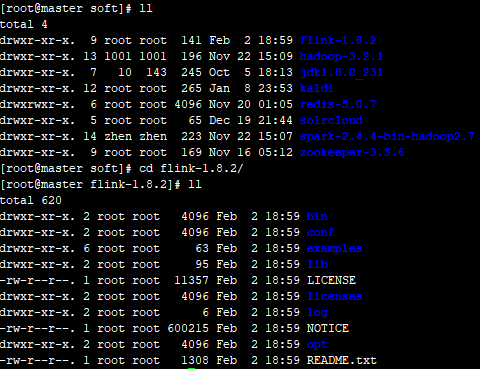
前往Flink官网下载最新版Flink【我下载的是flink-1.8.2】。若要在Hadoop上使用Flink,则需要下载与Hadoop匹配的版本。下载完成后,上传到几个各个节点并解压
2.配置Flink
通过编辑conf/flink-conf.yaml来为集群配置flink。设置jobmanager.rpc.address以指定flink主节点。还可以通过设置jobmanager.heap.size和taskmanager.heap.size来指定允许JVM在每个节点上分配的最大内存。这些值都是以MB为单位,如果某些工作程序节点有更多的内存分配给Flink集群,则可以通过FLINK_TM_HEAP在那些特定节点上设置环境变量来覆盖默认值。最后,必须提供集群中所有节点的列表,这些列表将用作工作节点。因此,类似于HDFS配置,编辑文件conf/slaves并输入每个子节点的IP/主机名。每个子节点都将运行TaskManager。
以下示例说明了具有三个节点(IP地址从10.0.0.1到10.0.0.3且主机名分别为master,worker1,worker2)的设置,并显示了配置文件的内容:
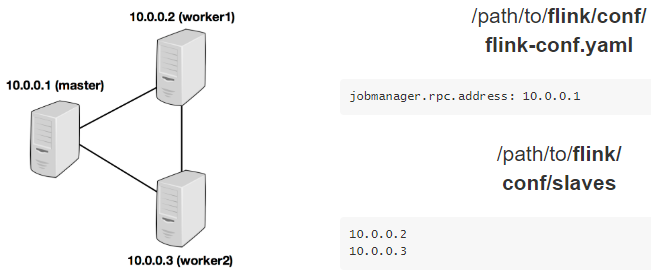
具体配置如下:
jobmanager.rpc.address:192.168.136.7 # 在每个节点上分别指定各自节点的IP/主机名
taskmanager.tmp.dirs: /usr/local/soft/flink-1.8.2/tmp # 指定每个taskmanager的临时目录

jobmanager.rpc.port:

jobmanager.heap.size: 1024m

taskmanager.heap.size: 1024m

taskmanager.numberOfTaskSlots:

parallelism.default:
解释如下:
1.jobmanager.heap.size:每个JobManager的可用内存大小,默认为1024M
2.taskmanager.heap.size:每个TaskManager的可用内存大小,默认为1024M
3.taskmanager.numberOfTaskSlots:每台计算机可用的CPU数,默认为1
4.parallelism.default:集群中的CPU总数之和
5.io.tmp.dirs:临时目录
3.配置slaves

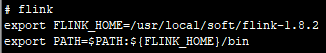
4.配置环境变量
5.启动flink
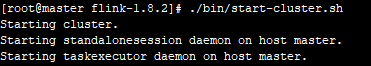
执行bin/start-cluster.sh启动JobManager,并通过SSH连接到slaves文件中列出的所有工作节点,以在每个节点上启动TaskManager。
6.Web UI
打开浏览器,输入:http://master:8081 
配置成功!
三.本地执行WordCount
1.代码
package cn.demo

import org.apache.flink.api.common.operators.Order

import org.apache.flink.api.java.utils.ParameterTool

import org.apache.flink.api.scala._ //必须导入

/**

  * Created by Administrator on 2020/1/22.

  */

object WordCount {

  def main(args: Array[String]) {

    val params : ParameterTool = ParameterTool.fromArgs(args)

    // 设置execution执行环境

    val execution = ExecutionEnvironment.getExecutionEnvironment

    // 设置web界面有效参数

    execution.getConfig.setGlobalJobParameters(params)

    val text = execution.fromElements("Apache Flink is an open source platform for distributed stream and batch data processing.",

      "Flink core is a streaming dataflow engine that provides data distribution, communication, and fault tolerance for distributed computations over data streams. ",

      "Flink builds batch processing on top of the streaming engine, overlaying native iteration support, managed memory, and program optimization.")

    val counts = text.flatMap(_.toLowerCase.split(" ").filter(_.nonEmpty))

      .map((_, 1))

      .groupBy(0)//根据第一个元素分组

      .sum(1)

      .sortPartition(0, Order.ASCENDING) //按照分区进行排序

      .first(6)

    counts.print()

  }

}
2.本地执行结果
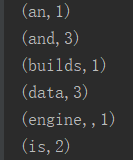
四.案例执行
要运行Flink案例,必须有一个正在运行的Flink实例。最简单的方法是运行./bin/start-cluster.sh,默认情况下会启动一个带有JobManager和一个TaskManager的本地集群。每个Flink二进制发行版都包含一个examples目录,其中包含WordCount这个最常用案例。
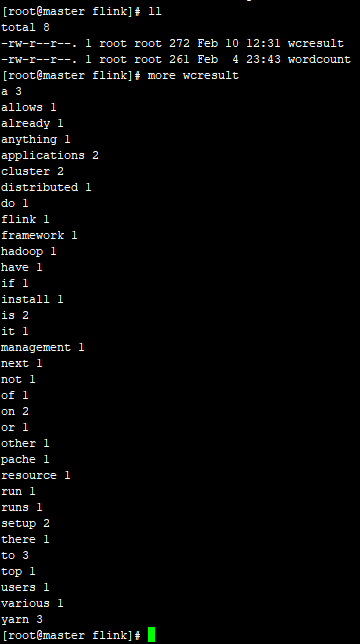
要运行WordCount案例,执行以下命令:
./bin/flink run ./examples/batch/WordCount.jar --input /data/flink/wordcount --output /data/flink/wcresult
备注:input路径要提前创建好,其中保存要计算的数据!

执行结果:
Flink集群模式部署及案例执行的更多相关文章
- 第06讲:Flink 集群安装部署和 HA 配置
Flink系列文章 第01讲:Flink 的应用场景和架构模型 第02讲:Flink 入门程序 WordCount 和 SQL 实现 第03讲:Flink 的编程模型与其他框架比较 第04讲:Flin ...
- Redis集群模式部署
以下以Linux(CentOS)系统为例 1.1 下载和编译 $ wget http://download.redis.io/releases/redis-4.0.7.tar.gz $ tar xzf ...
- zookeeper集群&伪集群模式部署
1.什么是单机部署 一台服务器上面部署一个单机版本的zookeeper服务,用于提供服务. 2.什么是集群部署? 集群部署就是多台服务器上面各部署单独的一个zookeeper服务,然后组建一个集群 3 ...
- flink集群模式安装配置
一.手动下载安装包 wget http://mirrors.tuna.tsinghua.edu.cn/apache/flink/flink-1.6.1/flink-1.6.1-bin-hadoop27 ...
- Kafka集群模式部署
环境:kafka 0.8.1.1 基本概念 Kafka维护按类区分的消息,称为主题(topic) 生产者(producer)向kafka的主题发布消息 消费者(consumer)向主题注册,并且接收发 ...
- ELK集群模式部署
架构拓扑图为: 准备工作: 下载资源包: Elasticsearch: wget https://artifacts.elastic.co/downloads/elasticsearch/elasti ...
- bigdata_ Kafka集群模式部署
环境:kafka 0.8.1.1 基本概念 Kafka维护按类区分的消息,称为主题(topic) 生产者(producer)向kafka的主题发布消息 消费者(consumer)向主题注册,并且接收发 ...
- flink部署操作-flink standalone集群安装部署
flink集群安装部署 standalone集群模式 必须依赖 必须的软件 JAVA_HOME配置 flink安装 配置flink 启动flink 添加Jobmanager/taskmanager 实 ...
- Solr系列二:solr-部署详解(solr两种部署模式介绍、独立服务器模式详解、SolrCloud分布式集群模式详解)
一.solr两种部署模式介绍 Standalone Server 独立服务器模式:适用于数据规模不大的场景 SolrCloud 分布式集群模式:适用于数据规模大,高可靠.高可用.高并发的场景 二.独 ...
随机推荐
- 1-4SpringBoot操作之Spring-Data-Jpa(一)
Spring-Data-Jpa JPA(Java Persistence API)定义了一系列对象持久化的标准, 目前实现这一规范的产品有Hibernate.TopLink等. Spring Data ...
- BugFix系列---开篇介绍
这个系列的文章,主要目的在于积累总结实际开发中遇到的错误,记录下来自己的解决思路,用来提升自己. 不出意外,应该会持续不断的记录更新,在整个开发openstack的过程中,抓住机会吸取开源界大牛的 ...
- 无需重新编译安装PHP扩展的方法
转自:https://www.jianshu.com/p/ae3c17b0f126 PHP扩展模块通常有两种: PHP官方扩展.如果php通过源码安装(php7),安装的时候未开启,而后来需要开启某个 ...
- MQTT 协议学习:000-有关概念入门
背景 从本章开始,在没有特殊说明的情况下,文章中的MQTT版本均为 3.1.1. MQTT 协议是物联网中常见的协议之一,"轻量级物联网消息推送协议",MQTT同HTTP属于第七层 ...
- 通过虚拟机增加Linux的磁盘(分区容量)
因为安装oracle设置的磁盘空间不足,所以安装失败.这里总结一下如何添加磁盘挂载 1. 右键虚拟机点击设置,然后点击磁盘,点击添加按钮 2.然后点击下一步下一步,直到安装成功 3.然后输入 fdis ...
- ERROR 2002 (HY000): Can't connect to local MySQL server through socket '/var/run/mysqld/mysqld.sock'解决
用XAMPP装装好mysql之后,mysql -uroot 连不上,报这个错误: ERROR 2002 (HY000): Can't connect to local MySQL server t ...
- Java连载79-Calendar解析
一. Calendar解析 package com.bjpowernode.java_learning; import java.util.Date; import java.text.ParseEx ...
- leetcode1 twoSum
""" Given an array of integers, return indices of the two numbers such that they add ...
- 初学者的困惑:OOP与一般编程的区别
*在写<程序猿的思维修炼>随笔中,我们大概猜想到了,OOP的思想更趋于模块化,更独立,因此称为一个个对象,本次随笔将对OOP和一般编程的区别有更详细的解释 面向对象编程的含义: 面向对象编 ...
- 一、Vue环境搭建及基础用法
一.项目初始化及安装 官网:https://cn.vuejs.org/ 1.1安装及运行项目步骤 1.安装vue-cli(-g=-global) npm install -g vue-cli cnpm ...