
Spark入门(四)--Spark的map、flatMap、mapToPair
spark的RDD操作
在上一节Spark经典的单词统计中,了解了几个RDD操作,包括flatMap,map,reduceByKey,以及后面简化的方案,countByValue。那么这一节将介绍更多常用的RDD操作,并且为每一种RDD我们分解来看其运作的情况。
spark的flatMap
flatMap,有着一对多的表现,输入一输出多。并且会将每一个输入对应的多个输出整合成一个大的集合,当然不用担心这个集合会超出内存的范围,因为spark会自觉地将过多的内容溢写到磁盘。当然如果对运行的机器的内存有着足够的信心,也可以将内容存储到内存中。
为了更好地理解flatMap,我们将举一个例子来说明。当然和往常一样,会准备好例子对应的数据文本,文本名称为uv.txt,该文本和示例程序可以从github上下载。以下会用三种语言:scala、java、python去描述,同时在java中会对比采用java和java8来实现各个例子。其中java和scala程序在github能直接下载,而python则暂时不提供,后续会补上。
scala实现
import org.apache.spark.{SparkConf, SparkContext}

object SparkFlatMap {

  def main(args: Array[String]): Unit = {

    val conf = new SparkConf().setMaster("local").setAppName("SparkFlatMap")

    val sc = new SparkContext(conf)

    //设置数据路径

    val textData = sc.textFile("./uv.txt")

    //输出处理前总行数

    println("before:"+textData.count()+"行")

    //输出处理前第一行数据

    println("first line:"+textData.first())

    //进行flatMap处理

    val flatData = textData.flatMap(line => line.split(" "))

    //输出处理后总行数

    println("after:"+flatData.count())

    //输出处理后第一行数据

    println("first line:"+flatData.first())

    //将结果保存在flatResultScala文件夹中

    flatData.saveAsTextFile("./flatResultScala")

  }

}

复制代码
java实现
import org.apache.spark.SparkConf;

import org.apache.spark.api.java.JavaRDD;

import org.apache.spark.api.java.JavaSparkContext;

import org.apache.spark.api.java.function.FlatMapFunction;

import java.util.Arrays;

import java.util.Iterator;

public class SparkFlatMapJava {

    public static void main(String[] args){

        SparkConf conf = new SparkConf().setMaster("local").setAppName("SparkFlatMapJava");

        JavaSparkContext sc = new JavaSparkContext(conf);

        //java实现

        flatMapJava(sc);

        //java8实现

        flatMapJava8(sc);

    }

    public static void flatMapJava(JavaSparkContext sc){

        //设置数据路径

        JavaRDD<String> textData = sc.textFile("./uv.txt");

        //输出处理前总行数

        System.out.println("before:"+textData.count()+"行");

        //输出处理前第一行数据

        System.out.println("first line:"+textData.first()+"行");

        //进行flatMap处理

        JavaRDD<String> flatData = textData.flatMap(new FlatMapFunction<String, String>() {

            @Override

            public Iterator<String> call(String s) throws Exception {

                return Arrays.asList(s.split(" ")).iterator();

            }

        });

        //输出处理后总行数

        System.out.println("after:"+flatData.count()+"行");

        //输出处理后第一行数据

        System.out.println("first line:"+flatData.first()+"行");

        //将结果保存在flatResultScala文件夹中

        flatData.saveAsTextFile("./flatResultJava");

    }

    public static void flatMapJava8(JavaSparkContext sc){

        sc.textFile("./uv.txt")

          .flatMap(line -> Arrays.asList(line.split(" ")).iterator())

          .saveAsTextFile("./flatResultJava8");

    }

}

复制代码
python实现
from pyspark import SparkConf,SparkContext

conf = SparkConf().setMaster("local").setAppName("FlatMapPython")

sc = SparkContext(conf=conf)

textData = sc.textFile("./uv.txt")

print("before:"+str(textData.count())+"行")

print("first line"+textData.first())

flatData = textData.flatMap(lambda line:line.split(" "))

print("after:"+str(flatData.count())+"行")

print("first line"+flatData.first())

flatData.saveAsTextFile("./resultFlatMap")

复制代码
运行任意程序,得到相同结果
before:86400行

first line:2015-08-24_00:00:00 55311 buy

after:259200

first line:2015-08-24_00:00:00

复制代码
查看文件
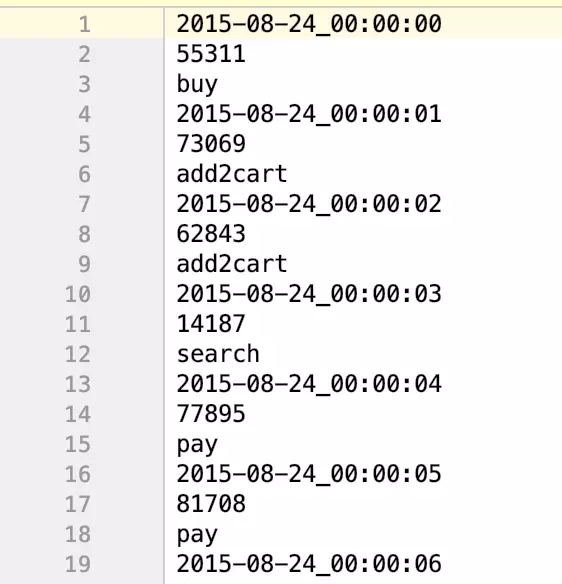
很显然每一行都按照空格拆分成了三行,因此总行数是拆分前的三倍,第一行的内容只剩下原第一行的第一个数据,时间。这样flatMap的作用就很明显了。
spark的map
用同样的方法来展示map操作,与flatMap不同的是,map通常是一对一,即输入一个,对应输出一个。但是输出的结果可以是一个元组,一个元组则可能包含多个数据,但是一个元组是一个整体,因此算是一个元素。这里注意到在输出的结果是元组时,scala和python能够很正常处理,而在java中则有一点不同。
scala实现
import org.apache.spark.{SparkConf, SparkContext}

object SparkMap {

  def main(args: Array[String]): Unit = {

    val conf = new SparkConf().setMaster("local").setAppName("SparkFlatMap")

    val sc = new SparkContext(conf)

    val textData = sc.textFile("./uv.txt")

    //得到一个最后一个操作值,前面的时间和次数舍弃

    val mapData1 = textData.map(line => line.split(" ")(2))

    println(mapData1.count())

    println(mapData1.first())

    mapData1.saveAsTextFile("./resultMapScala")

    //得到一个最后两个值,前面的时间舍弃

    val mapData2 = textData.map(line => (line.split(" ")(1),line.split(" ")(2)))

    println(mapData2.count())

    println(mapData2.first())

    //将所有值存到元组中去

    val mapData3 = textData.map(line => (line.split(" ")(1),line.split(" ")(1),line.split(" ")(2)))

    println(mapData3.count())

    println(mapData3.first())

  }

}

复制代码
java实现
import org.apache.spark.SparkConf;

import org.apache.spark.api.java.JavaRDD;

import org.apache.spark.api.java.JavaSparkContext;

import org.apache.spark.api.java.function.Function;

import org.codehaus.janino.Java;

import scala.Tuple2;

import scala.Tuple3;

public class SparkMapJava {

    public static void main(String[] args){

        SparkConf conf = new SparkConf().setMaster("local").setAppName("SparkFlatMapJava");

        JavaSparkContext sc = new JavaSparkContext(conf);

        //java实现

        mapJava(sc);

        //java8实现

        mapJava8(sc);

    }

    public static void mapJava(JavaSparkContext sc){

        JavaRDD<String> txtData = sc.textFile("./uv.txt");

        //保留最后一个值

        JavaRDD<String> mapData1 = txtData.map(new Function<String, String>() {

            @Override

            public String call(String s) throws Exception {

                return s.split(" ")[2];

            }

        });

        System.out.println(mapData1.count());

        System.out.println(mapData1.first());

        //保留最后两个值

        JavaRDD<Tuple2<String,String>> mapData2 = txtData.map(new Function<String, Tuple2<String,String>>() {

            @Override

            public Tuple2<String,String> call(String s) throws Exception {

                return new Tuple2<>(s.split(" ")[1],s.split(" ")[2]);

            }

        });

        System.out.println(mapData2.count());

        System.out.println(mapData2.first());

        //保留最后三个值

        JavaRDD<Tuple3<String,String,String>> mapData3 = txtData.map(new Function<String, Tuple3<String,String,String>>() {

            @Override

            public Tuple3<String,String,String> call(String s) throws Exception {

                return new Tuple3<>(s.split(" ")[0],s.split(" ")[1],s.split(" ")[2]);

            }

        });

        System.out.println(mapData2.count());

        System.out.println(mapData2.first());

    }

    public static void mapJava8(JavaSparkContext sc){

        JavaRDD<String> mapData1 = sc.textFile("./uv.txt").map(line -> line.split(" ")[2]);

        System.out.println(mapData1.count());

        System.out.println(mapData1.first());

        JavaRDD<Tuple2<String,String>> mapData2 = sc.textFile("./uv.txt").map(line -> new Tuple2<String, String>(line.split(" ")[1],line.split(" ")[2]));

        System.out.println(mapData2.count());

        System.out.println(mapData2.first());

        JavaRDD<Tuple3<String,String,String>> mapData3 = sc.textFile("./uv.txt").map(line -> new Tuple3<String, String, String>(line.split(" ")[0],line.split(" ")[1],line.split(" ")[2]));

        System.out.println(mapData3.count());

        System.out.println(mapData3.first());

    }

}

复制代码
python实现
from pyspark import SparkConf,SparkContext

conf = SparkConf().setMaster("local").setAppName("FlatMapPython")

sc = SparkContext(conf=conf)

textData = sc.textFile("./uv.txt")

mapData1 = textData.map(lambda line : line.split(" ")[2])

print(mapData1.count())

print(mapData1.first())

mapData2 = textData.map(lambda line : (line.split(" ")[1],line.split(" ")[2]))

print(mapData2.count())

print(mapData2.first())

mapData3 = textData.map(lambda line : (line.split(" ")[0],line.split(" ")[1],line.split(" ")[2]))

print(mapData3.count())

print(mapData3.first())

复制代码
运行任意程序,得到相同结果
86400

buy

86400

(55311,buy)

86400

(55311,55311,buy)

复制代码
Java中独有的mapToPair
import org.apache.spark.SparkConf;

import org.apache.spark.api.java.JavaPairRDD;

import org.apache.spark.api.java.JavaSparkContext;

import org.apache.spark.api.java.function.PairFunction;

import scala.Tuple2;

public class SparkMapToPair {

    public static void main(String[] args){

        SparkConf conf = new SparkConf().setMaster("local").setAppName("SparkFlatMapJava");

        JavaSparkContext sc = new JavaSparkContext(conf);

        mapToPairJava(sc);

        mapToPairJava8(sc);

    }

    public static void mapToPairJava(JavaSparkContext sc){

        JavaPairRDD<String,String> pairRDD = sc.textFile("./uv.txt").mapToPair(new PairFunction<String, String, String>() {

            @Override

            public Tuple2<String, String> call(String s) throws Exception {

                return new Tuple2<>(s.split(" ")[1],s.split(" ")[2]);

            }

        });

        System.out.println(pairRDD.count());

        System.out.println(pairRDD.first());

    }

    public static void mapToPairJava8(JavaSparkContext sc){

        JavaPairRDD<String,String> pairRDD = sc.textFile("./uv.txt").mapToPair(line -> new Tuple2<>(line.split(" ")[1],line.split(" ")[2]));

        System.out.println(pairRDD.count());

        System.out.println(pairRDD.first());

    }

}

复制代码
运行得到结果
86400

(55311,buy)

复制代码显然我们发现这个结果,和用map处理保留后两个的结果是一致的。灵活使用map、flatMap、mapToPair将非常重要,后面还将有运用多种操作去处理复杂的数据。以上所有程序的代码都能够在GitHub上下载
转自:https://juejin.im/post/5c77e383f265da2d8f474e29
Spark入门(四)--Spark的map、flatMap、mapToPair的更多相关文章
- 一、spark入门之spark shell:wordcount
1.安装完spark,进入spark中bin目录: bin/spark-shell scala> val textFile = sc.textFile("/Users/admin/ ...
- 二、spark入门之spark shell:文本中发现5个最常用的word
scala> val textFile = sc.textFile("/Users/admin/spark-1.5.1-bin-hadoop2.4/README.md") s ...
- Spark入门:Spark运行架构(Python版)
此文为个人学习笔记如需系统学习请访问http://dblab.xmu.edu.cn/blog/1709-2/ 基本概念 * RDD:是弹性分布式数据集(Resilient Distributed ...
- Spark 学习笔记之 map/flatMap/filter/mapPartitions/mapPartitionsWithIndex/sample
map/flatMap/filter/mapPartitions/mapPartitionsWithIndex/sample:
- Spark 入门
Spark 入门 目录 一. 1. 2. 3. 二. 三. 1. 2. 3. (1) (2) (3) 4. 5. 四. 1. 2. 3. 4. 5. 五. Spark Shell使用 ...
- Spark入门实战系列--1.Spark及其生态圈简介
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .简介 1.1 Spark简介 年6月进入Apache成为孵化项目,8个月后成为Apache ...
- Spark入门实战系列--2.Spark编译与部署(下)--Spark编译安装
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .编译Spark .时间不一样,SBT是白天编译,Maven是深夜进行的,获取依赖包速度不同 ...
- Spark入门实战系列--3.Spark编程模型(上)--编程模型及SparkShell实战
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .Spark编程模型 1.1 术语定义 l应用程序(Application): 基于Spar ...
- Spark入门实战系列--6.SparkSQL(上)--SparkSQL简介
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .SparkSQL的发展历程 1.1 Hive and Shark SparkSQL的前身是 ...
- spark 入门学习 核心api
spark入门教程(3)--Spark 核心API开发 原创 2016年04月13日 20:52:28 标签: spark / 分布式 / 大数据 / 教程 / 应用 4999 本教程源于2016年3 ...
随机推荐
- Python自动化之数据驱动(转载下自己的日常练习笔记)
一.execl数据驱动 1.xlutils简要说明 导包:pip3 install xlutils 注意⚠️:xlutils在介些Execl文件的时候,只识别.xls后缀的文件,如果是.xlsx后缀的 ...
- com.spotify:docker-maven-plugin 报localhost:2375 Connection refused 错误
当用maven build项目时出现了如下错误: Failed to execute goal com.spotify:docker-maven-plugin:0.4.13:build (defaul ...
- java 字符串转日期格式
/** * 字符串转日期格式 * */ public static Date date(String date_str) { try { Calendar zcal = Calendar.getIns ...
- Leetcode回溯相关题目Python实现
1.46题,全排列 https://leetcode-cn.com/problems/permutations/ class Solution(object): def permute(self, n ...
- DEBUG -- CLOSE BY CLIENT STACK TRACE问题的两种解决方案,整理自网络
1.DEBUG -- CLOSE BY CLIENT STACK TRACE 最近用c3p0遇到各种奇怪的问题,也不知道是它不行还是我不行. 今天又遇到了一个"DEBUG -- CLOSE ...
- 谈谈Vue的递归组件
2月最后一天,而且还四年一遇,然而本月居然一篇博客没写,有点说不过去.所以,今天就来谈谈Vue的递归组件.我们先来看一个例子: See the Pen 递归组件 by imgss (@imgss) o ...
- Spring源码阅读笔记03:xml配置读取
前面的文章介绍了IOC的概念,Spring提供的bean容器即是对这一思想的具体实现,在接下来的几篇文章会侧重于探究这一bean容器是如何实现的.在此之前,先用一段话概括一下bean容器的基本工作原理 ...
- Linux - 修改系统的max open files、max user processes(附ulimit的使用方法)【转载】
Linux - 修改系统的max open files.max user processes(附ulimit的使用方法)目录 1 问题说明2 修改max open files3 修改max user ...
- 54-with管理文件操作上下文
目录 with管理文件操作上下文 with管理文件操作上下文 之前我们使用open()方法操作文件,但是open打开文件后我们还需要手动释放文件对操作系统的占用.其实我们可以更方便的打开文件,即Pyt ...
- 【俗话说】换个角度理解TCP的三次握手和四次挥手
PS:通俗一点的解释都会在引用块中 Nothing is true, Everything is permitted. 0. 什么是TCP TCP,全称Transmission Control Pro ...