
Hadoop伪分布式HDFS环境搭建和使用
1.环境要求
Java版本不低于Hadoop要求,并配置环境变量
2.安装
1)在网站hadoop.apache.org下载稳定版本的Hadoop包
2)解压压缩包
检查Hadoop是否可用
hadoop/bin/hadoop version
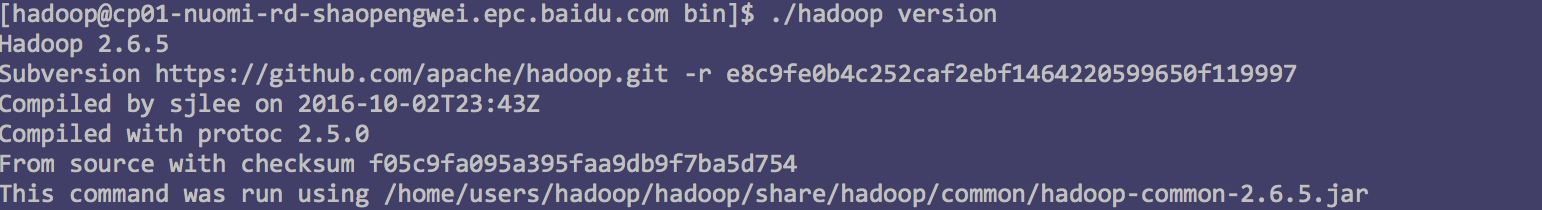
3)修改配置文件
Hadoop配置以.xml文件形式存在
修改文件hadoop/etc/hadoop/core-site.xml:
<configuration>

        <property>

                <name>hadoop.tmp.dir</name>

                <value>/home/users/hadoop/hadoop/tmp</value>

        </property>

        <property>

                <name>fs.default.name</name>

                <value>hdfs://localhost:9000</value>

        </property>

</configuration>
修改文件hadoop/etc/hadoop/hdfs-site.xml:
<configuration>

        <property>

                <name>dfs.datanode.data.dir</name>

                <value>/home/users/hadoop/hadoop/data</value>

        </property>

        <property>

                <name>dfs.namenode.name.dir</name>

                <value>/home/users/hadoop/hadoop/name</value>

        </property>

        <property>

                <name>dfs.http.address</name>

                <value>0.0.0.0:8100</value>

        </property>

        <property>

                <name>dfs.replication</name>

                <value>1</value>

        </property>

</configuration>
4)namenode格式化
hadoop/bin/hdfs namenode -format
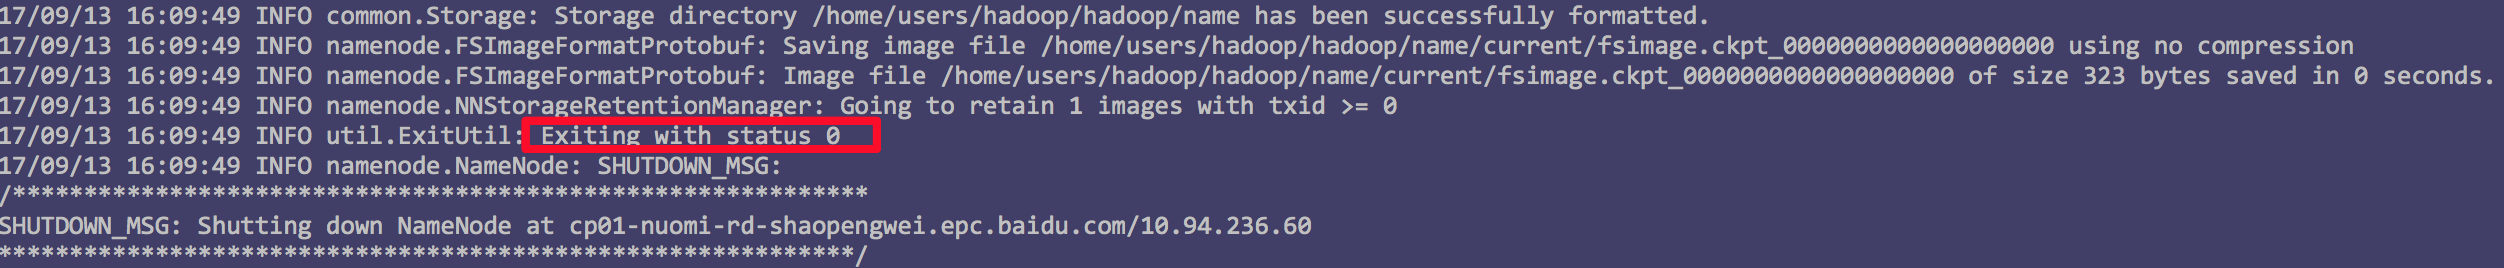
格式化成功如上图所示。
5)开启Namenode和Datanode
hadoop/sbin/start-dfs.sh
执行成功后,输入如下命令查看开启状态
jps
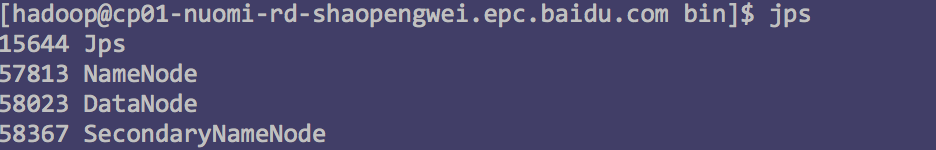
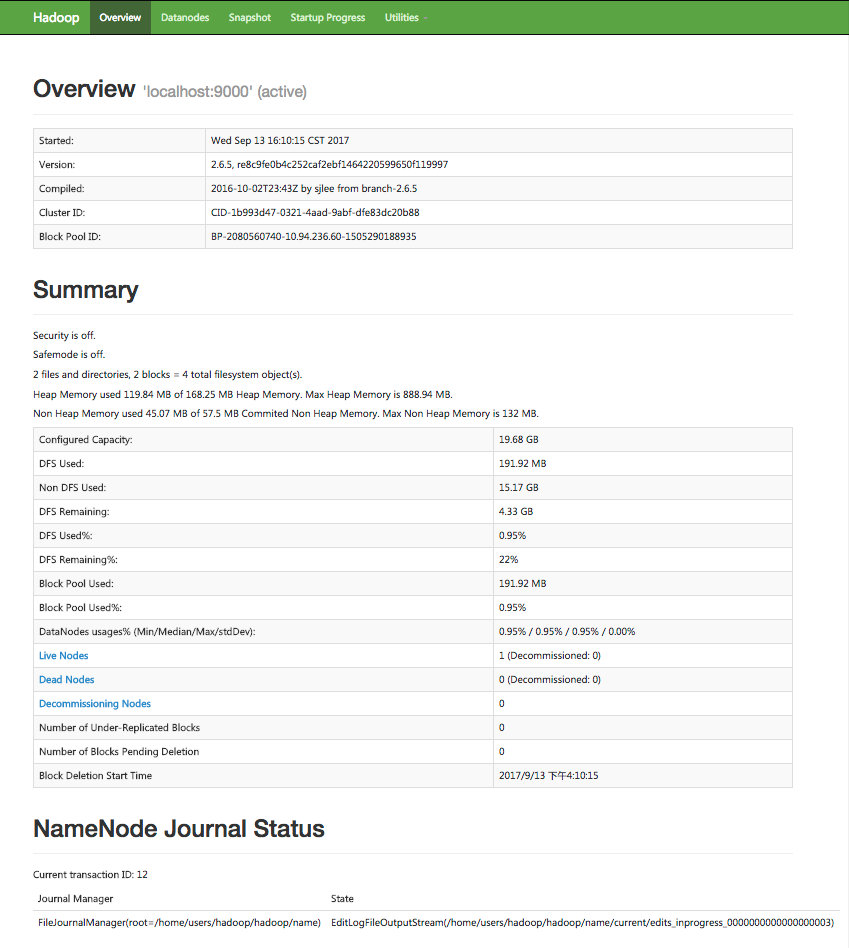
6)web页面查看hdfs服务状况
http://hostname:8100 //8100对应hdfs-site.xml配置文件中的dfs.http.address端口号
7)安装过程中遇到的问题
<1>namenode格式化的时候遇到JAVA_HOME环境变量问题
解决办法:hadoop/etc/hadoop/hadoop-env.xml文件中有变量的设置,但是不能满足要求,还要修改一下hadoop/libexec/hadoop-config.sh文件中大概160行,新增:
export JAVA_HOME=/home/tools/tools/java/jdk1.6.0_20
<2>datanode无法启动
出现该问题的原因:在第一次格式化dfs后,启动并使用了hadoop,后来又重新执行了格式化命令(hdfs namenode -format),这时namenode的clusterID会重新生成,而datanode的clusterID 保持不变。
解决办法:将hadoop/name/current下的VERSION中的clusterID复制到hadoop/data/current下的VERSION中,覆盖掉原来的clusterID,让两个保持一致然后重启,启动后执行jps,查看进程
3.HDFS的使用
HDFS的命令执行格式:hadoop fs -cmd,其中cmd是类shell的命令
hadoop fs -ls / //查看hdfs根目录的文件树
hadoop fs -mkdir /test //创建test文件夹
hadoop fs -cp 文件 文件 //拷贝文件
注:以上命令可以通过添加环境变量来简化
Hadoop伪分布式HDFS环境搭建和使用的更多相关文章
- Win7下单机版的伪分布式solrCloud环境搭建Tomcat+solr+zookeeper【转】
Win7下单机版的伪分布式solrCloud环境搭建Tomcat+solr+zookeeper 1.软件工具箱 在本文的实践中,需要用到以下的软件: Tomcat-7.0.62+solr-5.0.0+ ...
- Hadoop-01 搭建hadoop伪分布式运行环境
Linux中配置Hadoop运行环境 程序清单 VMware Workstation 11.0.0 build-2305329 centos6.5 64bit jdk-7u80-linux-x64.r ...
- hadoop伪分布式集群搭建与安装(ubuntu系统)
1:Vmware虚拟软件里面安装好Ubuntu操作系统之后使用ifconfig命令查看一下ip; 2:使用Xsheel软件远程链接自己的虚拟机,方便操作.输入自己ubuntu操作系统的账号密码之后就链 ...
- Hadoop2.0伪分布式平台环境搭建
一.搭建环境的前提条件 环境:ubuntu-16.04 hadoop-2.6.0 jdk1.8.0_161.这里的环境不一定需要和我一样,基本版本差不多都ok的,所需安装包和压缩包自行下载即可. 因 ...
- 基于Hadoop伪分布式集群搭建Spark
一.前置安装 1)JDK 2)Hadoop伪分布式集群 二.Scala安装 1)解压Scala安装包 2)环境变量 SCALA_HOME = C:\ProgramData\scala-2.10.6 P ...
- Hadoop学习笔记(一):ubuntu虚拟机下的hadoop伪分布式集群搭建
hadoop百度百科:https://baike.baidu.com/item/Hadoop/3526507?fr=aladdin hadoop官网:http://hadoop.apache.org/ ...
- hadoop_spark伪分布式实验环境搭建和运行实例详细教程
hadoop+spark伪分布式环境搭建 安装须知 单机模式(standalone): 该模式是Hadoop的默认模式.这种模式在一台单机上运行,没有分布式文件系统,而是直接读写本地操作系统的文件系统 ...
- hadoop2.5.2学习及实践笔记(一)—— 伪分布式学习环境搭建
软件 工具:vmware 10 系统:centOS 6.5 64位 Apache Hadoop: 2.5.2 64位 Jdk: 1.7.0_75 64位 安装规划 /opt/softwares ...
- Hadoop伪分布式集群搭建
声明:作者原创,转载注明出处. 作者:帅气陈吃苹果 1.下载Hadoop压缩包 wget http://mirrors.hust.edu.cn/apache/hadoop/common/hadoop- ...
随机推荐
- C语言-数组的深入学习
深入学习一下数组1.从内存角度来讲:数组变量就是一次分配多个变量,而且这些变量的地址是连续的,也就是存放这些变量的存储单元是依次相连接的.而且这多个变量必须单独访问,不可以一起访问的.因为他们的地址彼 ...
- 小结spring给项目开发的好处
1.spring 抽象了许多开发中遇到的共性问题:支持pojo和javaBean开发使应用面向接口开发.如各种Template 2.Ioc 容器使得对象间的耦合关系文本化.外部化,即通过xml的配置就 ...
- 装饰器参数加log
#有多个函数,需要计算他们的执行时间,加logimport timedef logger(flag): def show_time(f): #foo对象 def inner(*x,**y): star ...
- 生产事故(MongoDB数据分布不均解决方案)
可以很明显可以看到我们这个集合的数据严重分布不均匀. 一共有8个分片,面对这个情况我首先想到的是手动拆分数据块,但这不是解决此问题的根本办法. 造成此次生产事故的首要原因就是片键选择上的问题,由于片键 ...
- 第1章 分布式系统概念与ZooKeeper简介
ZooKeeper分布式专题与Dubbo微服务入门 第1章 分布式系统概念与ZooKeeper简介 1-1 zookeeper简介 1-2 什么是分布式系统 略 1-3 分布式系统的瓶颈以及zk的相关 ...
- Go-简介-发展
01-Go语言介绍 目录 Go语言介绍 Go语言特性 Go语言发展(版本/特性) Go语言应用 谁在用 应用领域 Go语言项目 Go语架构 Go语言发展前景 Go语言介绍 Go 即Golang,是Go ...
- ant design for vue 解决 vue.esm.js?c5de:628 [Vue warn]: Invalid prop: custom validator check failed for prop "defaultValue". 的错误
错误重现: 在使用ant design for vue 的选择器插件的时候, 设置默认为为id(为数字) 报错: 解决办法: id为数字, 而defaultValue 的key 值必须为字符串, 将i ...
- Python(os和sys)使用
Python(os和sys)理解 os模块负责程序与操作系统的交互,提供了访问操作系统底层的接口; sys模块负责程序与python解释器的交互,提供了一系列的函数和变量,用于操控python的运行时 ...
- FullPage.js中文帮助文档API
fullPage.js的方法: 1. moveSectionUp() 功能:向上滚动一页. 2. moveSectionDown() 功能:向下滚动一页. 3. moveTo(section, sli ...
- 吴裕雄--天生自然TensorFlow高层封装:使用TFLearn处理MNIST数据集实现LeNet-5模型
# 1. 通过TFLearn的API定义卷机神经网络. import tflearn import tflearn.datasets.mnist as mnist from tflearn.layer ...