
selenium3.7+ python3 添加cookie模拟登陆
一、背景介绍
最近做一个爬虫项目,用selenium调用浏览器去获取渲染后的源码,但是每次登陆都需要手机验证,这真的是头痛啊,这种验证方式不要想着去破解,还是老老实实用手机收验证码去吧!反正我是不知道这种验证方式还能破解!难道就没有其他办法了吗?
有,那就是模拟登陆!这样最起码不用没测试一次就登陆验证一次。
这里要说一下的就是,网上很多关于webdriver 添加cookie的教程,基本百分之80都是有问题的。反正我是找了N多的帖子都没有一个是正确的。
二、 添加cookie方法:driver.add_cookie()
1.add_cookie(cookie_dict)方法里面参数是cookie_dict,说明里面参数是字典类型。
2.add_cookie源码。

从源码中我们可以看出,add_cookie方法接受一个字典,字典中包含name,value,path,domain,secure,expiry,但是这个源码容易误导人,那就是cookie参数没有给全。
网上很多教程给的代码cookie参数是没给够的,根本就跑不起来。
3. add_cookie接收的字典格式。
正确的格式:
cookie = {
    # "domain": ".58.com", #Firefox浏览器不能写domain,如果写了会报错,谷歌需要写否则也是报错,这里就是一个坑。其他浏览器没测试不知道情况。
    'name': name,
    'value': value,
    "expires": "",
    'path': '/',
    'httpOnly': False,
    'HostOnly': False,
    'Secure': False,

}
name:cookie的名称
value:cookie对应的值,动态生成的
domain:服务器域名
expiry:Cookie有效终止日期
path:Path属性定义了Web服务器上哪些路径下的页面可获取服务器设置的Cookie
httpOnly:防脚本攻击
secure:在Cookie中标记该变量,表明只有当浏览器和Web Server之间的通信协议为加密认证协议时
为什么要构造成这样子,其实我们看下浏览器保存的cookie格式就明白了。下图就是谷歌浏览器的cookie 的截图。

三 ,我们举个例子看下是否真的写成功了:
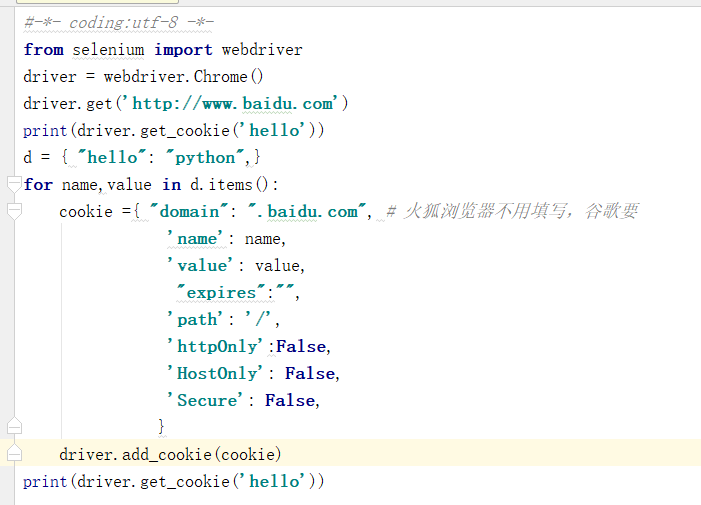
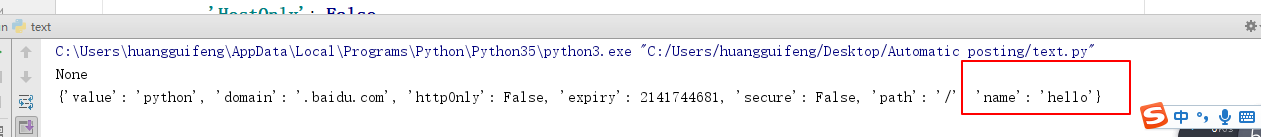
第一次访问的的时候去获取名字叫hello的cookie 是没有的,add_cookie后再去访问,第二次访问就拿到了hello。说明已经写进去了。
四、项目实战。
能不能用?好不好用?怎么用?,用项目来说话,模拟登陆百度。!
目标:
1.手动登录一次后,只要在cookie 有效期内无需重复登录。
2.访问浏览记录。
#!coding=utf-8

import time

from selenium import webdriver

import pickle

class BaiduSpider(object):

    def __init__(self,username,password):

        self.username = username

        self.password = password

        self.driver = webdriver.Chrome()

        self.driver.get(url='http://www.baidu.com')

        self.set_cookie()

        self.is_login()

    def is_login(self):

        '''判断当前是否登陆'''

        self.driver.refresh()

        html = self.driver.page_source

        if html.find(self.username) == -1: #利用用户名判断是否登陆

            # 没登录 ,则手动登录

            self.login()

        else:

            #已经登录  尝试访问搜索记录,可以正常访问

            self.driver.get(url='http://i.baidu.com/my/history')

            time.sleep(30)  # 延时看效果

    def login(self):

        '''登陆'''

        time.sleep(60) #等待手动登录

        self.driver.refresh()

        self.save_cookie()

    def save_cookie(self):

        '''保存cookie'''

        # 将cookie序列化保存下来

        pickle.dump(self.driver.get_cookies(), open("cookies.pkl", "wb"))

    def set_cookie(self):

        '''往浏览器添加cookie'''

        '''利用pickle序列化后的cookie'''

        try:

            cookies = pickle.load(open("cookies.pkl", "rb"))

            for cookie in cookies:

                cookie_dict = {

                    "domain": ".baidu.com",  # 火狐浏览器不用填写,谷歌要需要

                    'name': cookie.get('name'),

                    'value': cookie.get('value'),

                    "expires": "",

                    'path': '/',

                    'httpOnly': False,

                    'HostOnly': False,

                    'Secure': False}

                self.driver.add_cookie(cookie_dict)

        except Exception as e:

            print(e)

if __name__ == '__main__':

    BaiduSpider('usename','!!!!') # 你的百度账号,密码
如果你支持我,就扫扫我的红包,你领我几毛,我领几毛,也算是对我的支持。
selenium3.7+ python3 添加cookie模拟登陆的更多相关文章
- 使用ApiPost测试接口时需要先登录怎么办?利用Cookie模拟登陆!
ApiPost简介: ApiPost是一个支持团队协作,并可直接生成文档的API调试.管理工具.它支持模拟POST.GET.PUT等常见请求,是后台接口开发者或前端.接口测试人员不可多得的工具 . 下 ...
- 添加cookie绕过登陆
添加cookie绕过登陆 #!/usr/bin/env python # -*- coding: utf-8 -*- from selenium import webdriver import tim ...
- katalon系列十五:给浏览器添加cookie自动登陆
import org.openqa.selenium.Cookieimport org.openqa.selenium.WebDriverimport com.kms.katalon.core.web ...
- python3下scrapy爬虫(第六卷:利用cookie模拟登陆抓取个人中心页面)
之前我们爬取的都是那些无需登录就要可以使用的网站但是当我们想爬取自己或他人的个人中心时就需要做登录,一般进入登录页面有两种 ,一个是独立页面登陆,另一个是弹窗,我们先不管验证码登陆的问题 ,现在试一下 ...
- 20170717_python爬虫之requests+cookie模拟登陆
在成功登陆之前,失败了十几次.完全找不到是什么原因导致被网站判断cookie是无效的. 直到用了firefox的httpfox之后才发现cookie里还有一个ASP.NET_SessionId 这个字 ...
- 22.天眼查cookie模拟登陆采集数据
通过账号登录获取cookies,模拟登录(前提有天眼查账号),会员账号可查看5000家,普通只是100家,同时也要设置一定的反爬措施以防账号被封.拿有权限的账号去获取cookies,去访问页面信息,不 ...
- 三种urllib实现网页下载,含cookie模拟登陆
coding=UTF-8 import re import urllib.request, http.cookiejar, urllib.parse # # print('-------------- ...
- php curl 添加cookie伪造登陆抓取数据(摘自网络)
有的网页必须登陆才能看到,这个时候想要抓取信息必须在header里面传递cookie值才能获取 1.首先登陆网站,打开firebug就能看到对应的cookie把这些cookie拷贝出来就能使用了 2. ...
- 爬虫——cookie模拟登陆
cookie适用于抓取需要登录才能访问的页面网站 cookie和session机制 http协议为无连接协议,cookie: 存放在客户端浏览器,session: 存放在Web服务器 人人网登录案例 ...
随机推荐
- 【转】Python装饰器与面向切面编程
原文请参考: http://www.cnblogs.com/huxi/archive/2011/03/01/1967600.html 今天来讨论一下装饰器.装饰器是一个很著名的设计模式,经常被用于有切 ...
- Java面向对象 集合(中)
Java面向对象 集合(中) 知识概要: (1)泛型的体系概念 (2)泛型的特点 (3)自定义泛型类 泛型的体系概念 泛型:JDK1.5版 ...
- Vue阻止冒泡
<!DOCTYPE html><html lang="en"><head> <meta charset="UTF-8" ...
- 使用Travis CI自动部署Hexo到GitHub
原文链接(转载请注明出处):使用Travis CI自动部署Hexo到GitHub 前言 使用 hexo + gitPages 搭建个人博客的人都知道,每当要发表一篇博文,第一步得手动使用 hexo g ...
- 吾八哥学Python(四):了解Python基础语法(下)
咱们接着上篇的语法学习,继续了解学习Python基础语法. 数据类型大体上把Python中的数据类型分为如下几类:Number(数字),String(字符串).List(列表).Dictionary( ...
- Java8 新特性之Stream----java.util.stream
这个包主要提供元素的streams函数操作,比如对collections的map,reduce. 例如: int sum = widgets.stream() .filter(b -> b.ge ...
- Servlet 笔记-异常处理
当一个 Servlet 抛出一个异常时,Web 容器在使用了 exception-type 元素的 web.xml 中搜索与抛出异常类型相匹配的配置. 必须在 web.xml 中使用 error-pa ...
- Windows中 MySQL5.7.17解压版安装步骤
1.先去MySQL官网下载.当前最新版是5.7.19,可能安装方法不同了,本人测试没有安装成功,若有安装成功的朋友,希望分享一下安装步骤. 个人推荐下载MySQL5.7.17,官方下载网址:https ...
- MongoDB正则表达式
MongoDB 使用 $regex 操作符来设置匹配字符串的正则表达式. 1. 搜索包含某关键字的内容: db.posts.find({post_text:{$regex:"w3cschoo ...
- asp.net上传文件限制解决方案
环境:VS2012,IIS7 利用web uploader实现了一个文件上传的功能,但是遇到上传大小的限制,在web.config的<system.web>节点下添加如下代码: <h ...