
Elasticsearch同义词词汇单元过滤器
1 简单扩展
"jump,hop,leap"
搜索jump会检索出包含jump、hop或leap的词
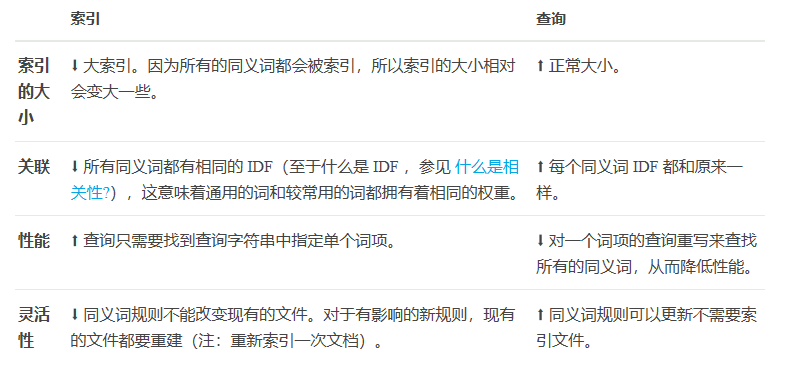
1.1 扩展应用在索引阶段
1.2 扩展应用在查询阶段
1.3 对比
2 简单收缩
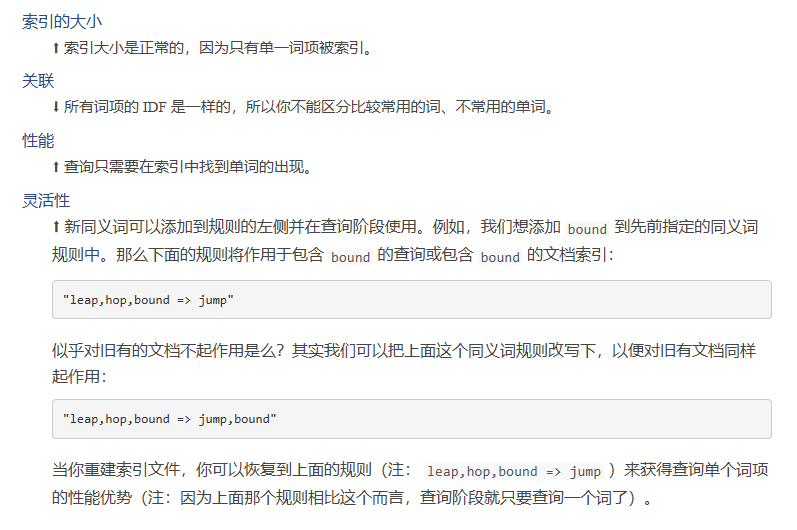
把左边的多个同义词映射到了右边的单个词:
"leap,hop => jump"
必须同时应用于索引和查询阶段,以确保查询词项映射到索引中存在的同一个值。
优缺点:
3 类型扩展
"cat => cat,pet",
"kitten => kitten,cat,pet",
"dog => dog,pet"
"puppy => puppy,dog,pet"
如第一行,所有包含cat的文档ID会被索引到倒排索引cat和pet里面。
注意,右边扩大了左边词的的范围。因此,倘若你在索引和查询阶段都使用类型扩展,当你搜索某个词(如cat)的时候,由于cat的IDF值就是cat本来的IDF值,pet的IDF值会比实际上pet的IDF值偏小,因此,包含cat的文档的分数会比包含pet的文档,因而排在更前面。
4 注意
4.1 PET->pet词义变化
经过lowercase过滤器后,包含PET(正电子发射断层扫描)的文档ID会被索引到倒排索引pet中。
解决方案:
在lowercase过滤器之前,利用使用一层同义词词汇单元过滤器,将特殊的单词转化为特殊的词单元,如:
"CAT,CAT scan => cat_scan"
"PET,PET scan => pet_scan"
"Johnny Little,J Little => johnny_little"
"Johnny Small,J Small => johnny_small"
经过lowercase过滤器之后,在进行一次常规的同义词词汇单元过滤器,如:
"cat => cat,pet"
"dog => dog,pet"
"cat scan,cat_scan scan => cat_scan"
"pet scan,pet_scan scan => pet_scan"
"little,small"
4.2 短语查询
如果同义词中有短语词组,如:
"usa,united states,u s a,united states of america"
一定要在分词之前,使用词义收缩,否则会造成严重不匹配(原因)
"united states,u s a,united states of america=>usa"
这个方法的缺点是,因为把 united states of america 转换成了同义词 usa, 你就不能使用 united states of america 去搜索出 united 或者 states 。 你需要使用一个额外的字段并用另一个解析器链来达到这个目的。
4.3 符号同义词
符号表情能够很好地表示语义。为了在分词过程中损失掉这部分信息。可以通过映射字符过滤器将表情符号转化为一个表示它的特殊同义词。如,
":)=>emoticon_happy"
Elasticsearch同义词词汇单元过滤器的更多相关文章
- Python Elasticsearch api,组合过滤器,term过滤器,正则查询 ,match查询,获取最近一小时的数据
Python Elasticsearch api 描述:ElasticSearch是一个基于Lucene的搜索服务器.它提供了一个分布式多用户能力的全文搜索引擎,基于RESTful web接口.下 ...
- elasticsearch同义词及动态更新
第一种:参考地址:http://dev.paperlesspost.com/setting-up-elasticsearch-synonyms/271.Add a synonyms file.2.Cr ...
- Elasticsearch:使用 IP 过滤器限制连接
文章转载自:https://elasticstack.blog.csdn.net/article/details/107154165
- Elasticsearch自定义分析器
关于分析器 ES中默认使用的是标准分析器(standard analyzer).如果需要对某个字段使用其他分析器,可以在映射中该字段下说明.例如: PUT /my_index { "mapp ...
- ElasticSearch 处理自然语言流程
ES处理人类语言 ElasticSearch提供了很多的语言分析器,这些分析器承担以下四种角色: 文本拆分为单词 The quick brown foxes → [ The, quick, brown ...
- ElasticSearch最全分词器比较及使用方法
介绍:ElasticSearch 是一个基于 Lucene 的搜索服务器.它提供了一个分布式多用户能力的全文搜索引擎,基于 RESTful web 接口.Elasticsearch 是用 Java 开 ...
- elasticsearch索引和映射
目录 1. elasticsearch如何实现搜索 1.1 搜索实例 1.2 es中数据的类型 1.3 倒排索引 1.4 分析与分析器 1.4.1 什么是分析器 1.4.2 内置分析器种类 1.4.3 ...
- Elasticsearch查询优化总结
查询优化 1 从提高查询精确度进行优化: 本部分主要针对全文搜索进行探究. 1.1 倒排索引 1.1.1 什么是倒排索引: 一个倒排索引由文档中所有不重复词的列表构成,对于其中每个词,有一个包含它的文 ...
- Elasticsearch中的分词器比较及使用方法
Elasticsearch 默认分词器和中分分词器之间的比较及使用方法 https://segmentfault.com/a/1190000012553894 介绍:ElasticSearch 是一个 ...
随机推荐
- Jmeter启动错误
错误一 1 apache-jmeter-2.13\bin>jmeter 'findstr' 不是内部或外部命令,也不是可运行的程序 或批处理文件. Not able to find Java e ...
- Spring 上下文操作工具类 ContextUtils
ContextUtils.java package com.java.config; import org.springframework.beans.BeansException; import o ...
- 5分钟带你入门Redis
转载请标明出处: http://blog.csdn.net/forezp/article/details/61471712 本文出自方志朋的博客 1.redis概述 redis是一个开源的,先进的 k ...
- Java - 静态内部类
Java语言允许在类中再定义类,这种在其它类内部定义的类就叫内部类.内部类又分为:常规内部类.局部内部类.匿名内部类和静态嵌套类四种. 1.静态内部类定义 静态内部类,定义在类中,任何方法外,用sta ...
- select值改变
改变select的值,然后执行一个方法.可以用chang: $("#select").change(function(){ //要执行的内容 });
- python实现排序之冒泡排序
冒泡排序:是将一串无需的数字,排列成有序的.通过相邻的两个数作比较,大的往后移,经过反复的比较,最后得出一串有序的数列. 那么用代码该如何实现? 其实这个问题的思路就是判断每相邻的两个数,进行大小比较 ...
- 关于 PHP 程序员技术职业生涯规划
原文地址:http://rango.swoole.com/archives/570 看到很多 PHP 程序员职业规划的文章,都是直接上来就提 Linux.PHP.MySQL.Nginx.Redis.M ...
- 数据结构学习-BST二叉查找树 : 插入、删除、中序遍历、前序遍历、后序遍历、广度遍历、绘图
二叉查找树(Binary Search Tree) 是一种树形的存储数据的结构 如图所示,它具有的特点是: 1.具有一个根节点 2.每个节点可能有0.1.2个分支 3.对于某个节点,他的左分支小于自身 ...
- HTTP 响应时发生错误。这可能是由于服务终结点绑定未使用 HTTP 协议造成的。这还可能是由于服务器中止了 HTTP 请求上下文(可能由于服务关闭)所致。
第一种:无法序列化 DataTable.未设置 DataTable 名称. 第二种: 排除过程如下: 1.用WCF调试状态下的客户端调用ESB的Publish方法调用成功,证明ESB的推送是没有问题的 ...
- 013---Django的分页器
知识预览 分页 Django的分页器(paginator) view from django.shortcuts import render, HttpResponsefrom app01.model ...