
深度学习—BN的理解(二)
神经网络各个操作层的顺序:
1、sigmoid,tanh函数:conv -> bn -> sigmoid -> pooling
2、RELU激活函数:conv -> bn -> relu -> pooling
一般情况下,先激活函数,后pooling。但对于RELU激活函数,二者交换位置无区别。
论文原文里面是“weights -> batchnorm -> activation ->maxpooling-> weights -> batchnorm -> activation -> dropout”。原文认为这样可以利用到激活函数的不同区间(sigmoid的两个饱和区、中间的线性区等)实现不同的非线性效果,在特定的情况下也可能学习到一个恒等变换的batchnorm,一般用这个即可。
为了activation能更有效地使用输入信息,所以一般放在激活函数之前。
tensorflow中关于BN(Batch Normalization)的函数主要有两个,分别是:
- tf.nn.moments
- tf.nn.batch_normalization
- tf.layers.batch_normalization
- tf.contrib.layers.batch_norm
应用中一般使用 tf.layers.batch_normalization 进行归一化操作。因为集成度较高,不需要自己计算相关的均值和方差。
1、tf.nn.moments计算的是哪一部分均值方差?
举例:
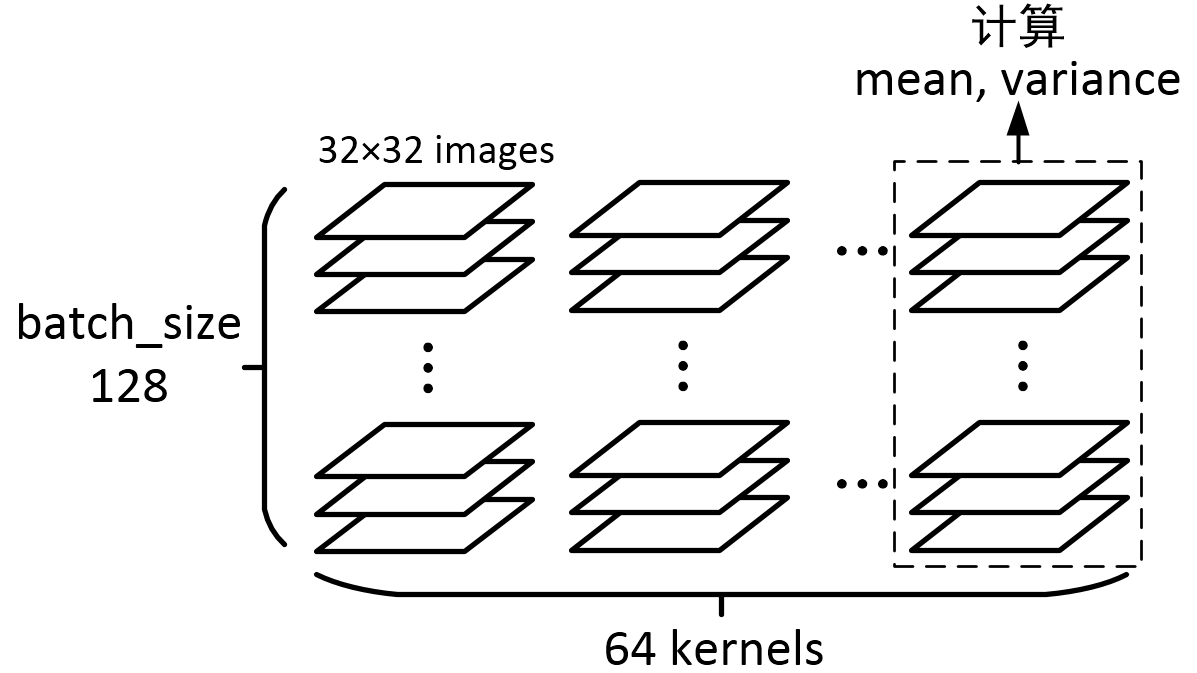
tf.nn.moments(x, axes, name=None, keep_dims=False);其中x是输入,axes表示在哪一维计算,输出为计算的均值和方差。
img = tf.Variable(tf.random_normal([128, 32, 32, 64]))

axis = list(range(len(img.get_shape()) - 1))

mean, variance = tf.nn.moments(img, axis)
一个batch里的128个图,经过一个64 kernels卷积层处理,得到了128×64个图,再针对每一个kernel所对应的128个图,求它们所有像素的mean和variance,因为总共有64个kernels,输出的结果就是一个一维长度64的数组啦!最后输出是(64,)的数组向量。
2、 tf.layers.batch_normalization
在TensorFlow中,如果我们要使用batch normalization层,可以使用的API有tf.layers.batch_normalization和tf.contrib.layers.batch_norm,如果我们直接使用这两个API构建我们的网络,往往会出现训练的时候网络的表现非常好,而当测试的时候我们将其中的参数is_training设置为False时,网络的表现非常的差。这往往是因为我们训练的时候忽视了一个细节。
(1)方法1:
在tf.contrib.layers.batch_norm的帮助文档中我们看到有以下的文字
Note: when training, the moving_mean and moving_variance need to be updated. By default the update ops are placed in tf.GraphKeys.UPDATE_OPS, so they need to be added as a dependency to the train_op.
也就是说,我们需要在代码运行的过程中手动对moving_mean和moving_variance进行手动更新,代码如下:
update_ops = tf.get_collection(tf.GraphKeys.UPDATE_OPS)

with tf.control_dependencies(update_ops):

    train_op = optimizer.minimize(loss)
这一步非常的重要,很多人在训练的时候往往会忽略这一步,导致训练/测试时结果相差巨大。
(2)还有一个方法:需要将is_training改成True。
要注意的地方是,在做测试的时候,如果将is_training改为 False,就会出现测试accuracy很低的现象,需要将is_training改成True。虽然这样能得到高的accuracy,但是明显不合理!!
3、tf.nn.batch_normalization
自己写,用tf.nn.batch_normalization
tensorflow实现:
def batchNorm_layer(inputs, is_training, decay = 1e-5, epsilon = 1e-3):

    scale = tf.Variable(tf.ones(inputs.get_shape()[1:].as_list()))

    beta = tf.Variable(tf.zeros(inputs.get_shape()[1:].as_list()))

    pop_mean = tf.Variable(tf.zeros(inputs.get_shape()[1:].as_list()), trainable=False)

    pop_var = tf.Variable(tf.ones(inputs.get_shape()[1:].as_list()), trainable=False)

    if is_training:

        batch_mean, batch_var = tf.nn.moments(inputs, [0])

        train_mean = tf.assign(pop_mean, pop_mean * decay + batch_mean * (1 - decay))

        train_var = tf.assign(pop_var, pop_var * decay + batch_var * (1 - decay))

        with tf.control_dependencies([train_mean, train_var]):

            return tf.nn.batch_normalization(inputs, batch_mean, batch_var, beta, scale, epsilon)

    else:

        return tf.nn.batch_normalization(inputs, pop_mean, pop_var, beta, scale, epsilon)
参考:https://www.jianshu.com/p/0312e04e4e83
深度学习—BN的理解(二)的更多相关文章
- 深度学习—BN的理解(一)
0.问题 机器学习领域有个很重要的假设:IID独立同分布假设,就是假设训练数据和测试数据是满足相同分布的,这是通过训练数据获得的模型能够在测试集获得好的效果的一个基本保障.那BatchNorm的作用是 ...
- 转载-【深度学习】深入理解Batch Normalization批标准化
全文转载于郭耀华-[深度学习]深入理解Batch Normalization批标准化: 文章链接Batch Normalization: Accelerating Deep Network T ...
- 深度学习课程笔记(二)Classification: Probility Generative Model
深度学习课程笔记(二)Classification: Probility Generative Model 2017.10.05 相关材料来自:http://speech.ee.ntu.edu.tw ...
- 【深度学习】深入理解Batch Normalization批标准化
这几天面试经常被问到BN层的原理,虽然回答上来了,但还是感觉答得不是很好,今天仔细研究了一下Batch Normalization的原理,以下为参考网上几篇文章总结得出. Batch Normaliz ...
- 深度学习入门实战(二)-用TensorFlow训练线性回归
欢迎大家关注腾讯云技术社区-博客园官方主页,我们将持续在博客园为大家推荐技术精品文章哦~ 作者 :董超 上一篇文章我们介绍了 MxNet 的安装,但 MxNet 有个缺点,那就是文档不太全,用起来可能 ...
- 【深度学习】深入理解优化器Optimizer算法(BGD、SGD、MBGD、Momentum、NAG、Adagrad、Adadelta、RMSprop、Adam)
在机器学习.深度学习中使用的优化算法除了常见的梯度下降,还有 Adadelta,Adagrad,RMSProp 等几种优化器,都是什么呢,又该怎么选择呢? 在 Sebastian Ruder 的这篇论 ...
- 【深度学习笔记】(二)基于MNIST数据集的神经网络实验
一.介绍 MNIST(Mixed National Institute of Standards and Technology database)是网上著名的公开数据库之一,是一个入门级的计算机视觉数 ...
- 【深度学习】深入理解ReLU(Rectifie Linear Units)激活函数
论文参考:Deep Sparse Rectifier Neural Networks (很有趣的一篇paper) Part 0:传统激活函数.脑神经元激活频率研究.稀疏激活性 0.1 一般激活函数有 ...
- 深度学习基础(十二)—— ReLU vs PReLU
从算法的命名上来说,PReLU 是对 ReLU 的进一步限制,事实上 PReLU(Parametric Rectified Linear Unit),也即 PReLU 是增加了参数修正的 ReLU. ...
随机推荐
- MSP430G2553电子时钟实验
用msp430g2553控制1602液晶显示时间,并能够通过按键设置时间.我做了正计时和倒计时两种模式 /*********************************************** ...
- 并行编程(2) - sum.msic.Unsafe 二
整理了几个曾经从网上记录sum.msic.Unsafe类的演示样例.供大家參考: package com.fish.unsafe; import java.io.File; import java.i ...
- vue实践---根据不同环境,自动转换请求的url地址
一般的项目环境分为:本地环境,测试环境,预发环境,正式环境. 这些环境的域名一般是一样的, 前端请求接口的url也会随着这些环境的变化而改变,手动修改有点麻烦,所以想个办法,让请求的地址根据域名改变而 ...
- JS中setInterval、setTimeout不能传递带参数的函数的解决办法
在JS中无论是setTimeout还是setInterval,在使用函数名作为调用句柄时都不能带参数,而在许多场合必须要带参数,这就需要想方法解决. 一.采用字符串形式:——(缺陷)参数不能被周期性改 ...
- 虚拟化构建二分图(BZOJ2080 题解+浅谈几道双栈排序思想的题)
虚拟化构建二分图 ------BZOJ2080 题解+浅谈几道双栈排序思想的题 本题的题解在最下面↓↓↓ 不得不说,第一次接触类似于双栈排序的这种题,是在BZOJ的五月月赛上. [BZOJ4881][ ...
- 我的Android进阶之旅------>四种呼叫转移场景
运行商为我们提供了如下4中呼叫转移场景: 1.始终进行呼叫转移:不管当前手机处于何种状态,来电都会被转移到指定的电话号码上.在使用这种呼叫转移时应当非常小心,如果启用了这种呼叫转移,你可就永远也接不着 ...
- Android异步载入全解析之使用AsyncTask
Android异步载入全解析之使用AsyncTask 概述 既然前面提到了多线程,就不得不提到线程池,通过线程池,不仅能够对并发线程进行管理.更能够提高他们运行的效率.优化整个App.当然我们能够自己 ...
- CSS3中transform,transition和animation的简单介绍和使用方法演示样例
transform是一个属性,本质跟width,height是一样的,加上transform也就是为类添加一个变换属性. transition是一个属性.它是用来控制过渡效果的,由于用transfor ...
- JVM相关的几个基本概念
1.虚拟机是指通过软件模拟的具有完整硬件系统功能的.运行在一个完全隔离环境中的完整计算机系统 2.常见的虚拟机有VMWare,Visual Box,JVM等 VMWare或者Visual Box模拟的 ...
- eclipse InvocationTargetException 错误解决
1.今天做一个推送的,用到了几个jar包,直接以User Library的形式加进 在单元测试中,测试的很好,没有任何问题, 但是在action中测试,一测试就崩. 跟踪以后出现InvocationT ...