
Python自然语言处理笔记【一】文本分类之监督式分类
一、分类问题
分类是为了给那些已经给定的输入选择正确的标签。
在基本的分类任务中,每个输入都被认为与其他的输入是隔离的。每个类别的标签集是预先定义好的(只有把类别划分好了,才能给输入划分类别)。
分类任务举例:
- 判断电子是否是垃圾邮件
- 从一个固定的主题领域列表里,比如有‘体育’、‘技术’、‘政治’等,来判断新闻报道的主题
- 判断给定词‘bank’的意思是指河的坡岸、金融机构、还是金融机构里的存储行为
基本分类任务:
- 多样分类:每个实例可以分配多个标签
- 开放性分类:标签集没有事先定义
- 序列分类:输入链表作为整体分类
建立在训练语料(包含了每个输入的正确标签)基础之上的分类,叫做监督式分类。
二、监督式分类
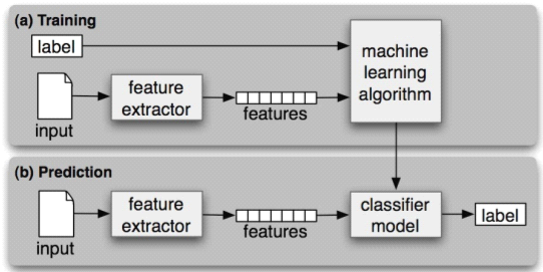
( a )在训练过程(Training)中,特征提取器(feature extractor)用来将每一个输入值(input)转换为特征集(features)。 这些特征集捕捉每个输入中应被用于对其分类的基本信息 。特征 集与标签(label)的配对被送入机器学习算法(machine learning algorithm) ,生成模型(classifier model) 。
( b )在预测过程(Prediction)中 ,相同的特征提取器被用来将未见过的输入转换为特征集。之后,这些特征集被送入模型产生预测标签。
三、分类实例(创建一个分类器)——性别鉴定
step1:决定哪些输入特征是相关的,并为这些特征编码。书中例子是通过判断名字最后一个字母,来推测性别,所以特征就在最后一个字母上。
>>> def gender_features(word):

 ...         return {'last_letter': word[-1]}

>>> gender_features('Shrek')

{'last_letter': 'k'}
step2:利用特征提取器函数建立特征集(字典类型,关于特征名称和它们对应值的映射)
>>> from nltk.corpus import names

>>> import random

>>> names = ([(name, 'male') for name in names.words('male.txt')] +

 ...                     [(name, 'female') for name in names.words('female.txt')])

>>> random.shuffle(names)
step3:用特征提取器处理数据(文中用的是names数据),并把特征集的结果链表,划分为训练集和测试集。(训练集用于训练新的朴素贝叶斯分类器)
>>> featuresets = [(gender_features(n), g) for (n,g) in names]

>>> train_set, test_set = featuresets[500:], featuresets[:500]

>>> classifier = nltk.NaiveBayesClassifier.train(train_set)
step4:测试,检查
#利用大量未见过的数据来评估这个分类器

>>> print nltk.classify.accuracy(classifier, test_set)
#检查分类器,确定哪些特征对于区分名字的性别是最有效的。

>>> classifier.show_most_informative_features(5)
Python自然语言处理笔记【一】文本分类之监督式分类的更多相关文章
- Python自然语言处理笔记【二】文本分类之监督式分类的细节问题
一.选择正确的特征 1.建立分类器的工作中如何选择相关特征,并且为其编码来表示这些特征是首要问题. 2.特征提取,要避免过拟合或者欠拟合 过拟合,是提供的特征太多,使得算法高度依赖训练数据的特性,而对 ...
- Python 自然语言处理笔记(一)
一. NLTK的几个常用函数 1. Concordance 实例如下: >>> text1.concordance("monstrous") Displaying ...
- 《Python自然语言处理》
<Python自然语言处理> 基本信息 作者: (美)Steven Bird Ewan Klein Edward Loper 出版社:人民邮电出版社 ISBN:97871153 ...
- Python 1行代码实现文本分类(实战笔记),含代码详细说明及运行结果
Python 1行代码实现文本分类(实战笔记),含代码详细说明及运行结果 一.详细说明及代码 tc.py =============================================== ...
- python自然语言处理学习笔记1
1.搭建环境 下载anaconda并安装,(其自带python2.7和一些常用包,NumPy,Matplotlib),第一次启动使用spyder 2.下载nltk import nltk nltk.d ...
- Python自然语言处理工具小结
Python自然语言处理工具小结 作者:白宁超 2016年11月21日21:45:26 目录 [Python NLP]干货!详述Python NLTK下如何使用stanford NLP工具包(1) [ ...
- python核心编程--笔记
python核心编程--笔记 的解释器options: 1.1 –d 提供调试输出 1.2 –O 生成优化的字节码(生成.pyo文件) 1.3 –S 不导入site模块以在启动时查找pyt ...
- Python人工智能学习笔记
Python教程 Python 教程 Python 简介 Python 环境搭建 Python 中文编码 Python 基础语法 Python 变量类型 Python 运算符 Python 条件语句 ...
- 转-Python自然语言处理入门
Python自然语言处理入门 原文链接:http://python.jobbole.com/85094/ 分享到:20 本文由 伯乐在线 - Ree Ray 翻译,renlytime 校稿.未经许 ...
随机推荐
- C# WinForm窗体控件Panel修改边框颜色以及边框宽度方法
C# WinForm窗体控件Panel修改边框颜色以及边框宽度方法 1.新建组件这里可以自定义一个Panel控件起名为PanelEx 2.增加一个BoderColor属性和BoderSize属性 pr ...
- 使用PsExec获取shell执行命令
PsExec PsExec是pstools工具组套件的一部分,确成为了渗透利器,下载地址:点击这里下载 连接shell 我的Windows Server 2012默认打开域网络防火墙的时候,是不能连接 ...
- Serv-u FTP迁移(windows_to_windwos)
需求分析 公司服务器要做维护,部分服务器需要进行迁移处理,其中就包括Ser-v FTP服务器. 确认环境信息 角色 ip 系统版本 sql版本 Serv-U版本 ODBC account/passwo ...
- EgretPaper学习笔记一 (安装环境,新建项目)
参考: 官方Egret3D教程 白鹭引擎5.3.0正式发布,支持3D游戏开发 一 下载安装EgretPaper Egret3D 编辑器的开发代号为“Paper”,于2018年9月份开始小规模内测,并在 ...
- 【CF961G】Partitions 第二类斯特林数
[CF961G]Partitions 题意:给出n个物品,每个物品有一个权值$w_i$,定义一个集合$S$的权值为$W(S)=|S|\sum\limits_{x\in S} w_x$,定义一个划分的权 ...
- thymeleaf入门和学习
springboot框架不推荐使用jsp,一方面是兼容性的技术问题,一方面也是其前后端整合在一起,很难适合当下大规模的网站开发环境.HTML只是一种标记语言,并不具有获取model中数据的功能,所以视 ...
- 第四天,通过windows来执行第一个python文件步骤
该看 第 38部分的啦
- 小程序 将图片文字变成一整张图片海报(判断其中字符串宽度可通过计算字符串.length*字符宽度)
//test.xml<canvas bindtap='showhaibao' canvas-id="myCanvas" style="width:{{canvasw ...
- 31、cookie小test
请尽量使用JQuery进行代码编写,需求如下: 1. 页面初始化样式如图 2. 顶部input框中输入内容,按下回车enter键后,“正在进行” 列表中加入该条内容. 3. 顶部input框中输 ...
- POJ 2248 - Addition Chains - [迭代加深DFS]
题目链接:http://bailian.openjudge.cn/practice/2248 题解: 迭代加深DFS. DFS思路:从目前 $x[1 \sim p]$ 中选取两个,作为一个新的值尝试放 ...