
kafka学习2:kafka集群安装与配置
在前一篇:kafka学习1:kafka安装 中,我们安装了单机版的Kafka,而在实际应用中,不可能是单机版的应用,必定是以集群的方式出现。本篇介绍Kafka集群的安装过程:
一、准备工作
1、开通Zookeeper和Kafka需要的端口
在 zookeeper-端口说明 中,我们可以看到Zookeeper需要用到3个端口,我们都需要开放这个端口。Linux开放端口,可以参考:Linux 开启端口命令 这篇文章。
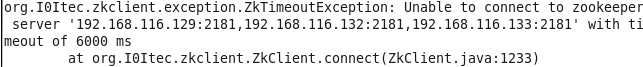
否则在启动的时候,会出现如下错误(连接超时错误):
2、修改主机名称
在搭建Kafka集群时,默认的主机名localhost.localmain不起作用,需要我们设置一个主机名,Linux下设置主机名可以参考:Linux修改主机名称 这篇文章。
二、配置Zookeeper集群
这里用的是Kafka自带的Zookeeper,修改zookeeper.properties。
Zookeeper本身有很多配置,我在这里用到的配置有如下几项:
# the directory where the snapshot is stored.
#存储快照文件snapshot的目录。默认情况下,事务日志也会存储在这里。建议同时配置参数dataLogDir, 事务日志的写性能直接影响zk性能
dataDir=/usr/data/zookeeper_kafka
=================================================
# the port at which the clients will connect
#客户端连接server的端口,即对外服务端口,一般设置为2181吧。
clientPort=2181
================================================
# disable the per-ip limit on the number of connections since this is a non-production config
#单个客户端与单台服务器之间的连接数的限制,是ip级别的,默认是60,如果设置为0,那么表明不作任何限制。请注意这个限制的使用范围,仅仅是单台客户端机器与单#台ZK服务器之间的连接数限制,不是针对指定客户端IP,也不是ZK集群的连接数限制,也不是单台ZK对所有客户端的连接数限制。指定客户端IP的限制策略,这里有一个#patch,可以尝试一下: http://rdc.taobao.com/team/jm/archives/1334(No Java system property)
maxClientCnxns=0
=================================================
#Customer->Server通信心跳数
#ZK中的一个时间单元。ZK中所有时间都是以这个时间单元为基础,进行整数倍配置的。例如,session的最小超时时间是2*tickTime。
tickTime=2000
==================================================
#Leader->Fllower初始通信时限
#Follower在启动过程中,会从Leader同步所有最新数据,然后确定自己能够对外服务的起始状态。Leader允许F在initLimit时间内完成这个工作。通常情况下,我们不用太在意这个参数的设置。如果ZK集群的数据量确实很大了,F在启动的时候,从Leader上同步数据的时间也会相应变长,因此在这种情况下,有必要适当调大这个参数了。(No Java system property)
initLimit=5
==================================================
#Leader->Fllower同步通信时限
#在运行过程中,Leader负责与ZK集群中所有机器进行通信,例如通过一些心跳检测机制,来检测机器的存活状态。如果L发出心跳包在syncLimit之后,还没有从F那里收到响应,那么就认为这个F已经不在线了。注意:不要把这个参数设置得过大,否则可能会掩盖一些问题。(No Java system property)
syncLimit=2
================================================
#zookeeper的集群所有IP,注意数字1、2、3。
server.1=192.168.116.129:2888:3888
server.2=192.168.116.132:2888:3888
server.3=192.168.116.133:2888:3888
我们需要对应的Zookeeper服务器上在dataDir的目录下面新建myid文件,同时把对应的1、2、3写进去。
执行启动zookeeper命令:/bin/zookeeper-server-start.sh config/zookeeper.properties
可以用zookeeper-shell.sh status来查看zookeeper的启动状态。
三、配置Kafka集群
这里修改的是server.properties文件。
#The id of the broker. This must be set to a unique integer for each broker.
#broker.id必须全集群惟一
broker.id=2
#配置kafka的监听地址
listeners=PLAINTEXT://192.168.116.129:9092
port=9092
#配置kafka的集群信息
zookeeper.connect=192.168.116.129:2181,192.168.116.132:2181,192.168.116.133:2181
然后启动Kafka:bin/kafka-server-start.sh config/server.properties
发送kafka消息如下:
bin/kafka-topics.sh --create --zookeeper localhost:2181 --replication-factor 1 --partitions 1 --topic test20171116
再在其他的Kakfa服务器上检查:

可以看到,我们kafka创建的topic消息已经同步到其他的broker上了。
四、参考文档
http://kafka.apache.org/quickstart
http://blog.csdn.net/gongxinju/article/details/53415051
kafka学习2:kafka集群安装与配置的更多相关文章
- Springboot 2.0.x 集成基于Centos7的Redis集群安装及配置
Redis简介 Redis是一个基于C语言开发的开源(BSD许可),开源高性能的高级内存数据结构存储,用作数据库.缓存和消息代理.它支持数据结构,如 字符串.散列.列表.集合,带有范围查询的排序集,位 ...
- ActiveMQ 高可用集群安装、配置(ZooKeeper + LevelDB)
ActiveMQ 高可用集群安装.配置(ZooKeeper + LevelDB) 1.ActiveMQ 集群部署规划: 环境: JDK7 版本:ActiveMQ 5.11.1 ZooKeeper 集群 ...
- MySQL集群安装与配置
MySQL集群安装与配置 文章目录 [隐藏] 一.mysql集群安装 二.节点配置 三.首次启动节点 四.测试服务是否正常 五.安全关闭和重启 MySQL Cluster 是 MySQL 适合于分 ...
- kafka集群安装与配置
一.集群安装 1. Kafka下载: 可以从kafka官方网站(http://kafka.apache.org)上找到下载地址,再wgetwget http://mirrors.cnnic.cn/ap ...
- KafKa集群安装、配置
一.事前准备 1.kafka官网:http://kafka.apache.org/downloads. 2.选择使用版本下载. 3.kafka集群环境准备:(linux) 192.168.145.12 ...
- Hadoop 2.8集群安装及配置记录
第一部分:环境配置(含操作系统.防火墙.SSH.JAVA安装等) Hadoop 2.8集群安装模拟环境为: 主机:Hostname:Hadoop-host,IP:10.10.11.225 节点1:Ho ...
- zookeeper 集群安装与配置
Zookeeper安装和配置 准备工作 安装 JDK,此步略. 下载 zookeeper wget http://archive.apache.org/dist/zookeeper/zookeeper ...
- storm的集群安装与配置
storm集群安装 机器:(storm及zookeeper都是这3台机器) 192.168.80.20 192.168.80.21 192.168.80.22 须要准备的软件有: zookeeper( ...
- hadoop2.7.7 分布式集群安装与配置
环境准备 服务器四台: 系统信息 角色 hostname IP地址 Centos7.4 Mster hadoop-master-001 10.0.15.100 Centos7.4 Slave hado ...
随机推荐
- mybatis学习系列一
1引入dtd约束(6) Mybatis git地址:https://github.com/mybatis/mybatis-3/wiki/Maven 指导手册:http://www.mybatis.or ...
- [20171120]bash使用here documents的一个小细节.txt
[20171120]bash使用here documents的一个小细节.txt --//昨天看bash文档,,发现一些小细节,做一个记录,就是EOF加引号的问题. command <<' ...
- 10 种机器学习算法的要点(附 Python 和 R 代码)
本文由 伯乐在线 - Agatha 翻译,唐尤华 校稿.未经许可,禁止转载!英文出处:SUNIL RAY.欢迎加入翻译组. 前言 谷歌董事长施密特曾说过:虽然谷歌的无人驾驶汽车和机器人受到了许多媒体关 ...
- 2.1Python数据处理篇之---内建有关数学的函数
目录 目录 前言 (一)数学相关得内建函数 (二)具体演示 1.求绝对值 2.创建一个复数 3.求商和余数 4.求x得y次幂 5.生成一个序列 6.四舍五入 7.对一个集合求和 8.求最大值 9.求最 ...
- 【SDOI2009】Bill的挑战
Description Sheng bill不仅有惊人的心算能力,还可以轻松地完成各种统计.在昨天的比赛中,你凭借优秀的程序与他打成了平局,这导致Sheng bill极度的不满.于是他再次挑战你.这次 ...
- mysql之4;
1表之间的关系: 2select查询语句: 1表之间的关系 (1)多对一:(一个表里的多条记录对应另一个表里的一个记录) 建立多对一的关系需要注意1 先建立被关联的表,被关联的字段必须保证是唯一的2 ...
- 使用hint优化Oracle的运行计划 以及 SQL Tune Advisor的使用
背景: 某表忽然出现查询很缓慢的情况.cost 100+ 秒以上:严重影响生产. 原SQL: explain plan for select * from ( select ID id,RET_NO ...
- 【知识碎片】getResource和getResourceAsStream
1. 前言 在Java中获取资源的时候,经常用到getResource和getResourceAsStream,本文总结一下这两种获取资源文件的路径差异. 2.Class.getResource(St ...
- 最长公共子序列(模板 LCSL)
博客: https://www.cnblogs.com/sasuke-/p/5396843.html 模板 #include<iostream>#include<cstdio> ...
- php api 接口
<?php //简单形式 header('Content-Type:text/html;charset=utf-8'); //避免输出乱码 $output = array(); $a = @$_ ...