
hbase1.2.6完全分布式安装
环境,参考之前的两篇博文:
jdk1.7
hadoop2.6.0 完全分布式
一个master,slave1,slave2,slave3
zookeeper3.4.6 完全分布式
安装与配置:(以下步骤都在master上操作,配置好了之后发送到其他的slave上并稍作环境变量配置即可)
到官网去下载hbase1.2.6的安装包,然后解压到/usr/local/目录下,然后用mv命令重命名为hbase
环境变量配置:
/etc/profile

进入hbase的conf目录下,这里边存放的是配置文件,下面做配置:
修改hbase-env.sh文件,找到如下几行,并且改成如图这样:
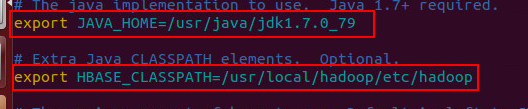
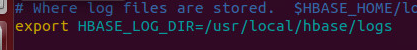
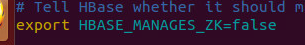
修改hbase-site.xml文件
<property>

<name>hbase.rootdir</name>

<value>hdfs://master:9000/hbase</value>

</property>

<property>

<name>hbase.cluster.distributed</name>

<value>true</value>

</property>

<property>

<name>hbase.zookeeper.property.dataDir</name>

<value>/usr/local/zookeeper</value>

</property>

<property>

<name>hbase.tmp.dir</name>

<value>/usr/local/hbase/tmp</value>

</property>

<property>

<name>hbase.zookeeper.quorum</name>

<value>master,slave1,slave2,slave3</value>

</property>

<property>

<name>hbase.zookeeper.property.clientPort</name>

<value>2181</value>

</property>

<property>

<name>hbase.zookeeper.property.clientPort</name>

<value>2181</value>

</property>
修改regionservers,将文件内容设置为:
master

slave1

slave2

slave3
然后通过scp -r /usr/local/hbase hadoop@slave1:/usr/local/发送到slave1上,slave2、slave3的发送都一样,然后分别在slave上做环境变量配置。
这样就完成了,如果想检测的话,得先启动hadoop的dfs,然后再启动hbase,执行hbase shell命令就能进入hbase数据库了。
hbase1.0以后的webUI访问端口为16010(之前的为60010)
hbase1.2.6完全分布式安装的更多相关文章
- hbase1.2.4 伪分布式安装
注意:在安装hbase或者hadoop的时候,要注意hadoop和hbase的对应关系.如果版本不对应可能造成系统的不稳定和一些其他的问题.在hbase的lib目录下可以看到hadoop对应jar文件 ...
- Hadoop2.7.3+Hbase-1.2.6完全分布式安装部署
因为学习,在网上找了很多hbase搭建的文章,感觉这篇很好,点此 搭建好后,jps查看了后台进程,发现在slave上面没有HRegionServer进程 便查看了 slave上关于HRegionSer ...
- HBase伪分布式安装(HDFS)+ZooKeeper安装+HBase数据操作+HBase架构体系
HBase1.2.2伪分布式安装(HDFS)+ZooKeeper-3.4.8安装配置+HBase表和数据操作+HBase的架构体系+单例安装,记录了在Ubuntu下对HBase1.2.2的实践操作,H ...
- hadoop2.6完全分布式安装HBase1.1
本文出自:http://wuyudong.com/archives/119 对于全分布式的HBase安装,需要通过hbase-site.xml文档来配置本机的HBase特性,由于各个HBase之间通过 ...
- Hadoop2.7.5+Hbase1.4.0完全分布式
Hadoop2.7.5+Hbase1.4.0完全分布式一.在介绍完全分布式之前先给初学者推荐两本书:<Hbase权威指南>偏理论<Hbase实战>实战多一些 二.在安装完全分布 ...
- mysql 和 hive 和分布式zookeeper和HBASE分布式安装教程
一,mysql 安装mysql5.7完整教程1. yum -y install mysql-server直接执行语句后等待就好已安装: mysql-community-server.x86_64 0: ...
- Opentsdb分布式安装
Opentsdb分布式安装 --李琦 1.下载文件上传到虚拟机 -rw-r--r--. 1 root root 76793860 Apr 27 10:56 opentsdb-2.2.0.tar ...
- Hadoop生态圈-hbase介绍-伪分布式安装
Hadoop生态圈-hbase介绍-伪分布式安装 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.HBase简介 HBase是一个分布式的,持久的,强一致性的存储系统,具有近似最 ...
- 大数据hbase分布式安装及其部署。
大数据hbase分布式安装及其部署. 首先要启动Hadoop以及zookeeper,可以参考前面发布的文章. 将hbase的包上传至master节点 这里我使用的是1.3.6的版本,具体的根据自己的版 ...
随机推荐
- React性能优化总结(转)
原文链接: https://segmentfault.com/a/1190000007811296?utm_source=tuicool&utm_medium=referral 初学者对Rea ...
- python脚本批量杀死redis链接
#!/usr/bin/python #coding:utf8 import sys import commands,time,re ##自定义redis链接类 from redismodel impo ...
- LintCode 12.带最小值操作的栈(两种方法实现)
题目描述 实现一个带有取最小值min方法的栈,min方法将返回当前栈中的最小值. 你实现的栈将支持push,pop 和 min 操作,所有操作要求都在O(1)时间内完成. 样例 如下操作:push(1 ...
- ansible-palybook剧本
1 ansible基础知识部分补充 1.1 ansible软件特点: · 可以实现批量管理 · 可以实现批量部署 · ad-hoc(批量执行命令)---针对临时性的操作 ansible clsn -m ...
- 通过Ambari2.2.2部署HDP大数据服务
node1 amari-server node2 amari-agent namenode1,datanode,resourcemanager,zk node3 amari-agent namen ...
- loushang框架的开发中关于BSP的使用,将写好的功能模块部署到主页界面结构上
前言: 当我们已经开发好相应的模块或者功能的时候,需要将这个功能部署在index主页上作为可点击直接使用的模块,而不是每次需要去浏览对应的url地址. 这时候就需要运用到L5的BSP. 作为刚刚入门l ...
- python pandas库——pivot使用心得
python pandas库——pivot使用心得 2017年12月14日 17:07:06 阅读数:364 最近在做基于python的数据分析工作,引用第三方数据分析库——pandas(versio ...
- 右键添加git-bash
主要: 右键如果没有git-bash,如何给右键手动添加 前面对右键存在git-bash但使用出现问题的解决,也想到如果右键都没有,该如何给右键添加了,于是接着记录下如何添加的过程: 情形: 手动给右 ...
- flask迁移
from flask_script import Managerfrom flask_migrate import Migrate, MigrateCommandfrom info import cr ...
- 原lnmp环境服务器升级为mysql+nginx+php单个docker容器构建的lnmp环境
时间:2018年2月 一.项目背景 我单位现web服务架构为lnmp环境,服务器软件.硬件升级部署难:同时开源软件日新月异,考虑到技术升级,领导决定服务器架构整体升级为容器架构,维护性.移植性强. 二 ...