
实例学习——爬取豆瓣网TOP250数据
开发环境:(Windows)eclipse+pydev
网址:https://book.douban.com/top250?start=0
from lxml import etree        #解析提取数据

import requests               #请求网页获取网页数据

import csv                    #存储数据

fp = open('D:\Pyproject\douban.csv','wt',newline='',encoding='UTF-8')      #创建csv文件

writer = csv.writer(fp)

writer.writerow(('name','url','author','publisher','date','price','rate','comment'))  #写入表头信息,即第一行

urls = ['https://book.douban.com/top250?start={}'.format(str(i)) for i in range(0,250,25)]   #构建urls

headers = {'User-Agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/76.0.3809.100 Safari/537.36'}

for url in urls:                     #循环url,先抓大,后抓小(!!!重要,下面详解)

    html = requests.get(url,headers = headers)

    selector = etree.HTML(html.text)

    infos = selector.xpath('//tr[@class="item"]')

    for info in infos:

        name = info.xpath('td/div/a/@title')

        url = info.xpath('td/div/a/@href')

        book_infos = info.xpath('td/p/text()')[0]

        author = book_infos.split('/')[0]

        publisher =book_infos.split('/')[-3]

        date = book_infos.split('/')[-2]

        price = book_infos.split('/')[-1]

        rate = info.xpath('td/div/span[2]/text()')

        comments = info.xpath('td/p/span/text()')

        comment = comments[0] if len(comments) != 0 else ''

        writer.writerow((name,url,author,publisher,date,price,rate,comment))   #写入数据

fp.close()                          #关闭csv文件,勿忘
成果展示:
#乱码错误,用记事本打开,另存为UTF-8文件可解决

本例主要学习csv库的使用与数据批量抓取方式(即先抓大,后抓小,寻找循环点)
csv库创建csv文件及写入数据方式:
import csv

fp = ('C://Users/LP/Desktop/text.csv','w+')

writer = csv.writer(fp)

writer.writerow('id','name')

writer.writerow('','OCT')

writer.writerow('','NOV')                #写入行

fp.close()
数据批量抓取:
通过类似于BeautifulSoup中的selector()删除谓语部分不可行,思路应为“先抓大,后抓小,寻找循环点”(手写,非copy xpath)
打开chrome浏览器进行“检查”,通过“三角形符号”折叠元素,找到完整的信息标签,如下图
(selector()获取数据集中最大区域,遵循路径表达式,第一个字符串前置)
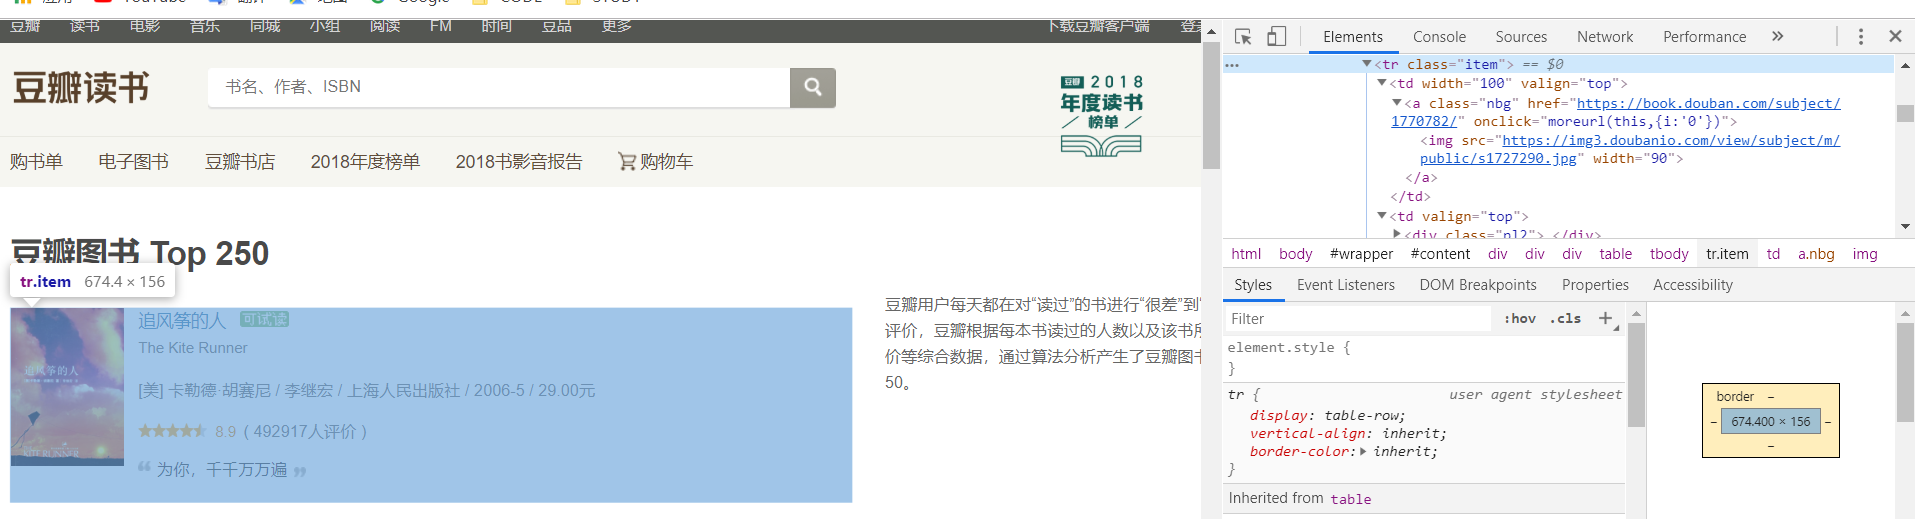
后每个单独的数据(名字,价格等)另取:
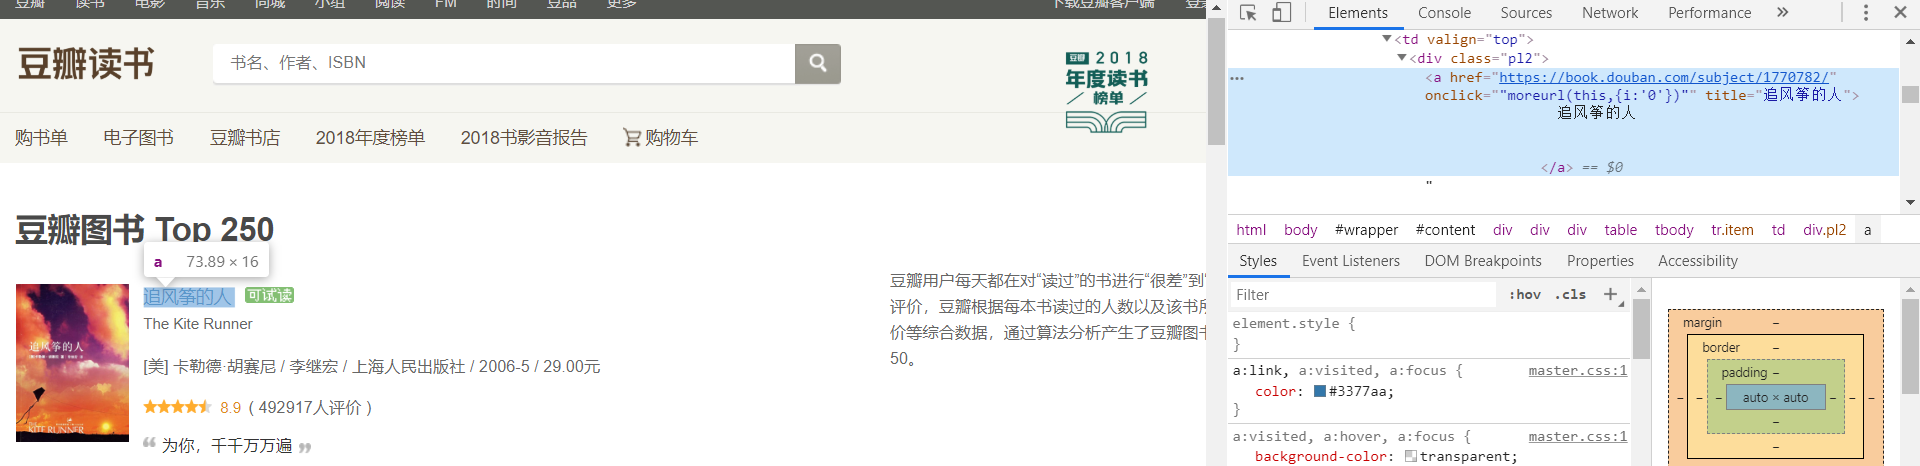
如 name,归属:<a>—><div>—><td>
所以:(当归属指向不变时,取小范围的)
name = info.xpath('td/div/a/@title')
实例学习——爬取豆瓣网TOP250数据的更多相关文章
- 实例学习——爬取豆瓣音乐TOP250数据
开发环境:(Windows)eclipse+pydev+MongoDB 豆瓣TOP网址:传送门 一.连接数据库 打开MongoDBx下载路径,新建名为data的文件夹,在此新建名为db的文件夹,d ...
- 爬取豆瓣网图书TOP250的信息
爬取豆瓣网图书TOP250的信息,需要爬取的信息包括:书名.书本的链接.作者.出版社和出版时间.书本的价格.评分和评价,并把爬取到的数据存储到本地文件中. 参考网址:https://book.doub ...
- python2.7爬取豆瓣电影top250并写入到TXT,Excel,MySQL数据库
python2.7爬取豆瓣电影top250并分别写入到TXT,Excel,MySQL数据库 1.任务 爬取豆瓣电影top250 以txt文件保存 以Excel文档保存 将数据录入数据库 2.分析 电影 ...
- scrapy爬虫框架教程(二)-- 爬取豆瓣电影TOP250
scrapy爬虫框架教程(二)-- 爬取豆瓣电影TOP250 前言 经过上一篇教程我们已经大致了解了Scrapy的基本情况,并写了一个简单的小demo.这次我会以爬取豆瓣电影TOP250为例进一步为大 ...
- 一起学爬虫——通过爬取豆瓣电影top250学习requests库的使用
学习一门技术最快的方式是做项目,在做项目的过程中对相关的技术查漏补缺. 本文通过爬取豆瓣top250电影学习python requests的使用. 1.准备工作 在pycharm中安装request库 ...
- python 爬虫&爬取豆瓣电影top250
爬取豆瓣电影top250from urllib.request import * #导入所有的request,urllib相当于一个文件夹,用到它里面的方法requestfrom lxml impor ...
- 【转】爬取豆瓣电影top250提取电影分类进行数据分析
一.爬取网页,获取需要内容 我们今天要爬取的是豆瓣电影top250页面如下所示: 我们需要的是里面的电影分类,通过查看源代码观察可以分析出我们需要的东西.直接进入主题吧! 知道我们需要的内容在哪里了, ...
- Scrapy中用xpath/css爬取豆瓣电影Top250:解决403HTTP status code is not handled or not allowed
好吧,我又开始折腾豆瓣电影top250了,只是想试试各种方法,看看哪一种的方法效率是最好的,一直进行到这一步才知道 scrapy的强大,尤其是和selector结合之后,速度飞起.... 下面我就采用 ...
- Python爬虫小白入门(七)爬取豆瓣音乐top250
抓取目标: 豆瓣音乐top250的歌名.作者(专辑).评分和歌曲链接 使用工具: requests + lxml + xpath. 我认为这种工具组合是最适合初学者的,requests比pytho ...
随机推荐
- LeetCode - 滑动窗口最大值
给定一个数组 nums,有一个大小为 k 的滑动窗口从数组的最左侧移动到数组的最右侧.你只可以看到在滑动窗口内的 k 个数字.滑动窗口每次只向右移动一位. 返回滑动窗口中的最大值. 输入: nums ...
- BeanPostProcessor和BeanFactoryPostProcessor的区别
官方文档: 在Spring核心的1.8章节 使用BeanPostProcessor自定义Bean BeanPostProcessor 接口定义了您可以实现的回调方法,以提供您自己的(或覆盖容器的默认) ...
- 一个ros包依赖另一个ros包提供的库
背景: 编写一个点云配准的ros包,记为A,在其中打算使用多种点云配准算法. 同一个ros工作空间下有另一个ros包,记为B,B中提供了几种点云配准算法,并将它们都编译成一个库文件并安装在工作空间中. ...
- SQL的积累
SQL的积累学习(不常用的经常会忘记,所以以后用到的就会记在下面): --新增字段alter table t_Student add Test varchar(200)--删除字段alter tabl ...
- kali文件执行的权限不够解决办法
root@kali:~# ./sql.py bash: ./sql.py: 权限不够 root@kali:~# ./.py Fuzzing PASS with bytes ^CTraceback (m ...
- mysql 时间差
SELECT TIMESTAMPDIFF(minute,'2019-01-01 00:00:00', '2019-01-01 01:30:00') 返回结果 90 类推,有 SELECT TIMEST ...
- ACM ICPC 2011-2012 Northeastern European Regional Contest(NEERC)E Eve
E: 模拟题,一开始有n个人(有男有女),对于子女来说线粒体DNA是继承母亲的.然后有m个操作(按时间顺序),一种就是给了父亲,母亲的ID,生了一个孩子(编号从n+1开始往下):还有一个就是 -x , ...
- sensu
https://blog.csdn.net/enweitech/article/details/53763324
- linux shell 中"2>&1"含义-完美理解-费元星
笨鸟先飞,先理解. 脚本是: nohup /mnt/Nand3/H2000G >/dev/null 2>&1 & 对于& 1 更准确的 ...
- 如何进行EDM邮件内容的撰写
近两个月没有来博客园更新一下博客文章了,实在惭愧,最近忙于工作,经常加班.下面来说说EDM邮件内容的撰写技巧吧,本文就跟大家交流一下自己一直以来的心得体会. EDM中很重要的一个步骤,就是邮件内容的撰 ...