
【Python项目篇】【爬妹子图】
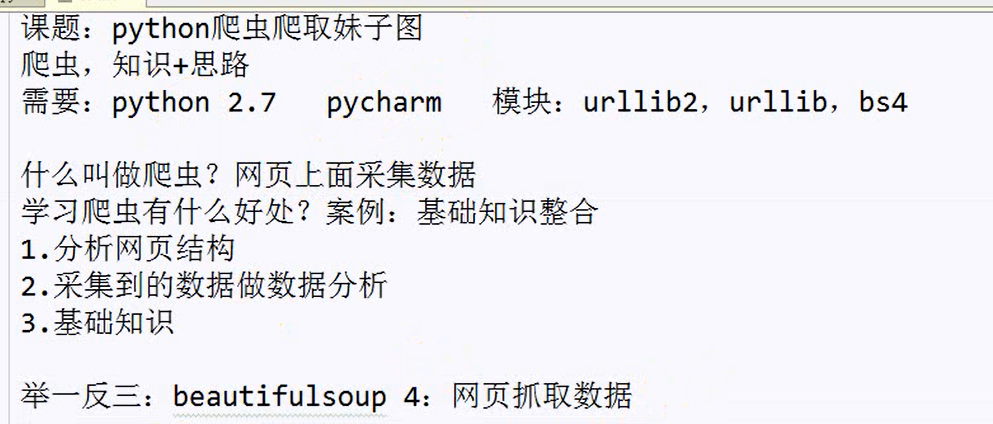

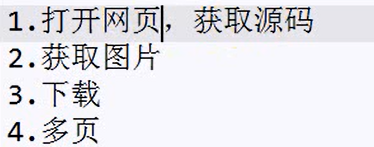
 #-*- coding:utf-8 -*-

 import urllib

 import urllib2

 from bs4 import beautifulsoup4 #获取标签下的内容

 #打开网页,获取源码

 x=0

 url='http://www.dbmeinv.com/?pager_offset=1'

 def crawl(url): #取名字,最好见名思义

     headers={'User-Agent':'Mozilla/5.0 (Windows NT 6.1; Win64; x64; rv:57.0) Gecko/20100101 Firefox/57.0'}

     req=urllib2.Request(url,headers=headers) #浏览器帽子

     page=urllib2.urlopen(req,timeout=20) #打开网页

     contents=page.read()#获取源码

     #print contents

     #html.parser是自带的解析方式,lxml功能大

     soup=BeautifulSoup(contents,'html.parser')#创建一个soup对象

     my_girl=soup.find_all('img')#找到所有的标签

     print(my_girl)

     for girl in my_girl:#遍历list,选取属性

         link=girl.get('src')#获取src图片路径

         print(link)

         #下载的文件,取名字

         global x

         urllib.urlretrieve(link,'image\%s.jpg'%x)

         x+=1

         print

 crawl(url)
以上代码在3.5环境下运行一下代码可以成功爬到各图片链接
 #-*- coding:utf-8 -*-

 import urllib.request

 from bs4 import BeautifulSoup #获取标签下的内容

 #打开网页,获取源码

 x = 0

 url = 'http://www.dbmeinv.com/?pager_offset=1'

 def crawl(url):

     print('')

     headers = {'User-Agent': 'Mozilla/5.0 (Windows NT 6.1; Win64; x64; rv:57.0) Gecko/20100101 Firefox/57.0'}

     print('')

     req = urllib.request.Request(url, headers=headers)

     page = urllib.request.urlopen(req)

     #req = urllib3.request(url, headers=headers) #浏览器帽子

     print('')

     #page = urllib3.urlopen(req, timeout=20) #打开网页

     contents = page.read()#获取源码

     soup = BeautifulSoup(contents,'html.parser')#创建一个soup对象

     my_girl = soup.find_all('img')#找到所有的标签

     print(my_girl)

     for girl in my_girl:

         link = girl.get('src')

         print(link)

         print('')

 print('')

 crawl(url)
【Python项目篇】【爬妹子图】的更多相关文章
- python3 爬 妹子图
Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库.它能够通过你喜欢的转换器实现惯用的文档导航,查找,修改文档的方式 Beautiful Soup 4 通过PyP ...
- 【Python项目】爬取新浪微博个人用户信息页
微博用户信息爬虫 项目链接:https://github.com/RealIvyWong/WeiboCrawler/tree/master/WeiboUserInfoCrawler 1 实现功能 这个 ...
- 【Python项目】爬取新浪微博签到页
基于微博签到页的微博爬虫 项目链接:https://github.com/RealIvyWong/WeiboCrawler/tree/master/WeiboLocationCrawler 1 实现功 ...
- python爬虫之一---------豆瓣妹子图
#-*- coding:utf-8 -*- __author__ = "carry" import urllib import urllib2 from bs4 import Be ...
- 老王Python培训视频教程(价值500元)【基础进阶项目篇 – 完整版】
老王Python培训视频教程(价值500元)[基础进阶项目篇 – 完整版] 教学大纲python基础篇1-25课时1.虚拟机安装ubuntu开发环境,第一个程序:hello python! (配置开发 ...
- 「玩转Python」突破封锁继续爬取百万妹子图
前言 从零学 Python 案例,自从提交第一个妹子图版本引来了不少小伙伴的兴趣.最近,很多小伙伴发来私信说,妹子图不能爬了!? 趁着周末试了一把,果然爬不动了,爬下来的都是些 0kb 的假图片,然后 ...
- Python使用Scrapy爬虫框架全站爬取图片并保存本地(妹子图)
大家可以在Github上clone全部源码. Github:https://github.com/williamzxl/Scrapy_CrawlMeiziTu Scrapy官方文档:http://sc ...
- Python 爬虫入门(二)——爬取妹子图
Python 爬虫入门 听说你写代码没动力?本文就给你动力,爬取妹子图.如果这也没动力那就没救了. GitHub 地址: https://github.com/injetlee/Python/blob ...
- Python 爬虫入门之爬取妹子图
Python 爬虫入门之爬取妹子图 来源:李英杰 链接: https://segmentfault.com/a/1190000015798452 听说你写代码没动力?本文就给你动力,爬取妹子图.如果 ...
随机推荐
- DropDownList添加客户端下拉事件操作
如果要想给 DropDownList 服务器控件添加客户端下拉事件,我们可以强制给它添加 onchange 事件,尽管在控件中没有这个方法的提示.添加完这个事件还不能达到目的,还要设置 AutoPos ...
- XML高速入门
XML是什么 Extensible Markup Language 自己定义标签: 用来数据传输: 可扩展标记语言,是一种类似超文本标记语言的标记语言. 与HTML的比較: 1.不是用来替代HTML的 ...
- mysql中根据一个字段相同记录写递增序号,如序号结果,如何实现?
mysql中根据一个字段相同记录写递增序号,如序号结果,如何实现? mysql中实现方式如下: select merchantId, NameCn, send_date, deliver_name ...
- json 数据分析
/* 健一健康头条 */ try { String url = "http://www.j1health.com/j1api.php/index/getJ1healthHotLists&qu ...
- windbg载入目标模块pdb
.reload /f xxxx.dll ld xxxx 以kdcom为例子 .reload /f kdcom.dll ld kdcom 二选一
- 网络电话pjsip Getting Started: Building for Apple iPhone, iPad and iPod Touch
Getting Started: Building for Apple iPhone, iPad and iPod Touch ¶ Getting Started Preparation Get th ...
- 国内linux 镜像
北京理工大学开源软件镜像服务mirrors.ustc.edu.cn 开源中国社区软件镜像下载资源库mirrors.oss.org.cn 阿里云开源镜像站mirrors.aliyun.com<ig ...
- Android 系统镜像: boot.img kernel.img ramdisk.img system.img userdata.img cache.img recovery.img
boot.img(kernel.img+ramdisk.img) ramdisk.img(/) system.img(/system) userdata.img(/data) cache.img(/c ...
- vscode新建html,没有模板
首先,在文件夹下右击--新建--index.html 输入! 按tab键 完成!
- glassfish任意文件读取漏洞解析
一.背景: glassfish是一款java编写的跨平台的开源的应用服务器. 二.漏洞原理: 与宽字节SQL注入一致,都是由于unicode编码歧义导致的.具体payload如下构造: http:// ...