
完全用nosql轻松打造千万级数据量的微博系统(转)
原文:http://www.cnblogs.com/imxiu/p/3505213.html
其实微博是一个结构相对简单,但数据量却是很庞大的一种产品.标题所说的是千万级数据量 也并不是一千万条微博信息而已,而是千万级订阅关系之间发布。在看 我这篇文章之前,大多数人都看过sina的杨卫华大牛的微博开发大会上的演讲.我这也不当复读机了,挑重点跟大家说一下。
大家都知道微博的难点在于明星会员问题,什么是明星会员问题了,就是刘德华来咱这开了微博,他有几百万的粉丝订阅者,他发一条微博信息,那得一下子 把微博 信息发布到几百万的粉丝里去,如果黎明、郭富城等四大天王都来咱来开微博,那咱小站不是死翘翘了.所以这时消息队列上场了。在我的架构里 有一个异步publish集群,publish的任务都去zeromq队列读取队列.zeromq是目前已知开源的消息传递最快的一个。具体关于 zeromq可以自己google。zeromq有一个问题是不能持久化数据,这个自己做持久化存储.回过刚才那个话题, 把明星会员的粉丝按照"活跃度"进行分级。"活跃度"是根据登陆频度,时间,发布微博等因素大致分为铁杆粉丝、爱理不理、半死不活三大类分到不同的发布集 群中去. 铁杆粉丝类型的异步发布集群,发布速度肯定是最快的.微博的信息是用handler socket保存到mysql。这个信息ID,是用rdtsc+2位随机整数拼接而成的 64位整数唯一ID,防止出现自增ID出现的多服务器 id一致性的问题. 在publish的时候,集群只是把微博信息的ID发送给redis的订阅者。所以这个数据是很快的。而且订阅者的list里只保存的是ID.在内存的占 用率上也不是很高.
下面我给大家看一下我的mysql和redis数据结构
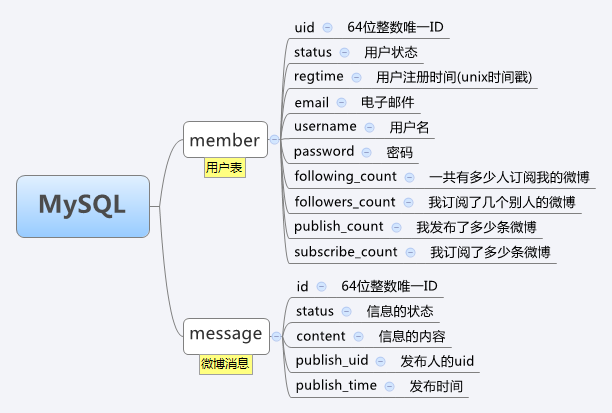
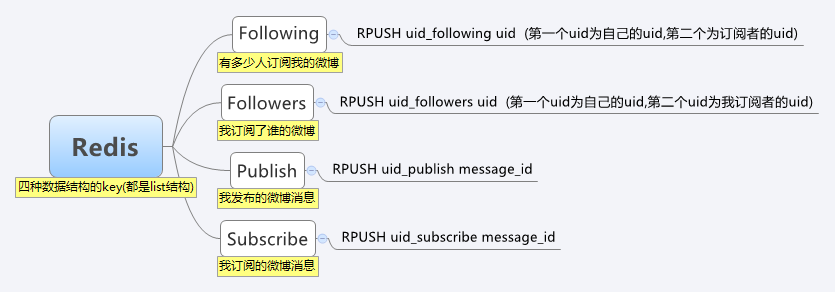
在我的结构中还有一个重要角色就是"Key GPS Server"(简称:KGS)简单来说,这个是分布式数据存储的中心索引服务器.一切数据的存储和获取,都通过KGS来定位. KGS支持多个服务器,多个机房多重备份存储。KGS是以Tokyo Cabinet的hash db为存储的socket server。记录key跟服务器之间的对应关系. KGS的任务就是告知key该存储在哪几台服务器上,或者告知该key存储在哪几台服务器上,并不做其他的服务.这样大大的减轻KGS的压力.
再说一下Redis集群,redis是以纯内存形式模式运行,关闭了热备的功能(redis的热备并不是那么好). 自己写了个backend server.在每台运行redis的机子上都运行着backend socket 进程, backend进程也是以tc的hash db为存储。备份着当前服务器的redis数据。当redis重启的时候,从本机的bakcend db 加载所有数据. Redis的集群是以用户水平切分法来分布的
现在该轮到mysql里, 在这个架构中,基本消除了这边缓存 那边缓存的问题。因为在这个集群中的每个服务都是高速运行的.唯一的一处的cache 就是在php端的eAccelerator local cache. eAccelerator是基于共享内存的,所有速度比基于socket类型的cache快多了. eAccelerator 缓存了用户top N条的微博信息还有从KGS查询的结果。 看到这里有人问了,你把用户信息和微博信息都放在mysql里,怎么能不用cache了.嘿嘿,因为我用了 handler socket。HS 是小日本写的一款mysql插件.HS避开了MySQL通讯协议,直接读取MySQL引擎。在多核、大内存、 InnoDB引擎环境,性能直超memcached.HS能以Key-Value方式直接读写mysql引擎
总结
Google首席科学家讲过一句话,就是一个大的复杂的系统,应该要分解成很多小的服务. 我的这个架构也是由一个个小的集群来共同处理大数据量发布数据。有的人为什么不用mongodb了,因为mongodb是一款大众性的分布式nosql db,我们有自己的key分布策略,不太适合用mongodb. 不理解redis的存储关系的同学,可以先参考一下 Retwis, Retwis是用纯redis实现的简单微博.
具体的架构图、流程图、ppt文件。请下载附件来阅读. http://code.google.com/p/php-tokyocabinet/downloads/detail?name=micro-blog-qiye.tar.bz2&can=2&q=#makechanges
我的QQ: 531020471 mail: lijinxing#gmail.com
两个相关项目:Retwis-py Retwis-RB (用 Python 和 Ruby 实现类本文思路的项目)
From:
完全用nosql轻松打造千万级数据量的微博系统(转)的更多相关文章
- 完全用nosql轻松打造千万级数据量的微博系统
其实微博是一个结构相对简单,但数据量却是很庞大的一种产品.标题所说的是千万级数据量也并不是一千万条微博信息而已,而是千万级订阅关系之间发布.在看 我这篇文章之前,大多数人都看过sina的杨卫华大牛的微 ...
- mysql千万级数据量查询出所有重复的记录
查询重复的字段需要创建索引,多个条件则创建组合索引,各个条件的索引都存在则不必须创建组合索引 有些情况直接使用GROUP BY HAVING则能直接解决:但是有些情况下查询缓慢,则需要使用下面其他的方 ...
- (转载)MYSQL千万级数据量的优化方法积累
转载自:http://blog.sina.com.cn/s/blog_85ead02a0101csci.html MYSQL千万级数据量的优化方法积累 1.分库分表 很明显,一个主表(也就是很重要的表 ...
- php+中文分词scws+sphinx+mysql打造千万级数据全文搜索
转载自:http://blog.csdn.net/nuli888/article/details/51892776 Sphinx是由俄罗斯人Andrew Aksyonoff开发的一个全文检索引擎.意图 ...
- MySQL 千万 级数据量根据(索引)优化 查询 速度
一.索引的作用 索引通俗来讲就相当于书的目录,当我们根据条件查询的时候,没有索引,便需要全表扫描,数据量少还可以,一旦数据量超过百万甚至千万,一条查询sql执行往往需要几十秒甚至更多,5秒以上就已经让 ...
- mysql千万级数据量根据索引优化查询速度
(一)索引的作用 索引通俗来讲就相当于书的目录,当我们根据条件查询的时候,没有索引,便需要全表扫描,数据量少还可以,一旦数据量超过百万甚至千万,一条查询sql执行往往需要几十秒甚至更多,5秒以上就已经 ...
- 2020-06-02:千万级数据量的list找一个数据。
福哥答案2020-06-02: 对于千万级长度的数组单值查找:序号小的,单线程占明显优势:序号大的,多线程占明显优势.单线程时间不稳定,多线程时间稳定. go语言测试代码如下: package mai ...
- MYSQL千万级数据量的优化方法积累
1.对查询进行优化,应尽量避免全表扫描,首先应考虑在 where 及 order by 涉及的列上建立索引. 2.应尽量避免在 where 子句中对字段进行 null 值判断,否则将导致引擎放弃使用索 ...
- BayaiM__MYSQL千万级数据量的优化方法积累__初级菜鸟
-----------------------------------------------------------------------------———————-------------- ...
随机推荐
- Qt 定时器Timer使用
From: http://dragoon666.blog.163.com/blog/static/107009194201092602326598/ 1.新建Gui工程,在主界面上添加一个标签labe ...
- 【Java NIO的深入研究1】缓冲区
缓冲区 传统的流和通道的对比 流 通道 慢 快 处理简单 处理复杂 单字节的传输 一块数据的传输 - Java.io.*已经重新写过 - 是对流的模拟 单向的 双向的 可直接访问 必须通过Buffer ...
- 分配All AD User到SharePoint Group中
使用名称为“NT AUTHORITY\Authenticated Users”
- hadoop2.7.1单机和伪集群的搭建-0
内容中包含 base64string 图片造成字符过多,拒绝显示
- C/C++ 控制台演示彩色输出进度
#include <stdio.h> #include <windows.h> BOOL SetConsoleColor(WORD wAttributes); int main ...
- Node.js 原生模块开发方式变迁
https://mp.weixin.qq.com/s/-oLqB8ITk_Q5AIoNLzBg0w
- 【java】 java 设计模式概述
一.设计模式的分类 总体来说设计模式分为三大类: 创建型模式,共五种:工厂方法模式.抽象工厂模式.单例模式.建造者模式.原型模式. 结构型模式,共七种:适配器模式.装饰器模式.代理模式.外观模式.桥接 ...
- C# 温故而知新:Stream篇(二)
TextReader 和StreamReader 目录: 为什么要介绍 TextReader? TextReader的常用属性和方法 TextReader 示例 从StreamReader想到多态 简 ...
- BI产品学习笔记
理解现在--挖掘规律--预测未来------------------------------------------------------精准营销智能风控运营优化 多维分析挖掘预测敏捷BI 分析展示 ...
- 编译OSG的FreeType插件时注意的问题
使用自己编译的freetype.lib,在编译osgdb_freetype插件项目时,报错LINK错误,找不到png的一堆函数 最简单的方式是不要使用PNG编译freetype.记住不要犯贱.