
Kafka与.net core(三)kafka操作
1.Kafka相关知识
- Broker:即Kafka的服务器,用户存储消息,Kafa集群中的一台或多台服务器统称为broker。
- Message消息:是通信的基本单位,每个 producer 可以向一个 topic(主题)发布一些消息。
- Kafka中的Message是以topic为基本单位组织的,不同的topic之间是相互独立的。每个topic又可以分成几个不同的partition(每个topic有几个partition是在创建topic时指定的),每个partition存储一部分Message。
- partition中的每条Message包含了以下三个属性:Kafka基于文件存储.通过分区,可以将日志内容分散到多个server上,来避免文件尺寸达到单机磁盘的上限,每个partiton都会被当前server(kafka实例)保存。可以将一个topic切分多任意多个partitions,来消息保存/消费的效率。
- offset:消息唯一标识:对应类型:long
- MessageSize 对应类型:int32
- data 是message的具体内容。
- 越多的partitions意味着可以容纳更多的consumer,有效提升并发消费的能力。
- Message:在Broker中通Log追加的方式进行持久化存储。并进行分区(patitions)。
- 一个Topic可以认为是一类消息,每个topic将被分成多partition(区),每个partition在存储层面是append log文件。任何发布到此partition的消息都会被直接追加到log文件的尾部,每条消息在文件中的位置称为offset(偏移量),partition是以文件的形式存储在文件系统中。
- Logs文件根据broker中的配置要求,保留一定时间后删除来释放磁盘空间。

- Topic物理上的分组,一个 topic可以分为多个 partition,每个 partition 是一个有序的队列。partition中的每条消息都会被分配一个有序的 id(offset)。
- 为实现稀疏存储,我们通过给文件建索引,每隔一定字节的数据建立一条索引
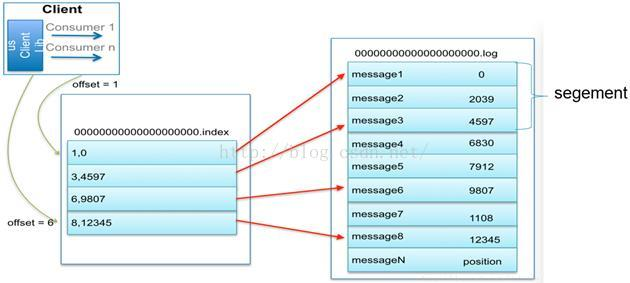
- 为了减少磁盘写入的次数,broker会将消息暂时buffer起来,当消息的个数(或尺寸)达到一定阀值时,再flush到磁盘,这样减少了磁盘IO调用的次数。
- Broker没有副本机制,一旦broker宕机,该broker的消息将都不可用。Message消息是有多份的。
- consumer:消息和数据消费者,订阅topics并处理其发布的消息的过程叫做consumers。
- 在 kafka中,我们可以认为一个group是一个订阅者,一个Topic中的每个partions,只会被一个订阅者中的一个consumer消费,不过一个 consumer可以消费多个partitions中的消息(消费者数据小于Partions 的数量时)。注意:kafka的设计原理决定,对于一个topic,同一个group中不能有多于partitions个数的consumer同时消费,否则将意味着某些consumer将无法得到消息。
- 一个partition中的消息只会被group中的一个consumer消息。每个group中consumer消息消费互相独立。
- 无状态导致消息的删除成为难题(可能删除的消息正在被订阅),kafka采用基于时间的SLA(服务水平保证),消息保存一定时间(通常为7天)后会被删除。
- 消息订阅者可以rewind back到任意位置重新进行消费,当订阅者故障时,可以选择最小的offset(id)进行重新读取消费消息。
2.kafka操作
2.1.查看有哪些主题:
kafka-topics.sh --list --zookeeper 192.168.0.201:
2.2.查看topic的详细信息
kafka-topics.sh -zookeeper 127.0.0.1: -describe -topic testKJ1
2.3.为topic增加副本
kafka-reassign-partitions.sh -zookeeper 127.0.0.1: -reassignment-json-file json/partitions-to-move.json -execute
2.4.创建topic
kafka-topics.sh --create --zookeeper localhost: --replication-factor --partitions --topic testKJ1
2.5为topic增加partition
bin/kafka-topics.sh –zookeeper 127.0.0.1: –alter –partitions –topic testKJ1
2.6kafka生产者客户端命令
kafka-console-producer.sh --broker-list localhost: --topic testKJ1
2.7kafka消费者客户端命令
kafka-console-consumer.sh -zookeeper localhost: --from-beginning --topic testKJ1
2.8kafka服务启动
kafka-server-start.sh -daemon ../config/server.properties
3..net core操作
producer端,引入Confluent.Kafka
Install-Package Confluent.Kafka -Version 1.0-beta2
using Confluent.Kafka;

using System;

using System.Collections.Generic;

using System.Text;

using System.Threading.Tasks;

namespace KafkaTest

{

    class Program

    {

        static void Main(string[] args)

        {

            Test().Wait();

        }

        static async Task Test()

        {

           var conf = new ProducerConfig { BootstrapServers = "39.**.**.**:9092" };

            Action<DeliveryReportResult<Null, string>> handler = r =>

                Console.WriteLine(!r.Error.IsError

                    ? $"Delivered message to {r.TopicPartitionOffset}"

                    : $"Delivery Error: {r.Error.Reason}");

            using (var p = new Producer<Null, string>(conf))

            {

                for (int i = ; i < ; ++i)

                {

                    p.BeginProduce("my-topic", new Message<Null, string> { Value = i.ToString() }, handler);

                }

                // wait for up to 10 seconds for any inflight messages to be delivered.

                p.Flush(TimeSpan.FromSeconds());

            }

        }

    }

}
consumer端,引入Confluent.Kafka
Install-Package Confluent.Kafka -Version 1.0-beta2
using Confluent.Kafka;

using System;

using System.Linq;

using System.Text;

namespace KafkaClient

{

    class Program

    {

        static void Main(string[] args)

        {

            var conf = new ConsumerConfig

            {

                GroupId = "test-consumer-group4",

                BootstrapServers = "39.**.**.**:9092",

                // Note: The AutoOffsetReset property determines the start offset in the event

                // there are not yet any committed offsets for the consumer group for the

                // topic/partitions of interest. By default, offsets are committed

                // automatically, so in this example, consumption will only start from the

                // earliest message in the topic 'my-topic' the first time you run the program.

                AutoOffsetReset = AutoOffsetResetType.Earliest

            };

            using (var c = new Consumer<Ignore, string>(conf))

            {

                c.Subscribe("my-topic");

                bool consuming = true;

                // The client will automatically recover from non-fatal errors. You typically

                // don't need to take any action unless an error is marked as fatal.

                c.OnError += (_, e) => consuming = !e.IsFatal;

                while (consuming)

                {

                    try

                    {

                        var cr = c.Consume();

                        Console.WriteLine($"Consumed message '{cr.Value}' at: '{cr.TopicPartitionOffset}'.");

                    }

                    catch (ConsumeException e)

                    {

                        Console.WriteLine($"Error occured: {e.Error.Reason}");

                    }

                }

                // Ensure the consumer leaves the group cleanly and final offsets are committed.

                c.Close();

            }

        }

    }

}
Kafka与.net core(三)kafka操作的更多相关文章
- Kafka设计解析(三)Kafka High Availability (下)
转载自 技术世界,原文链接 Kafka设计解析(三)- Kafka High Availability (下) 摘要 本文在上篇文章基础上,更加深入讲解了Kafka的HA机制,主要阐述了HA相关各种场 ...
- kafka问题集(三)ISR缺失
仅个人实践所得,若是有误,欢迎指出. 一.场景 kafka集群中某一节点(N-10)的CPU利用率大于整个集群的平均水平,且达到报警值.使用top命令后台查看时发现是kafka服务导致CPU利用率高. ...
- Kafka 教程(二)-安装与基础操作
单机安装 1. 安装 java 2. 安装 zookeeper [这一步可以没有,因为 kafka 自带了 zookeeper] 3. 安装 kafka 下载链接 kafka kafka 是 scal ...
- .Net Core 集成 Kafka
最近维护的一个系统并发有点高,所以想引入一个消息队列来进行削峰.考察了一些产品,最终决定使用kafka来当做消息队列.以下是关于kafka的一些知识的整理笔记. kafka kafka 是分布式流式平 ...
- Kafka及 .NET Core 客户端
消息队列 Kafka 的基本知识及 .NET Core 客户端 消息队列 Kafka 的基本知识及 .NET Core 客户端 前言 最新项目中要用到消息队列来做消息的传输,之所以选着 Kafka ...
- kafka学习(三)-kafka集群搭建
kafka集群搭建 下面简单的介绍一下kafka的集群搭建,单个kafka的安装更简单,下面以集群搭建为例子. 我们设置并部署有三个节点的 kafka 集合体,必须在每个节点上遵循下面的步骤来启动 k ...
- Kafka笔记整理(三):消费形式验证与性能测试
Kafka消费形式验证 前面的<Kafka笔记整理(一)>中有提到消费者的消费形式,说明如下: .每个consumer属于一个consumer group,可以指定组id.group.id ...
- EF Core 三 、 骚操作 (导航属性,内存查询...)
EF Core 高阶操作 本文之前,大家已经阅读了前面的系列文档,对其有了大概的了解 我们来看下EF Core中的一些常见高阶操作,来丰富我们业务实现,从而拥有更多的实现选择 1.EF 内存查找 wh ...
- Kafka与.net core(一)安装
1.安装JDK 目前官网不能直接下载,在网上找到1.8.0版本安装包下载到本地. 1.1.下载jdk并解压 [root@iz2zei2y693gtrgwlibzlwz java]# ls jdk1.. ...
- kafka producer consumer demo(三)
我们在前面把集群搭建起来了,也设置了kafka broker的配置,下面我们用代码来实现一下客户端向kafka发送消息,consumer端从kafka消费数据.大家先不要着急着了解 各种参数的配置,先 ...
随机推荐
- pandas的数据结构
要使用pandas,需要熟悉它的两个主要的数据结构,Series和DataFrame. Series series是一种类似于以为数组的对象,它由一组数据(各种numpy的数据类型)以及一组与之相关的 ...
- spring data jpa 的各种查询总结
参考哦:https://blog.csdn.net/weixin_36667844/article/details/79945156
- Sonar及其eclipse插件的安装 详细 http://www.importnew.com/10017.html
参考:http://www.importnew.com/10017.html
- leetcode290
public class Solution { public bool WordPattern(string pattern, string str) { var list = str.Split(' ...
- 8.3.2018 1 Quick and dirty 快而脏的快餐
Quick and dirty 快而脏的快餐 BEIJING 北京 Food delivery is a booming business. Waste is piling up, too 送餐 ...
- 【独家】阿里天池IJCAI17大赛第四名方案全解析(附代码)
[独家]阿里天池IJCAI17大赛第四名方案全解析(附代码) https://mp.weixin.qq.com/s?__biz=MzAxMzA2MDYxMw==&mid=2651560625& ...
- 【Git】四、Git工作
一.Git创建仓库 版本库:代码仓库(repository),可以理解为一个项目的目录,在这个项目的目录中Git对每个文件进行管理,记录每个文件的增删改查记录,并能够追踪历史,在需要的时候可以回退到某 ...
- mapreduce of hadoop
[mapreduce of hadoop] 1. MapReduce作业(Job)是客户端想要执行的一个作单元, 它包括: 输入数据, MapReduce程序, 配置信息. 2. Hadoop将作业成 ...
- 2015年传智播客JavaEE 第168期就业班视频教程day45-ERP项目-01 05-主线流程
采购管理 销售管理 采购退货管理 销售退货管理 老师的采购单的审核是分三级审核的,如果这个单子是个普通单子,那么审核一下就完了,如果这个单子超过100万,需要二级领导审核,如果这个单子超过500万, ...
- flume 配置说明
Flume中的HDFS Sink应该是非常常用的,其中的配置参数也比较多,在这里记录备忘一下. channel type hdfs path 写入hdfs的路径,需要包含文件系统标识,比如:hdfs: ...