
爬虫_豆瓣电影top250 (正则表达式)
一样的套路,就是多线程还没弄
 import requests

 import re

 import json

 headers = 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/65.0.3325.181 Safari/537.36'

 def get_one_page(url):

     try:

         html = requests.get(url, headers={'User-Agent':'headers'})

         if html.status_code == 200:

             return html.text

         return None

     except RequestsException:

         return None

 def write_txt(content):

     with open('result.txt', 'a', encoding='utf-8') as f:

         f.write(json.dumps(content, ensure_ascii=False) + '\n')

         f.close

 def parse_one_page(html):

     # <em class="">(\d+)</em>

     # .*?href="(.*?)/">.*?

     # other">(\w+)</span

     match = re.compile('.*?<em class="">(.*?)</em>.*?href="(.*?)/">.*?"title">(.*?)</span.*?other">(.*?)</span', re.S)

     results = re.findall(match, html)

     for item in results:

         yield{

             'range': item[0],

             'movie_main_page': item[1],

             'movie_title': item[2],

             'other_name': item[3].strip()[13:]

         }

     # print(results)

 def main():

     for start in range(0, 250, 25):

         url = 'https://movie.douban.com/top250?start=' + str(start)

         html = get_one_page(url)

         for item in parse_one_page(html):

             print(item)

             write_txt(item)

 if __name__ == '__main__':

     main()
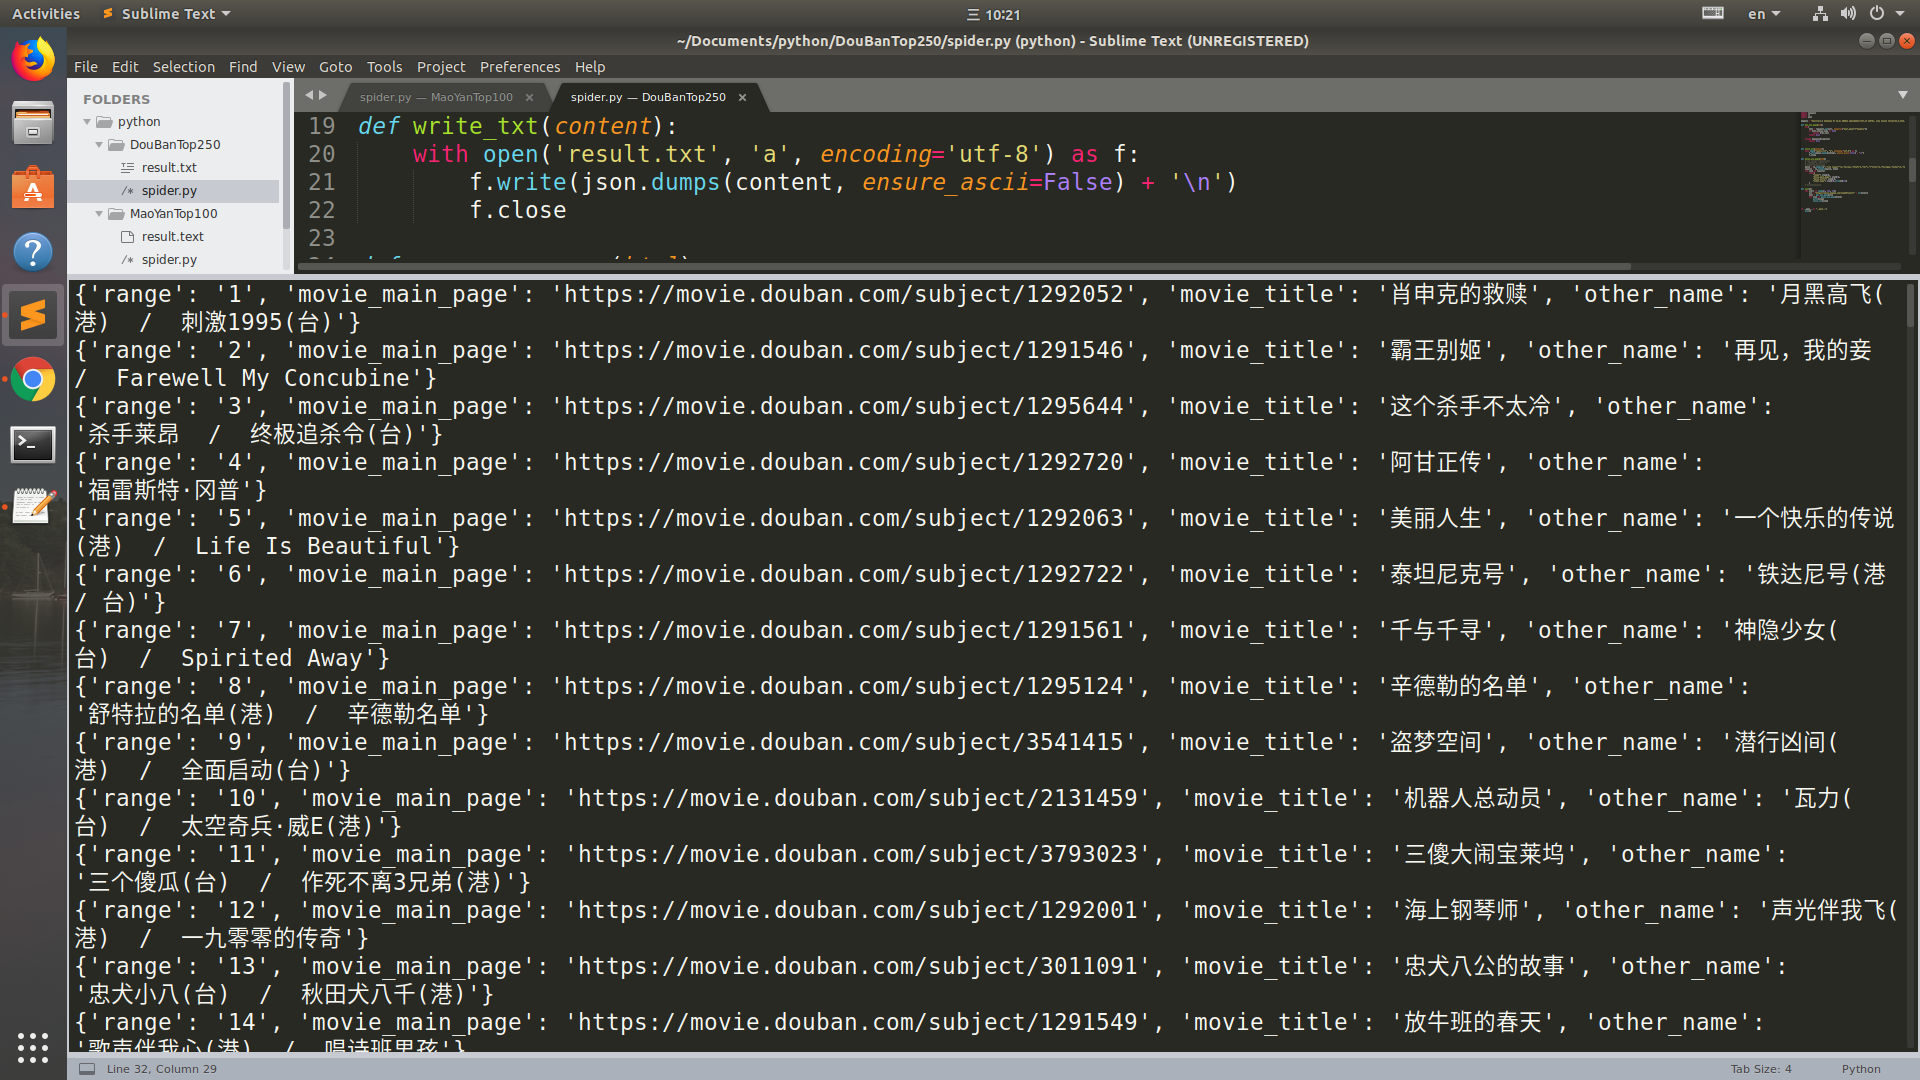
运行结果
爬虫_豆瓣电影top250 (正则表达式)的更多相关文章
- <爬虫实战>豆瓣电影TOP250(三种解析方法)
1.豆瓣电影排行.py # 目标:爬取豆瓣电影排行榜TOP250的电影信息 # 信息包括:电影名字,上映时间,主演,评分,导演,一句话评价 # 解析用学过的几种方法都实验一下①正则表达式.②Beaut ...
- 【Python爬虫】:使用高性能异步多进程爬虫获取豆瓣电影Top250
在本篇博文当中,将会教会大家如何使用高性能爬虫,快速爬取并解析页面当中的信息.一般情况下,如果我们请求网页的次数太多,每次都要发出一次请求,进行串行执行的话,那么请求将会占用我们大量的时间,这样得不偿 ...
- 第一个爬虫经历----豆瓣电影top250(经典案例)
因为要学习数据分析,需要从网上爬取数据,所以开始学习爬虫,使用python进行爬虫,有好几种模拟发送请求的方法,最基础的是使用urllib.request模块(python自带,无需再下载),第二是r ...
- Python 爬虫:豆瓣电影Top250,包括电影导演、类型、年份、主演
结果输出到文本文件中. import codecs import requests from bs4 import BeautifulSoup headers={'User-Agent': 'Mozi ...
- 一起学爬虫——通过爬取豆瓣电影top250学习requests库的使用
学习一门技术最快的方式是做项目,在做项目的过程中对相关的技术查漏补缺. 本文通过爬取豆瓣top250电影学习python requests的使用. 1.准备工作 在pycharm中安装request库 ...
- Python爬虫----抓取豆瓣电影Top250
有了上次利用python爬虫抓取糗事百科的经验,这次自己动手写了个爬虫抓取豆瓣电影Top250的简要信息. 1.观察url 首先观察一下网址的结构 http://movie.douban.com/to ...
- 利用python2.7正则表达式进行豆瓣电影Top250的网络数据采集及MySQL数据库操作
转载请注明出处 利用python2.7正则表达式进行豆瓣电影Top250的网络数据采集 1.任务 采集豆瓣电影名称.链接.评分.导演.演员.年份.国家.评论人数.简评等信息 将以上数据存入MySQL数 ...
- 练习:一只豆瓣电影TOP250的爬虫
练习:一只豆瓣电影TOP250爬虫 练习:一只豆瓣电影TOP250爬虫 ①创建project ②编辑items.py import scrapyclass DoubanmovieItem(scrapy ...
- scrapy爬虫框架教程(二)-- 爬取豆瓣电影TOP250
scrapy爬虫框架教程(二)-- 爬取豆瓣电影TOP250 前言 经过上一篇教程我们已经大致了解了Scrapy的基本情况,并写了一个简单的小demo.这次我会以爬取豆瓣电影TOP250为例进一步为大 ...
随机推荐
- MySQL中有关NULL的计算
mysql> select NULL=NULL; #判断两个NULL是否相等,结果不是1也不是0 +-----------+ | NULL=NULL | +-----------+ | NULL ...
- 【kindle笔记】之 《恶意》-2018-4-20
[kindle笔记]读书记录-总 在答辩和考试和各种大作业的重压以及两天后全校停电的巨大挤压中,一口气读完了恶意这本书. 这本书是我读的东野圭吾的第二本书.第一本是心心念念的<解忧杂货店> ...
- js 正则进阶regexp
一.匹配中文,英文字母和数字及_: const reg = /^[\u4e00-\u9fa5\w]+$/; const str1 = 'shangyy'; const str2 = '尚悦悦ww123 ...
- node错误中间件处理 express类 带有路由操作
let express = require('express'); let app = new express(); let bodyParser = require('body-parser'); ...
- Git命令以及常见注意事项
命令: git init -> 初始化一个git仓库 git clone -> 克隆一个本地库 git pull -> 拉取服务器最新代码 git fetch –p -> 强行 ...
- laravel中如何在模型中自关联?
https://segmentfault.com/q/1010000007926567 在模型中声明一对多的关系,关联表本身.parent_id对应父记录的id.我在sof中查阅到很多这样的写法: p ...
- js中的call、apply、bind
在js中每个函数都包含两个非继承而来的方法:call()和apply() call和apply的作用都是在特定的作用域中将函数绑定到另外一个对象上去运行,即可以用来重新定义函数的执行环境,两者仅在定义 ...
- Python 常用模块总结
模块的分类: 1.内置模块(python自带的比如像os,sys等模块) 2.自定义模块,自己写的一些模块 3.第三方模块(开源模块) 模块导入: 1.import sys ...
- vscode git設置
1.git官网https://git-scm.com/download/win 链接下载:64-bit Git for Windows Setup,不要下载Portable,体积太大了: 如果git官 ...
- js模拟ctrl+c的问题
1.这种方式只可以对显示的textbox和textarea使用,对于display:none和visibility hidden 以及其他标签无效 var message = document.get ...