
Spark大数据平台安装教程
一.Spark介绍
Apache Spark 是专为大规模数据处理而设计的快速通用的计算引擎。Spark是开源的类Hadoop MapReduce的通用并行框架,Spark拥有Hadoop MapReduce所具有的优点;但不同于MapReduce的是Job中间输出结果可以保存在内存中,从而不再需要读写HDFS,因此Spark能更好地适用于数据挖掘与机器学习等需要迭代的MapReduce的算法。
二.安装Spark
环境:Docker(17.04.0-ce)、镜像Ubuntu(16.04.3)、JDK(1.8.0_144)、Hadoop(3.1.1)、Spark(2.3.2)
1.安装Hadoop
参考:Hadoop伪分布式模式安装
2.解压Spark
bigdata@lab-bd:~$ tar -xf spark-2.3.-bin-without-hadoop.tgz
3.重名名conf/spark-env.sh.template为spark-env.sh
bigdata@lab-bd:~$ mv spark-2.3.-bin-without-hadoop/conf/spark-env.sh.template spark-2.3.-bin-without-hadoop/conf/spark-env.sh
4.编辑conf/spark-env.sh文件,增加如下变量
export JAVA_HOME=/home/hadoop/jdk1..0_144

export SPARK_DIST_CLASSPATH=$(/home/hadoop/hadoop-3.1./bin/hadoop classpath)

export HADOOP_CONF_DIR=/home/hadoop/hadoop-3.1./etc/hadoop

export PYSPARK_PYTHON=/usr/bin/python3.
三.运行Spark
1.启动Hdfs服务
bigdata@lab-bd:~$ hadoop-3.1./sbin/start-dfs.sh
2.启动Yarn服务
bigdata@lab-bd:~$ hadoop-3.1./sbin/start-yarn.sh
3.交互模式运行pyspark
bigdata@lab-bd:~$ spark-2.3.-bin-without-hadoop/bin/pyspark --master yarn --deploy-mode client 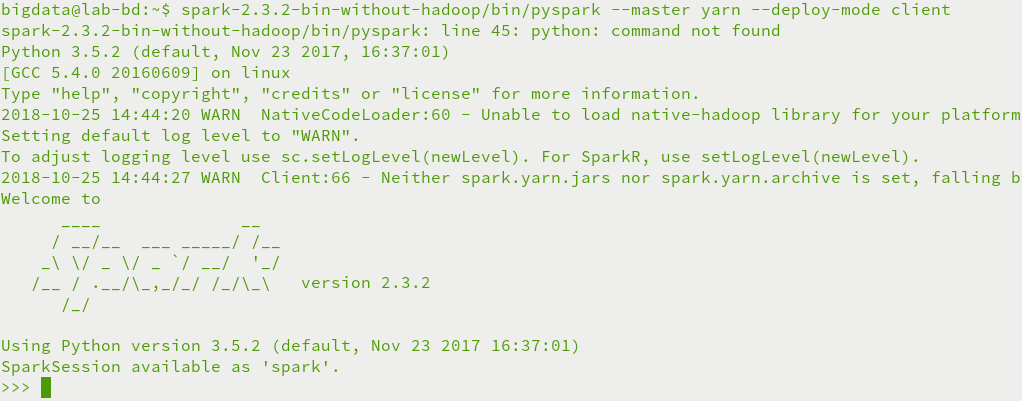
4.提交模式运行spark-submit
bigdata@lab-bd:~$ spark-2.3.-bin-without-hadoop/bin/spark-submit --class org.apache.spark.examples.SparkPi --master yarn --deploy-mode client \

> spark-2.3.-bin-without-hadoop/examples/jars/spark-examples_2.-2.3..jar
5.浏览器访问http://10.0.0.3:8088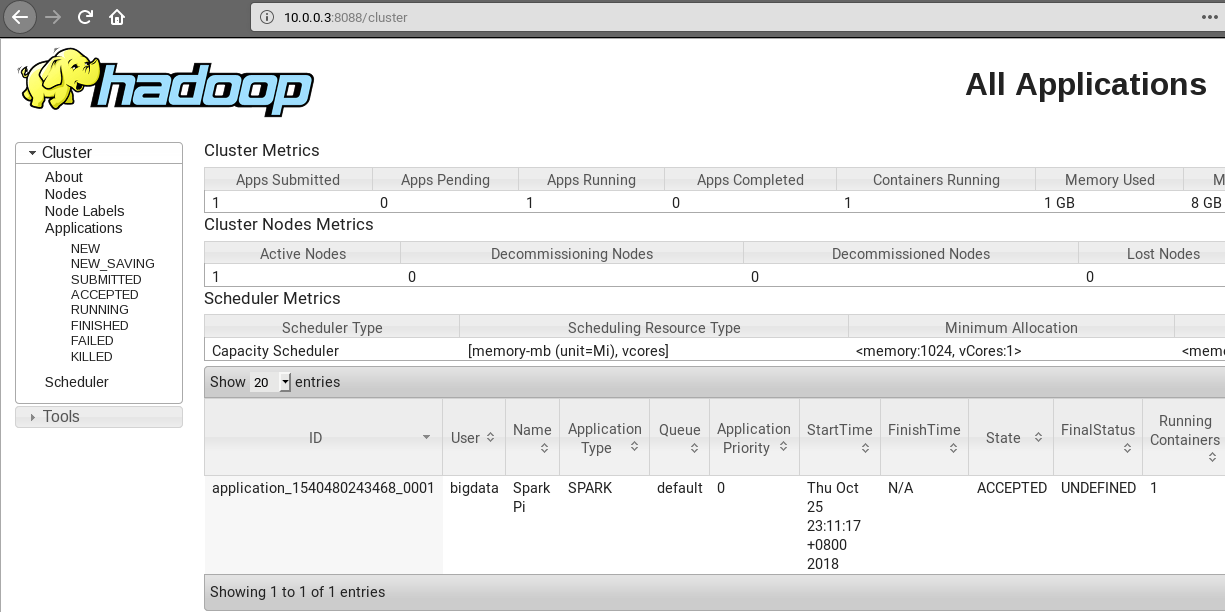
四.启动异常
1.Caused by: java.lang.ClassNotFoundException: org.slf4j.Logger异常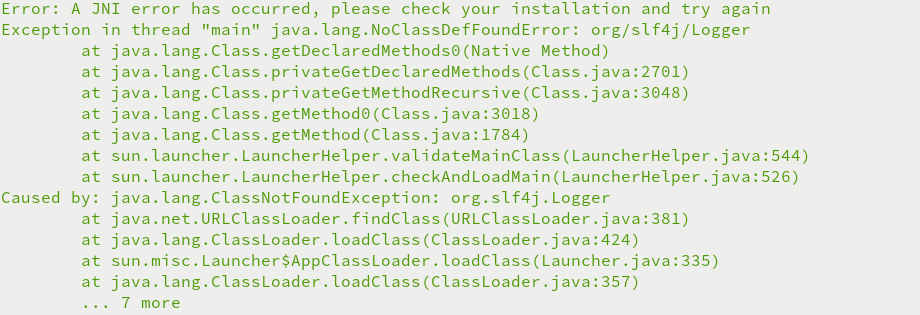
Hadoop和Spark独立安装,Spakr运行需要Hadoop,无SPARK_DIST_CLASSPATH变量,无法关联hadoop
编辑conf/spark-env.sh文件,配置SPARK_DIST_CLASSPATH变量
export SPARK_DIST_CLASSPATH=$(/home/bigdata/hadoop-3.1./bin/hadoop classpath)
2.Exception in thread "main" java.lang.Exception: When running with master 'yarn' either HADOOP_CONF_DIR or YARN_CONF_DIR must be set in the environment异常
Hadoop和Spark独立安装,Spakr运行需要Hadoop,无HADOOP_CONF_DIR变量,无法关联YARN
编辑conf/spark-env.sh文件,配置HADOOP_CONF_DIR变量
export HADOOP_CONF_DIR=/home/bigdata/hadoop-3.1./etc/hadoop
3.org.apache.spark.rpc.RpcEnvStoppedException: RpcEnv already stopped异常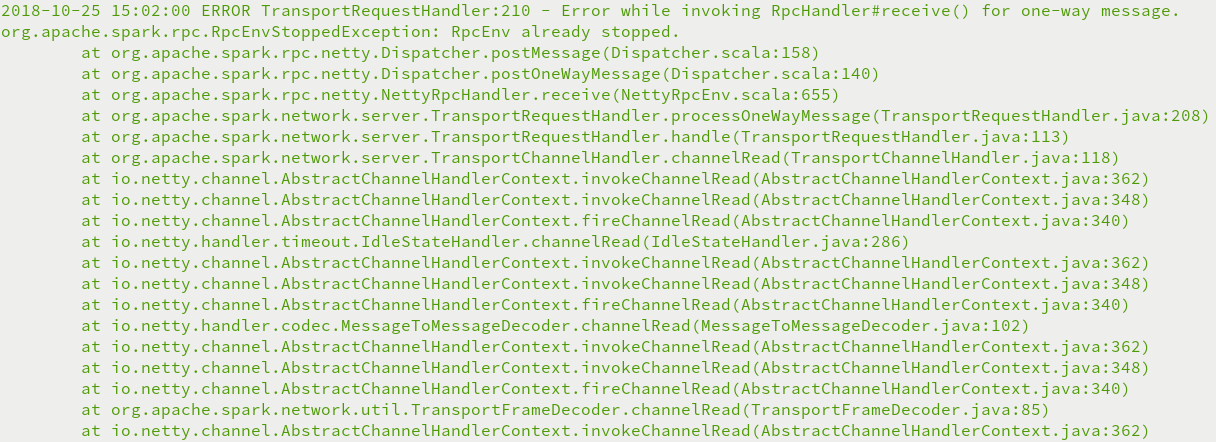
物理内存或者虚拟内存分配不够,Yarn直接杀死进程,需要禁止内存检查
编辑Hadoop中的etc/hadoop/yarn-site.xml文件,添加如下配置
    <property>

        <name>yarn.nodemanager.pmem-check-enabled</name>

        <value>false</value>

    </property>

    <property>

        <name>yarn.nodemanager.vmem-check-enabled</name>

        <value>false</value>

    </property>
4.env: 'python': No such file or directory错误
pyspark需要使用python,未配置PYSPARK_PYTHON变量
export PYSPARK_PYTHON=/usr/bin/python3.
Spark大数据平台安装教程的更多相关文章
- 【福利】送Spark大数据平台视频学习资料
没有套路真的是送!! 大家都知道,大数据行业spark很重要,那话我就不多说了,贴心的大叔给你找了份spark的资料. 多啰嗦两句,一个好的程序猿的基本素养是学习能力和自驱力.视频给了你们,能不能 ...
- 最新版大数据平台安装部署指南,HDP-2.6.5.0,ambari-2.6.2.0
一.服务器环境配置 1 系统要求 名称 地址 操作系统 root密码 Master1 10.1.0.30 Centos 7.7 Root@bidsum1 Master2 10.1.0.105 Cent ...
- GreenPlum 大数据平台--安装
1. 环境准备 01, 安装包准备: Greenplum : >>>>链接地址 Pgadmin客户端 : >>>链接地址 greenplum-cc-web ...
- Spark 大数据平台 Introduction part 2 coding
Basic Functions sc.parallelize(List(1,2,3,4,5,6)).map(_ * 2).filter(_ > 5).collect() *** res: Arr ...
- Spark 大数据平台
Apache Spark is an open source cluster computing system that aims to make data analytics fast - both ...
- 大数据平台R语言web UI应用架构 设计与开发
1. 系统拓扑图 在日常业务分析中,R是非常常用的分析工具,而当数据量较大时,用R语言需要需用更多的时间来完成训练模型,spark作为大规模数据处理框架,采用内存计算,可以短时间内完成大量的数据的处理 ...
- HDP 企业级大数据平台
一 前言 阅读本文前需要掌握的知识: Linux基本原理和命令 Hadoop生态系统(包括HDFS,Spark的原理和安装命令) 由于Hadoop生态系统组件众多,导致大数据平台多节点的部署,监控极其 ...
- 大数据平台搭建(hadoop+spark)
大数据平台搭建(hadoop+spark) 一.基本信息 1. 服务器基本信息 主机名 ip地址 安装服务 spark-master 172.16.200.81 jdk.hadoop.spark.sc ...
- Spark大型项目实战:电商用户行为分析大数据平台
本项目主要讲解了一套应用于互联网电商企业中,使用Java.Spark等技术开发的大数据统计分析平台,对电商网站的各种用户行为(访问行为.页面跳转行为.购物行为.广告点击行为等)进行复杂的分析.用统计分 ...
随机推荐
- [angularjs] angularjs系列笔记(一)简介
Angularjs通过新的属性和表达式扩展了html Andularjs 可以构建一个单一页面的应用程序(SPAS SinglePageApplications) Angularjs通过指令扩展了ht ...
- 月薪15k的测试员需要学习什么技术?
想了很久,决定还是要写一篇这样的文章出来,月薪15k的测试员需要学习什么技术?我觉得测试想要月薪15k并不难,只要做到我说的这几点肯定是可以的! 克服懒惰 我觉得,越是聪明的人越是觉得自己“懒惰”.大 ...
- Java 学习笔记 判断一个数组是否有序
思路 升序:每次比较数组中的两个数的时候,最大的数一定是前一个 降序: 每次比较数组中的两个数的时候,最小的数一定是前一个 Flag1和flag2都是假的时候,返回flase,否则,返回flase 代 ...
- Java学习笔记之——枚举类
枚举可以限定类的值只是有限个,例如:星期,只有星期一到星期天 语法案例:
- 记录使用Redis和nginx 实现一个简单的负载均衡(FB)
这两年在博客园看了不少大牛的分享,一直打算能写点什么东西. 之前偶然看见一个利用Redis 当作 Session数据宿主的demo,出处我已经找不到了.后来没事看了看nginx相关的东西.其中负载均衡 ...
- K8s helm 创建自定义Chart
# 删除之前创建的 chart helm list helm delete --purge redis1 # 创建自定义 chart myapp cd ~/helm helm create myapp ...
- kubernetes认证和serviceaccount
Service Account 为 Pod 提供必要的身份认证.所有的 kubernetes 集群中账户分为两类,Kubernetes 管理的 serviceaccount(服务账户) 和 usera ...
- 洛谷P4213 Sum(杜教筛)
题目描述 给定一个正整数N(N\le2^{31}-1)N(N≤231−1) 求ans_1=\sum_{i=1}^n\phi(i),ans_2=\sum_{i=1}^n \mu(i)ans1=∑i=1 ...
- 一种快速构造和获取URL查询参数的方法:URLSearchParams
URLSearchParams 接口定义了一些实用的方法来处理 URL 的查询字符串. URLSearchParams()是个构造函数,将返回一个可以操作查询字符串的对象. 常用方法: 1.构造查询字 ...
- Android滑动冲突解决
(1).场景一:外部滑动方向跟内部滑动方向不一致,比如外部左右滑动,内部上下滑动 ViewPager+Fragment配合使用,会有滑动冲突,但是ViewPager内部处理了这种滑动冲突 如果 ...