
章节十、3-CSS Selector---用CSS Selector - ID定位元素
一、如果元素的 ID 不唯一,或者是动态的,或者 name 以及 linktext 属性值也不唯一,对于这样的元素,我们 就需要考虑用 xpath或者css selector 来查找元素了,然后再对元素执行操作。
二、不管用什么方式查找元素,id、Name、Xpath、css—>都需要在页面上查找到唯一的元素。 都应该只找到一个匹配的 node(节点),除非想要查找一批元素放集合里,然后来操作集合。
三、css语法
标签名[属性 = '属性值']
tag[attribute='value']
以该页面input输入框为例写一个css:

标签名tag:input
属性attribute:id
属性值value:displayed-text
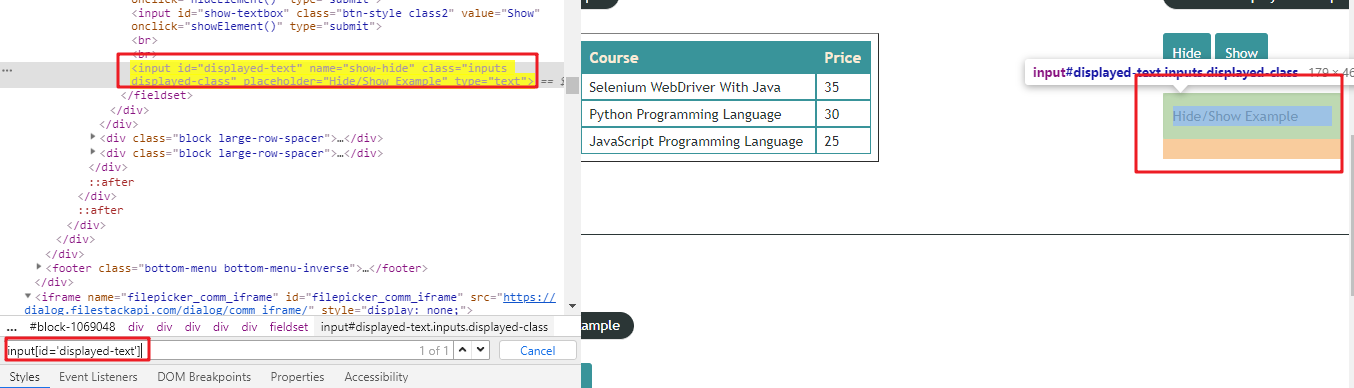
input[id='displayed-text']
四、简写
我们以该网址为例(https://learn.letskodeit.com/p/practice)
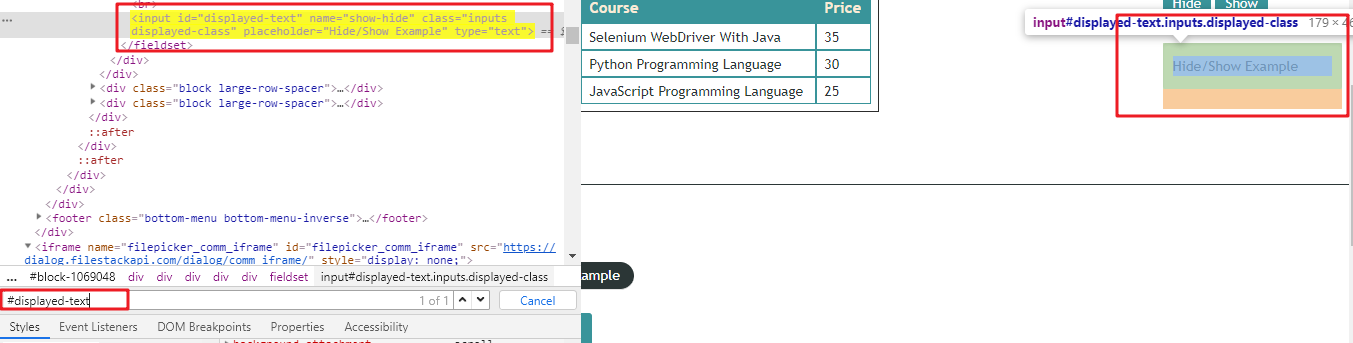
id的简写:“#”(input[id=displayed-text] 、#displayed-text、 input#displayed-text)
class的简写:“.”(input[class=displayed-class]、 .displayed-class、input.displayed-class)
1、直接使用css样式查找谷歌浏览器验证元素是否唯一:(input[id='displayed-text'])
2、使用#代表id直接查找(#displayed-text)
章节十、3-CSS Selector---用CSS Selector - ID定位元素的更多相关文章
- python+selenium:解决上传文件<input type='file'>标签属性被css的visibility隐藏导致无法定位元素的问题
要想上传文件,需要找到在HTML中<input type="file" />这个标签,有它就可以利用send_keys上传文件,不过这里的<input>元素 ...
- 『心善渊』Selenium3.0基础 — 8、使用CSS选择器定位元素
目录 1.CSS选择器介绍 2.CSS选择器定位语法 3.Selenium中使用CSS选择器定位元素 (1)通过属性定位元素 (2)通过标签定位元素 (3)通过层级关系定位元素 (4)通过索引定位元素 ...
- Python+Selenium 利用ID,XPath,tag name,link text,partial link text,class name,css,name定位元素
使用firefox浏览器,查看页面元素,我们以“百度网页”为示例 一.ID定位元素 利用find_element_by_id()方法来定位网页元素对象 ①.定位百度首页,输入框的元素 ②.编写示 ...
- Scrapy学习系列(一):网页元素查询CSS Selector和XPath Selector
这篇文章主要介绍创建一个简单的spider,顺便介绍一下对网页元素的选取方式(css selector, xpath selector). 第一步:创建spider工程 打开命令行运行以下命令: sc ...
- css selector regexp css选择器 正则表达式 css 参考手册
jQuery 选择元素 a.text-success, a.text-danger, a.text-primary, a.text-info $("a[class^=text-]" ...
- 第十四章 校本化CSS
CSS(层叠样式表)是一种指定HTML文档视觉的表现的标准.CSS本来是让视觉设计师来使用的:它允许设计师精确的对文档元素的字体 ,颜色,外边距,缩进,边框甚至是定位.不过,客户端javascript ...
- CSS规范--春风十里不如写好CSS
先吟几句: 最近看了看春风十里不如你,本来很少看剧的,暑假有点闲就看了,感觉不错,挺喜欢这部剧,就套了个名字,嘿嘿嘿.剧里面印象深刻的是<致橡树>这首诗,念几句: 我如果爱你,绝不像攀援的 ...
- Python之路【第十九篇】:前端CSS
CSS 一.CSS概述 CSS是Cascading Style Sheets的简称,中文称为层叠式样式表,用来控制网页数据的表现,可以使网页的表现与数据内容分离. 学CSS后我们需要掌握的技能: 1. ...
- 爬虫(十五):Scrapy框架(二) Selector、Spider、Downloader Middleware
1. Scrapy框架 1.1 Selector的用法 我们之前介绍了利用Beautiful Soup.正则表达式来提取网页数据,这确实非常方便.而Scrapy还提供了自己的数据提取方法,即Selec ...
随机推荐
- Redis缓存穿透、缓存雪崩和缓存击穿理解
1.缓存穿透(不存在的商品访问数据造成压力) 缓存穿透,是指查询一个数据库一定不存在的数据.正常的使用缓存流程大致是,数据查询先进行缓存查询,如果key不存在或者key已经过期,再对数据库进行查询,并 ...
- vue项目使用 prerender-spa-plugin 预渲染
由于项目要做seo优化,而用vue写成的spa页面谷歌浏览器等是抓取不到数据的.介于ssr和预渲染来说,后者相对来说要简单许多.所以采用了预渲染方式.采用插件prerender-spa-plugin使 ...
- IdentityServer4 知多少
1. 引言 现在的应用开发层出不穷,基于浏览器的网页应用,基于微信的公众号.小程序,基于IOS.Android的App,基于Windows系统的桌面应用和UWP应用等等,这么多种类的应用,就给应用的开 ...
- 如何在你的项目中集成 CAP【手把手视频教程】
前言 之前录制过一期关于CAP的视频,但是由于当时是直播时录制的视频,背景音比较杂所以质量有点差.这次的视频没有直播,直接录制的,视频质量会好很多,第一遍录制完成之后发现播放到一半没有声音,所以又重新 ...
- [Abp vNext 源码分析] - 文章目录
一.简要介绍 ABP vNext 是 ABP 框架作者所发起的新项目,截止目前 (2019 年 2 月 18 日) 已经拥有 1400 多个 Star,最新版本号为 v 0.16.0 ,但还属于预览版 ...
- 【工利其器】必会工具之(三)systrace篇(1)官网翻译
前言 Android 开发者官网中对systrace(Android System Trace)有专门的介绍,本篇文章作为systrace系列的开头,笔者先不做任何介绍,仅仅翻译一下官网的介绍.在后续 ...
- 【Android Studio安装部署系列】二十三、Android studio查看Gradle版本号
版权声明:本文为HaiyuKing原创文章,转载请注明出处! 概述 File——Project Structure 单击Project 可以看到,当前项目的gradle版本号是4.4. 参考资料 An ...
- NavUtils【底部虚拟导航栏工具类】
版权声明:本文为HaiyuKing原创文章,转载请注明出处! 前言 获取底部虚拟导航栏的高度值 效果图 代码分析 checkDeviceHasNavigationBar(Context context ...
- Python获取网络中的存活主机以及哪些主机是Linux
这个脚本用于扫描网络中的存活主机,通常在CMDB中自动获取主机的时候用到. #!/usr/bin/env python # -*- coding: utf-8 -*- ""&quo ...
- python默认编码设置
打开python 的gui,输入 1 2 import sys sys.getdefaultencoding() 查询系统当前默认编码 默认情况下显示编码方式为ASCII 在python安装目录下 ...