
pandas简单应用
机器学习离不开数据,数据分析离不开pandas。昨天感受了一下,真的方便。按照一般的使用过程,将pandas的常用方法说明一下。
首先,我们拿到一个excel表,我们将之另存为csv文件。因为文件是实验室的资源,我就不分享了。
首先是文件读取
def load_csv(filename):

    data=pd.read_csv(filename)

    data = data.drop(data.columns[39:], axis=1)

    return data
我们调用read_csv文件可以直接读取csv文件。其返回值为DataFrame。excel如果横向拖动太多的话,会生成很多空列。这里我们通过drop方法删掉39列之后的列。
然后pandas为了让显示美观,会在输出信息的时候自动隐藏数据。我们调整参数,使数据全部显示。
    pd.set_option('display.max_rows', 10)

    pd.set_option('display.max_columns', 500)

    pd.set_option('display.width', 500)
设置最多显示10行,500列。宽度为500.
使用 data.head()可以查看前4行的数据。
print(data.head())
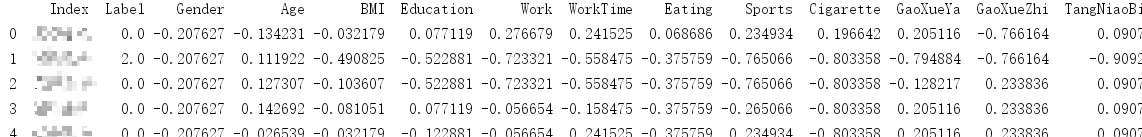
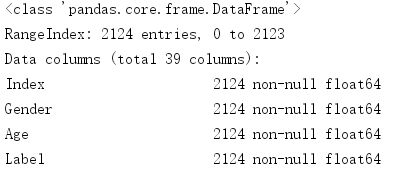
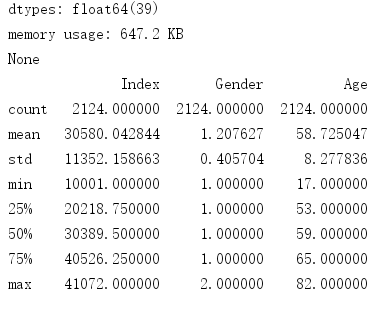
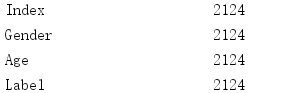
可以看到全部数据都被显示出来了。然后我们可以使用data.info() ,data.discribe()、data.count()查看数据的整体信息。
    print(data.info())

    print(data.describe())

    print(data.count())
data.info()显示的是:
data.describe()显示的是:
data.count()显示的是:
可以看到数据的值跨度很大,所以我们对数据进行normalization:
    keys=X.keys().tolist()

    keys.remove("Index")

    keys.remove("Label")

    for key in keys:

        #将数值范围限定在-0.5~0.5

        #normalize_col=(X[key]-(X[key].max()+X[key].min())/2)/(X[key].max()-X[key].min())

        #用mean来normolize

        normalize_col = (X[key] - X[key].mean()) / (X[key].max() - X[key].min())

        X = X.drop(key, axis=1)

        X[key]=normalize_col
我们可以通过keys中列名来有选择的进行归一化处理。
有时候,有的不和规范的数据我们想删掉:
    #删掉JiGan为-1的人

    data = data[data["JiGan"].isin([-1.0]) == False]
数据筛选还有其他函数,用到了在慢慢补充吧。
pandas简单应用的更多相关文章
- python之pandas简单介绍及使用(一)
python之pandas简单介绍及使用(一) 一. Pandas简介1.Python Data Analysis Library 或 pandas 是基于NumPy 的一种工具,该工具是为了解决数据 ...
- numpy和pandas简单使用
numpy和pandas简单使用 import numpy as np import pandas as pd 一维数据分析 numpy中使用array, pandas中使用series numpy一 ...
- 数据处理之pandas简单介绍
Offical Website :http://pandas.pydata.org/ 一:两种基本的数据类型结构 Series 和 DataFrame 先来看一下Series import panda ...
- [Python]Pandas简单入门(转)
本篇文章转自 https://colab.research.google.com/notebooks/mlcc/intro_to_pandas.ipynb?hl=zh-cn#scrollTo=zCOn ...
- Python Pandas 简单使用之 API熟悉
1.read_csv li_index = ['round_id', 'index', 'c-sequen' ] dataset = pd.read_csv(file, low_memory=Fals ...
- python pandas简单使用处理csv文件
这里jira.csv是个大文件 1) >>> import pandas >>> jir=pandas.read_csv(r'C:\Temp\jira.csv') ...
- \(\rm LightOJ 1371 - Energetic Pandas 简单计数+组合\)
http://www.lightoj.com/volume_showproblem.php?problem=1371 题意:给你n根竹子,和n只熊猫(XD),每个熊猫只能选择重量不大于它的竹子,问有几 ...
- Pandas简单操作(学习总结)
Pandas 的主要数据结构是 Series (一维数据)与 DataFrame(二维数据),是一个提供高性能.易于使用的数据结构和数据分析工具. 接下来查看Pandas的基本使用: # 导入模块 i ...
- Pandas模块:表计算与数据分析
目录 Pandas之Series Pandas之DataFrame 一.pandas简单介绍 1.pandas是一个强大的Python数据分析的工具包.2.pandas是基于NumPy构建的. 3.p ...
随机推荐
- Linux运维工程师面试-部分题库
一.Linux操作系统知识 1.常见的Linux发行版本都有什么?你最擅长哪一个?它的官网网站是什么?说明你擅长哪一块? 2.Linux开机启动流程详细步骤是什么?系统安装完,忘记密码如何破解? ...
- 代码管理(一)git
代码管理工具有很多 主要的有两个 git 和 svn svn 衍生出来的软件有 cornerstone smartSVN git 的图形界面工具有 Sourcetree 前几年 s ...
- 自定义 iPhone 铃声
1.iPhone 铃声格式 iPhone 的来电铃声时长限制为 40 秒,短信铃声时长限制为 25 秒,且 iOS5 及以上的系统才支持 m4r 格式的短信铃声. 2.自定义 iPhone 铃声 1) ...
- solrj索引操作
添加索引 Solr添加文档至索引: http://www.cnblogs.com/dennisit/p/3621717.html 删除索引: 每天索引记录有一个唯一标识,索引的删除通过唯一标识操作,如 ...
- 技术的正宗与野路子 c#, AOP动态代理实现动态权限控制(一) 探索基于.NET下实现一句话木马之asmx篇 asp.net core 系列 9 环境(Development、Staging 、Production)
黄衫女子的武功似乎与周芷若乃是一路,飘忽灵动,变幻无方,但举手抬足之间却是正而不邪,如说周芷若形似鬼魅,那黄衫女子便是态拟神仙. 这段描写出自<倚天屠龙记>第三十八回. “九阴神抓”本是& ...
- xtrabackup 源码安装
安装依赖包:这些依赖包必须要先安装好 # yum install cmake libaio-devel ncurses-devel bzip2-devel libxml2-devel libgcryp ...
- javascript的崛起及其生态元素
随着web的流行,人们花在浏览器上的时间吸引了巨头们对浏览器的重视,继而几年前富客户端概念,一批富客户端技术的涌现,如silverlight, flex等,曾经风起云涌,最终都败给了html5 和 j ...
- Groovy 学习手册(4)
6. 领域特定语言 Groovy 有许多特性,使它非常适合写DSL(领域特定语言).这些特性包活: 具有委托机制的闭包: 点号(.)和语句末尾的分号(;)是可选的: 运算符的重载(例如,加号,减号等) ...
- PostgreSQL创建数据库用户
注:版本不同,命令的执行路径可能有些不同. 一. 创建数据库用户freeswitch sudo -u postgres /usr/pgsql-9.5/bin/createuser -s -e free ...
- CentOS7 安装java 环境 摘抄
转http://www.diyhi.com/hostConfig.html 服务器环境配置 下面介绍全新安装的CentOS系统服务器安装配置商城软件服务环境的方法.演示主机操作系统为CentOS 7. ...