
【原创】Kafka console consumer源代码分析(一)
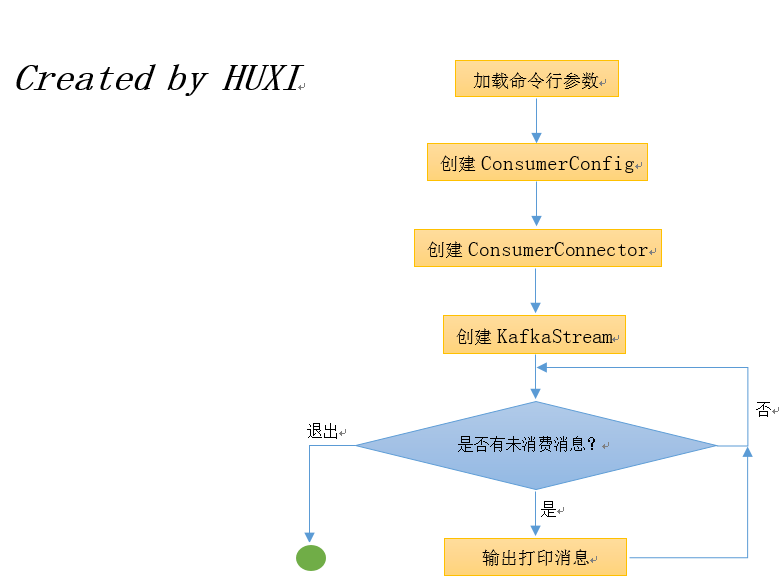
本质上来说,console consumer启动时会创建一个KafkaStream(可以简单翻译成Kafak流),该stream会不停地等待可消费的新消息——具体做法就是通过LinkedBlockingQueue阻塞队列来实现,后续会有详细描述。针对上面启动的顺序列表,我们在ConsoleConsumer.scala中逐一进行代码走读:
 // REQUIRED表示这是一个必须要指定的参数

 val zkConnectOpt = parser.accepts("zookeeper", "REQUIRED: The connection string for the zookeeper connection in the form host:port. " +

     "Multiple URLS can be given to allow fail-over.").withRequiredArg.describedAs("urls").ofType(classOf[String])
2. 生成group.id
 // 如果没有显式指定group.id,那么代码就自己合成一个

 // 具体格式: console-consumer-[10万以内的一个随机数]

 // 10万是一个很大的数,因此只有非常低的几率会碰到多个console consumer的group id相同的情况

 if(!consumerProps.containsKey("group.id")) {

       consumerProps.put("group.id","console-consumer-" + new Random().nextInt(100000))

       groupIdPassed=false

 }
3. 创建ConsumerConfig对象封装配置
确定了consumer的group.id之后console consumer需要把传入参数封装进ConsumerConfig类中并把后者传给Consumer的create方法以构造一个ConsumerConnector——即初始化consumer了,具体逻辑见下面的代码:
 val config = new ConsumerConfig(consumerProps) // 封装ConsumerConfig配置类

 val skipMessageOnError = if (options.has(skipMessageOnErrorOpt)) true else false
4. 创建默认的消息格式化类,其定义的writeTo方法会默认将消息输出到控制台
 val messageFormatterClass = Class.forName(options.valueOf(messageFormatterOpt))  // 创建消息格式类,用于最后的输出显示

 val formatterArgs = CommandLineUtils.parseKeyValueArgs(options.valuesOf(messageFormatterArgOpt))

 val maxMessages = if(options.has(maxMessagesOpt)) options.valueOf(maxMessagesOpt).intValue else -1
5. 创建ZookeeperConsumerConnector
ZookeeperConsumerConnector非常重要,它实现了ConsumerConnector接口(该接口定义了创建KafkaStream和提交位移的操作,如createMessageStreams、commitOffsets等)。Kakfa官网把这个接口称为high level的consumer API。对于大多数consumer来说,这个high level的consumer API提供的功能已经足够了。不过很多用户可能需要对位移有更大的控制,这个时候Kafka推荐用户使用被称为low level的consumer API—— SimpleConsumer。大家参考这篇文章来深入学习high level API的用法。目前为止,我们只需要知道Kafka通过下面的语句构建了ConsumerConnector这个consumer的核心接口:
val connector = Consumer.create(config) // 创建ConsumerConnector,Consumer核心接口
 val stream = connector.createMessageStreamsByFilter(filterSpec, 1, new DefaultDecoder(), new DefaultDecoder()).get(0)

 val iter = if(maxMessages >= 0)

     stream.slice(0, maxMessages)

 else

     stream
 for(messageAndTopic <- iter) {

     try {

         formatter.writeTo(messageAndTopic.key, messageAndTopic.message, System.out) // 输出到控制台

         numMessages += 1

     } catch { ... }

     ...

 }
好了,至此我们按照启动顺序概述了console consumer启动时的各个阶段。不过,ZookeeperConsumerConnector和创建和迭代器的实现我们并未详细展开,这部分内容将作为后面续篇的内容呈现给大家。敬请期待!
【原创】Kafka console consumer源代码分析(一)的更多相关文章
- 【原创】Kafka console consumer源代码分析(二)
我们继续讨论console consumer的实现原理,本篇着重探讨ZookeeperConsumerConnector的使用,即后续所有的内容都由下面这条语句而起: val connector = ...
- 【原创】kafka consumer源代码分析
顾名思义,就是kafka的consumer api包. 一.ConsumerConfig.scala Kafka consumer的配置类,除了一些默认值常量及验证参数的方法之外,就是consumer ...
- 【原创】Kakfa utils源代码分析(三)
Kafka utils包最后一篇~~~ 十五.ShutdownableThread.scala 可关闭的线程抽象类! 继承自Thread同时还接收一个boolean变量isInterruptible表 ...
- 【原创】Kakfa utils源代码分析(二)
我们继续研究kafka.utils包 八.KafkaScheduler.scala 首先该文件定义了一个trait:Scheduler——它就是运行任务的一个调度器.任务调度的方式支持重复执行的后台任 ...
- 【原创】Kakfa utils源代码分析(一)
Kafka.utils,顾名思义,就是一个工具套件包,里面的类封装了很多常见的功能实现——说到这里,笔者有一个感触:当初为了阅读Kafka源代码而学习了Scala语言,本以为Kafka的实现会用到很多 ...
- Kafka 源代码分析之LogManager
这里分析kafka 0.8.2的LogManager logmanager是kafka用来管理log文件的子系统.源代码文件在log目录下. 这里会逐步分析logmanager的源代码.首先看clas ...
- Kafka 0.10 SocketServer源代码分析
1概要设计 Kafka SocketServer是基于Java NIO来开发的,采用了Reactor的模式,其中包含了1个Acceptor负责接受客户端请求,N个Processor负责读写数据,M个H ...
- Spark SQL 源代码分析之 In-Memory Columnar Storage 之 in-memory query
/** Spark SQL源代码分析系列文章*/ 前面讲到了Spark SQL In-Memory Columnar Storage的存储结构是基于列存储的. 那么基于以上存储结构,我们查询cache ...
- Spark SQL Catalyst源代码分析之TreeNode Library
/** Spark SQL源代码分析系列文章*/ 前几篇文章介绍了Spark SQL的Catalyst的核心执行流程.SqlParser,和Analyzer,本来打算直接写Optimizer的,可是发 ...
随机推荐
- 推荐升级ASP.NET Web API 2
ASP.NET Web API 使用很长时间了,期间也碰到不少问题,升级到WebAPI2后这些问题都解决了,稳定性方面也提升不少,所以推荐使用.碰到的问题是下面的2类: 1.multipart/for ...
- Metrics.NET 项目
Metrics.NET(https://github.com/etishor/Metrics.NET)是一个给CLR 提供度量工具的包,它是移植自Java的metrics,在c#代码中嵌入Metric ...
- 剑指Offer面试题:26.字符串的排列
一.题目:字符串的排列 题目:输入一个字符串,打印出该字符串中字符的所有排列.例如输入字符串abc,则打印出由字符a.b.c所能排列出来的所有字符串abc.acb.bac.bca.cab和cba. 二 ...
- 【译】ASP.NET应用程序和页面生命周期
为何翻译此文 一.此文是Code Project社区2010年4月ASP.NET板块的最佳文章,说明了此文的份量: 二.锻炼自己的英文技术文章翻译能力,提高英文技术文档阅读能力: 三.了解掌握ASP. ...
- 从零3D基础入门XNA 4.0(1)——3D开发基础
[题外话] 最近要做一个3D动画演示的程序,由于比较熟悉C#语言,再加上XNA对模型的支持比较好,故选择了XNA平台.不过从网上找到很多XNA的入门文章,发现大都需要一些3D基础,而我之前并没有接触过 ...
- Windows Azure Storage (23) 计算Azure VHD实际使用容量
<Windows Azure Platform 系列文章目录> 对于A系列和D系列的虚拟机来说,使用的是普通存储. 普通存储的存储资源,是按照每GB每月计费的.Microsoft Azur ...
- C语言 · 冒泡排序
for(int k=0;k<N;k++) { for(int j=k+1;j<N;j++){ if(a[k]>a[j]){ int t = a[k]; a ...
- SqlServer2008安装时提示重启计算机失败 解决办法
问题描述: 在安装Sql Server 2008时提示重启计算机,重启之后不行,仍需要重启计算机. 如下图所示: 解决方法: 1.运行(或按键盘Win+R 组合键),输入regedit,调出注册表管理 ...
- 解决 PLSQL Developer无法连接数据库
问题:PLSQL Developer无法连接数据库 原因:PLSQL Developer不支持x64的Oracle客户端 解决方案:1.下载instantclient-basic-nt-12.1.0. ...
- 使用批处理设置JDK环境变量(Win7可用,新版本)
欢迎探讨,如有错误敬请指正 如需转载,请注明出处http://www.cnblogs.com/nullzx/ 1. JDK环境的设置 一般情况下来说按照网上大多数的教程设置JDK的环境变量即可.但对于 ...