
Hive-mapjoin详解(mapjoin原理)
笼统的说,Hive中的Join可分为Common Join(Reduce阶段完成join)和Map Join(Map阶段完成join)。本文简单介绍一下两种join的原理和机制。
一 .Common Join
如果不指定MapJoin或者不符合MapJoin的条件,那么Hive解析器会将Join操作转换成Common Join,即在Reduce阶段完成join。
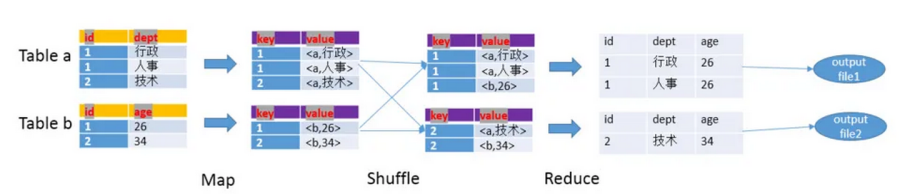
Common Join整个过程包含Map、Shuffle、Reduce阶段。
Map阶段
读取源表的数据,Map输出时候以Join on条件中的列为key,如果Join有多个关联键,则以这些关联键的组合作为key;
Map输出的value为join之后所关心的(select或者where中需要用到的)列;同时在value中还会包含表的Tag信息,用于标明此value对应哪个表;
按照key进行排序
Shuffle阶段
根据key的值进行hash,并将key/value按照hash值推送至不同的reduce中,这样确保两个表中相同的key位于同一个reduce中。
Reduce阶段
根据key的值完成join操作,期间通过Tag来识别不同表中的数据。
以下面的HQL为例,图解其过程:
SELECT
a.id,a.dept,b.age
FROM a join b
ON (a.id = b.id);
二. Map Join
MapJoin就是在Map阶段进行表之间的连接,map阶段直接拿另外一个表的数据和内存中表数据做匹配。而不需要进入到Reduce阶段才进行连接,可以避免传统的排序和归并操作,这样就节省了在Shuffle阶段时要进行的大量数据传输,从而起到了优化作业的作用。
MapJoin通常用于一个很小的表和一个大表进行join的场景,具体小表有多小,由参数 hive.mapjoin.smalltable.filesize来决定,该参数表示小表的总大小,默认值为25000000字节,即25M。
Hive0.7之前,需要使用hint提示 /* + mapjoin(table) */才会执行MapJoin,否则执行Common Join,但在0.7版本之后,默认自动会转换Map Join,由数 hive.auto.convert.join来控制,默认为true.
假设a表为一张大表,b为小表,并且hive.auto.convert.join=true,那么Hive在执行时候会自动转化为MapJoin。
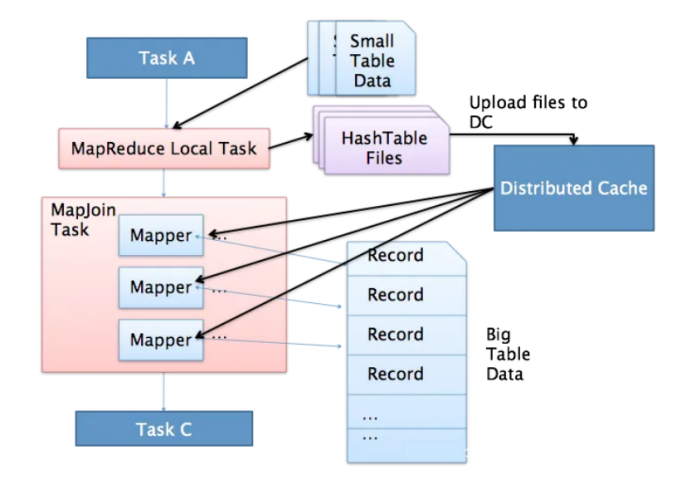
执行流程如下:
1.通过MapReduce Local Task,将小表读入内存,生成HashTableFiles上传至Distributed Cache中,这里会对HashTableFiles进行压缩。
2.MapReduce Job在Map阶段,每个Mapper从Distributed Cache读取HashTableFiles到内存中,顺序扫描大表,在Map阶段直接进行Join,将数据传递给下一个MapReduce任务。
commen join 时map段会有sort order 排序的功能,但是在mapioin 时map 段不会sort。
(sort指的是在map阶段时进行局部的排序,order指的是在reduce阶段时进行的全局排序)
三. 总结
- mapioin 可以看做 boardcast join 就是将小表的数据加载到内存中并且没有shuffle过程,加快处理效率,但是这样如果数据量过大,加载到内存有可能会引起OOM。
- 普通join 会产生shuffle,会影响效率(数据传输),也能产生数据倾斜 (一个key太多,那任务处理就会很慢)。
Hive-mapjoin详解(mapjoin原理)的更多相关文章
- hive beeline详解
Hive客户端工具后续将使用Beeline 替代HiveCLI ,并且后续版本也会废弃掉HiveCLI 客户端工具,Beeline是 Hive 0.11版本引入的新命令行客户端工具,它是基于SQLLi ...
- 线段树详解 (原理,实现与应用)(转载自:http://blog.csdn.net/zearot/article/details/48299459)
原文地址:http://blog.csdn.net/zearot/article/details/48299459(如有侵权,请联系博主,立即删除.) 线段树详解 By 岩之痕 目录: 一:综述 ...
- 丰富图文详解B-树原理,从此面试再也不慌
本文始发于个人公众号:TechFlow,原创不易,求个关注 本篇原计划在上周五发布,由于太过硬核所以才拖到了这周五.我相信大家应该能从标题当中体会到这个硬核. 周五的专题是大数据和分布式,我最初的打算 ...
- HIVE 配置文件详解
hive的配置: hive.ddl.output.format:hive的ddl语句的输出格式,默认是text,纯文本,还有json格式,这个是0.90以后才出的新配置: hive.exec.scri ...
- Hive 配置项详解
hive.ddl.output.format: hive的ddl语句的输出格式, 默认是text,纯文本,还有json格式,这个是0.90以后才出的新配置: hive.exec.script.wrap ...
- P2P技术详解(一):NAT详解——详细原理、P2P简介
1. IPv4协议和NAT的由来 今天,无数快乐的互联网用户在尽情享受Internet带来的乐趣.他们浏览新闻,搜索资料,下载软件,广交新朋,分享信息,甚至于足不出户获取一切日用所需.企业利用互联网发 ...
- Percona-xtrabackup 使用详解与原理
现在有个需求需要对使用 innodb 的数据库进行热备.网上查了很多工具皆推荐 Percona-xtrabackup 于是就仔细了解调研一番. 我们可以前往 https://www.percona.c ...
- Hive安装配置指北(含Hive Metastore详解)
个人主页: http://www.linbingdong.com 本文介绍Hive安装配置的整个过程,包括MySQL.Hive及Metastore的安装配置,并分析了Metastore三种配置方式的区 ...
- ThreadLocal类详解:原理、源码、用法
以下是本文目录: 1.从数据库连接探究 ThreadLocal 2.剖析 ThreadLocal 源码 3. ThreadLocal 应用场景 4. 通过面试题理解 ThreadLocal 1.从数据 ...
- 使用java连接hive,并执行hive语句详解
安装hadoop 和 hive我就不多说了,网上太多文章 自己看去 首先,在机器上打开hiveservice hive --service hiveserver -p 50000 & 打开50 ...
随机推荐
- 【新手友好】用Pyspark和GraphX解析复杂网络数据
从零开始 在本文中,我们将详细介绍如何在Python / pyspark环境中使用graphx进行图计算.GraphX是Spark提供的图计算API,它提供了一套强大的工具,用于处理和分析大规模的图数 ...
- sipp3.6 on centos7安装部署
概述 在VOIP软交换的开发过程中,必然需要对软交换进行批量压测. SIP压测工具一般都是sipp,免费,开源,功能足够强大,配置灵活,优点多. 环境 centos7.9 cmake3.6 sipp ...
- java基础-集合-day14
目录 1. 数据结构 算法 2. 本章的重点 集合 3. collections 4. list 5. 泛型 6. 泛型通配符 7. linkedList 8. 模拟linkedList源码 --面试 ...
- centos7_Lnmp编译安装
17年面试运维岗位的时候,面试官要求输出一份lnmp编译的操作文档,于是有了如下安装nginx+php+mysql,进入正题: 准备环境 环境:centos7.3 软件:nginx-1.12.1 + ...
- 安装MicroStation软件、Terrasolid插件的方法
本文介绍在Win10电脑中,安装MicroStation软件与Terrasolid插件合集的详细方法. 首先,我们需要有MicroStation软件与Terrasolid插件合集的安装包:这些 ...
- 26-IP调用 - PLL
1.PLL IP核简介 PLL(Phaze Locked Loop)锁相环是最常用的IP核之一,其性能强大,可以对输入到FPGA的时钟信号进行任意的分频.倍频.相位调整.占空比调整,从而输出一个期望时 ...
- Oceanbase开源版 数据库恢复MySQL数据库的过程
# Oceanbase开源版 数据库恢复MySQL数据库的过程 背景 想进行一下Oceanbase数据库的兼容性验证. 想着用app create 数据库的方式周期比较长. 所以我想着换一套 备份恢复 ...
- [转帖]资料整理——Oracle版本历史(很全面)(Releases and versions of Oracle Database)
资料来源: https://en.wikipedia.org/wiki/Oracle_Database Oracle Database Version Initial Release Version ...
- [转帖]在yum安装本地rpm文件时遇到public key不正确问题
yum错误:public.gpg.key: import read failed(2). 在yum安装本地rpm文件时遇到public key不正确问题 Downloading Packages: ...
- [转帖]Jmeter插件之ServerAgent服务器性能监控工具的安装和使用
https://www.cnblogs.com/pachongshangdexuebi/p/13354201.html 一.前言 性能测试时我们关注的重要指标是:并发用户数,TPS,请求成功率, ...