
带你认识一下多模态对比语言图像预训练CLIP
本文分享自华为云社区《多模态对比语言图像预训练CLIP:打破语言与视觉的界限》,作者:汀丶。
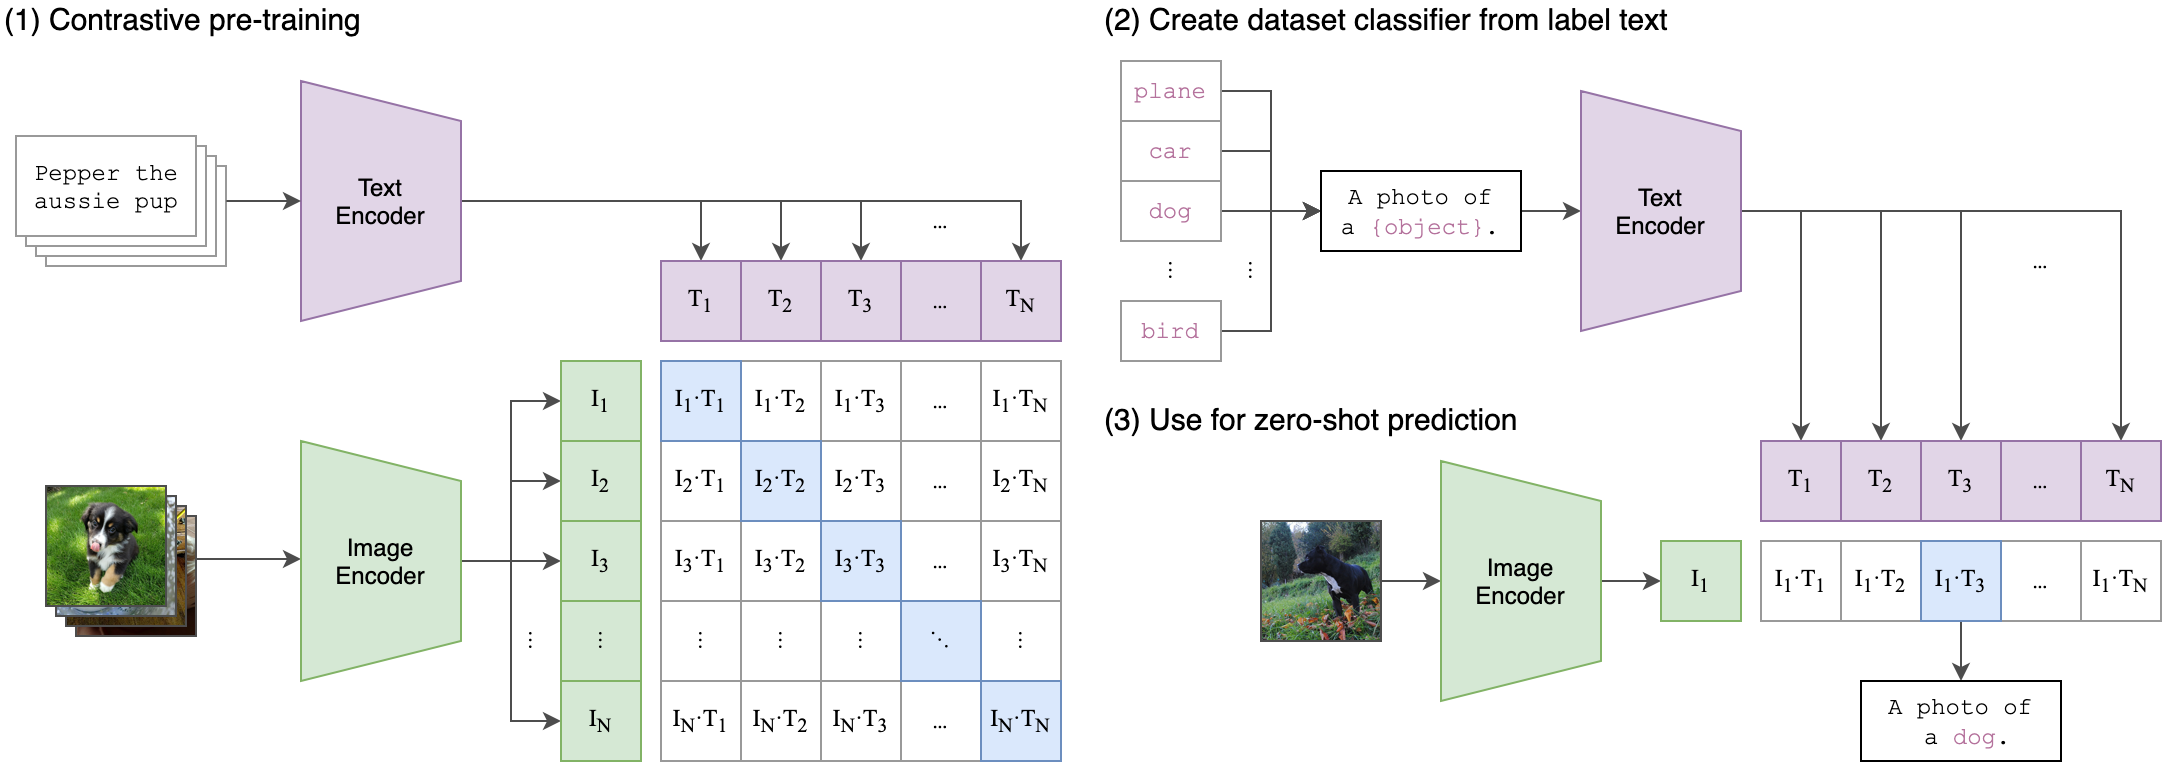
一种基于多模态(图像、文本)对比训练的神经网络。它可以在给定图像的情况下,使用自然语言来预测最相关的文本片段,而无需为特定任务进行优化。CLIP的设计类似于GPT-2和GPT-3,具备出色的零射击能力,可以应用于多种多模态任务。
- 多模态对比语言图像预训练(CLIP)是一种神经网络模型,它通过多模态对比训练来学习图像和文本之间的关联。与传统的单模态预训练模型不同,CLIP能够同时处理图像和文本,从而更好地理解它们之间的语义关系。
- CLIP的设计类似于GPT-2和GPT-3,是一种自回归语言模型。它通过对比学习来学习图像和文本之间的映射关系。在训练过程中,CLIP会接收一张图像和一个与之相关的文本片段,并学习如何将这两个模态的信息进行关联。通过这种方式,CLIP可以学会将图像与相应的文本片段进行匹配,从而在给定图像的情况下,使用自然语言来预测最相关的文本片段。
- 由于CLIP采用了对比学习的方法,它可以在无需为特定任务进行优化的前提下,表现出色地完成多种多模态任务。这使得CLIP成为了一种通用的多模态预训练模型,可以广泛应用于图像标注、视觉问答、图像生成等领域。
CLIP(对比语言图像预训练)是一种基于多种(图像、文本)对进行训练的神经网络。在给定图像的情况下,它可以用自然语言来预测最相关的文本片段,而无需直接针对任务进行优化,类似于GPT-2和gpt - 3的零射击能力。我们发现CLIP在不使用任何原始的1.28M标记示例的情况下,在ImageNet“零射击”上匹配原始ResNet50的性能,克服了计算机视觉中的几个主要挑战。
1.安装
ftfy

regex

tqdm

torch

torchvision

$ conda install --yes -c pytorch pytorch=1.7.1 torchvision cudatoolkit=11.0

$ pip install ftfy regex tqdm

$ pip install git+https://github.com/openai/CLIP.git
Replace cudatoolkit=11.0 above with the appropriate CUDA version on your machine or cpuonly when installing on a machine without a GPU.
import torch

import clip

from PIL import Image

device = "cuda" if torch.cuda.is_available() else "cpu"

model, preprocess = clip.load("ViT-B/32", device=device)

image = preprocess(Image.open("CLIP.png")).unsqueeze(0).to(device)

text = clip.tokenize(["a diagram", "a dog", "a cat"]).to(device)

with torch.no_grad():

image_features = model.encode_image(image)

text_features = model.encode_text(text)

logits_per_image, logits_per_text = model(image, text)

probs = logits_per_image.softmax(dim=-1).cpu().numpy()

print("Label probs:", probs) # prints: [[0.9927937 0.00421068 0.00299572]]
- API
The CLIP module clip provides the following methods:
- clip.available_models()
Returns the names of the available CLIP models.
- clip.load(name, device=..., jit=False)
返回模型和模型所需的TorchVision转换,由’ clip.available_models() ‘返回的模型名指定。它将根据需要下载模型。’ name '参数也可以是本地检查点的路径。
可以选择性地指定运行模型的设备,默认是使用第一个CUDA设备(如果有的话),否则使用CPU。当’ jit ‘为’ False '时,将加载模型的非jit版本。
- clip.tokenize(text: Union[str, List[str]], context_length=77)
返回一个LongTensor,其中包含给定文本输入的标记化序列。这可以用作模型的输入
’ clip.load() '返回的模型支持以下方法:
- model.encode_image(image: Tensor)
给定一批图像,返回由CLIP模型的视觉部分编码的图像特征。
- model.encode_text(text: Tensor)
给定一批文本tokens,返回由CLIP模型的语言部分编码的文本特征。
- model(image: Tensor, text: Tensor)
给定一批图像和一批文本标记,返回两个张量,包含对应于每个图像和文本输入的logit分数。其值是对应图像和文本特征之间的相似度的余弦值,乘以100。
2.案例介绍
2.1 零样本能力
下面的代码使用CLIP执行零样本预测,如本文附录B所示。本例从CIFAR-100数据集获取图像,并在数据集的100个文本标签中预测最可能的标签。
import os

import clip

import torch

from torchvision.datasets import CIFAR100

#Load the model

device = "cuda" if torch.cuda.is_available() else "cpu"

model, preprocess = clip.load('ViT-B/32', device)

#Download the dataset

cifar100 = CIFAR100(root=os.path.expanduser("~/.cache"), download=True, train=False)

#Prepare the inputs

image, class_id = cifar100[3637]

image_input = preprocess(image).unsqueeze(0).to(device)

text_inputs = torch.cat([clip.tokenize(f"a photo of a {c}") for c in cifar100.classes]).to(device)

#Calculate features

with torch.no_grad():

image_features = model.encode_image(image_input)

text_features = model.encode_text(text_inputs)

#Pick the top 5 most similar labels for the image

image_features /= image_features.norm(dim=-1, keepdim=True)

text_features /= text_features.norm(dim=-1, keepdim=True)

similarity = (100.0 * image_features @ text_features.T).softmax(dim=-1)

values, indices = similarity[0].topk(5)

#Print the result

print("\nTop predictions:\n")

for value, index in zip(values, indices):

print(f"{cifar100.classes[index]:>16s}: {100 * value.item():.2f}%")
输出将如下所示(具体数字可能因计算设备的不同而略有不同):
Top predictions:

snake: 65.31%

turtle: 12.29%

sweet_pepper: 3.83%

lizard: 1.88%

crocodile: 1.75%
Note that this example uses the encode_image() and encode_text() methods that return the encoded features of given inputs.
2.2 Linear-probe 评估
The example below uses scikit-learn to perform logistic regression on image features.
import os

import clip

import torch

import numpy as np

from sklearn.linear_model import LogisticRegression

from torch.utils.data import DataLoader

from torchvision.datasets import CIFAR100

from tqdm import tqdm

#Load the model

device = "cuda" if torch.cuda.is_available() else "cpu"

model, preprocess = clip.load('ViT-B/32', device)

#Load the dataset

root = os.path.expanduser("~/.cache")

train = CIFAR100(root, download=True, train=True, transform=preprocess)

test = CIFAR100(root, download=True, train=False, transform=preprocess)

def get_features(dataset):

all_features = []

all_labels = []

with torch.no_grad():

for images, labels in tqdm(DataLoader(dataset, batch_size=100)):

features = model.encode_image(images.to(device))

all_features.append(features)

all_labels.append(labels)

return torch.cat(all_features).cpu().numpy(), torch.cat(all_labels).cpu().numpy()

#Calculate the image features

train_features, train_labels = get_features(train)

test_features, test_labels = get_features(test)

#Perform logistic regression

classifier = LogisticRegression(random_state=0, C=0.316, max_iter=1000, verbose=1)

classifier.fit(train_features, train_labels)

#Evaluate using the logistic regression classifier

predictions = classifier.predict(test_features)

accuracy = np.mean((test_labels == predictions).astype(float)) * 100.

print(f"Accuracy = {accuracy:.3f}")
Note that the C value should be determined via a hyperparameter sweep using a validation split.
3.更多资料参考
- OpenCLIP: includes larger and independently trained CLIP models up to ViT-G/14
- Hugging Face implementation of CLIP: for easier integration with the HF ecosystem
带你认识一下多模态对比语言图像预训练CLIP的更多相关文章
- html标记语言 --图像标记
html标记语言 --图像标记 三.图像标记 1.使用方法 <img src="路径/文件名.格式" width="属性值" height="属 ...
- 【中文版 | 论文原文】BERT:语言理解的深度双向变换器预训练
BERT:Pre-training of Deep Bidirectional Transformers for Language Understanding 谷歌AI语言组论文<BERT:语言 ...
- CNN基础二:使用预训练网络提取图像特征
上一节中,我们采用了一个自定义的网络结构,从头开始训练猫狗大战分类器,最终在使用图像增强的方式下得到了82%的验证准确率.但是,想要将深度学习应用于小型图像数据集,通常不会贸然采用复杂网络并且从头开始 ...
- C语言中预定义符 __FILE__, __LINE__, __FUNCTION__, __DATE__, __TIME__ 的使用演示
本文演示了C语言中预定义符 __FILE__, __LINE__, __FUNCTION__, __DATE__, __TIME__ 的使用. 这几个预定义符的名称就没必要再介绍了,顾名思义嘛. // ...
- [Swift通天遁地]九、拔剑吧-(12)创建Preview-Transition图像预览界面
★★★★★★★★★★★★★★★★★★★★★★★★★★★★★★★★★★★★★★★★➤微信公众号:山青咏芝(shanqingyongzhi)➤博客园地址:山青咏芝(https://www.cnblogs. ...
- Docs-.NET-C#-指南-语言参考-预处理器指令:#pragma checksum(C# 参考)
ylbtech-Docs-.NET-C#-指南-语言参考-预处理器指令:#pragma checksum(C# 参考) 1.返回顶部 1. #pragma checksum(C# 参考) 2015/0 ...
- Docs-.NET-C#-指南-语言参考-预处理器指令:#pragma warning(C# 参考)
ylbtech-Docs-.NET-C#-指南-语言参考-预处理器指令:#pragma warning(C# 参考) 1.返回顶部 1. #pragma warning(C# 参考) 2015/07/ ...
- Docs-.NET-C#-指南-语言参考-预处理器指令:#pragma(C# 参考)
ylbtech-Docs-.NET-C#-指南-语言参考-预处理器指令:#pragma(C# 参考) 1.返回顶部 1. #pragma(C# 参考) 2015/07/20 #pragma 为编译器给 ...
- Docs-.NET-C#-指南-语言参考-预处理器指令:#endregion(C# 参考)
ylbtech-Docs-.NET-C#-指南-语言参考-预处理器指令:#endregion(C# 参考) 1.返回顶部 1. #endregion(C# 参考) 2015/07/20 #endreg ...
- Docs-.NET-C#-指南-语言参考-预处理器指令:#region(C# 参考)
ylbtech-Docs-.NET-C#-指南-语言参考-预处理器指令:#region(C# 参考) 1.返回顶部 1. #region(C# 参考) 2015/07/20 利用 #region,可以 ...
随机推荐
- CF276C
题目简化和分析: 属于一种贪心思维,我们想如果要使得和最大,那么就必须保证最大的数乘的次数越多越好,并且排序没有限制,快速累加每个位置出现的次数,所以应该使用线段树差分. 然后排序最大乘最大累加. S ...
- centos服务器搭建https
一.环境 OS:CentOS Linux release 8.2.2004 (Core) 硬件:某外网云服务器虚拟机 二.安装命令 1.安装nginx yum install nginx 2.安装签发 ...
- Python自动化处理Excel数据
需求描述:数据格式如下所示,需要分离出2023年7月1号之后的数据明细 数据核对与处理:从Excel文件中提取特定日期后的签收数据 1. 引言 在实际数据处理和分析过程中,经常会遇到需要从大量数据中提 ...
- 2023-11-08:用go语言,字符串哈希原理和实现 比如p = 233, 也就是课上说的选择的质数进制 “ 3 1 2 5 6 ...“ 0 1 2 3 4 hash[0] = 3 * p的0
2023-11-08:用go语言,字符串哈希原理和实现 比如p = 233, 也就是课上说的选择的质数进制 " 3 1 2 5 6 ..." 0 1 2 3 4 hash[0] = ...
- DOT 学习笔记
开始大恶补图论了. 说句闲话,\(\text{ODT}\) 和 \(\text{DOT}\). \(\text{DOT}\),全称「树上启发式合并(\(\text{dsu on tree}\))」,乍 ...
- 文心一言 VS 讯飞星火 VS chatgpt (136)-- 算法导论11.3 2题
二.用go语言,假设将一个长度为r的字符串散列到m 个槽中,并将其视为一个以 128 为基数的数,要求应用除法散列法.我们可以很容易地把数 m 表示为一个 32 位的机器字,但对长度为r的字符串,由于 ...
- 又欲又撩人,基于新版Bert-vits2V2.0.2音色模型雷电将军八重神子一键推理整合包分享
Bert-vits2项目近期炸裂更新,放出了v2.0.2版本的代码,修正了存在于2.0先前版本的重大bug,并且重炼了底模,本次更新是即1.1.1版本后最重大的更新,支持了三语言训练及混合合成,并且做 ...
- 一文彻底看懂Python切片
1.什么是切片 切片是Python中一种用于操作序列类型(如列表.字符串和元组)的方法.它通过指定起始索引和结束索引来截取出序列的一部分,形成一个新的序列.切片是访问特定范围内的元素,就是一个Area ...
- 3C智能移动周边产品龙头企业如何集成企业内部所有异构系统数据
全面并自动集成品胜集团全域业务系统中的各类业务数据:结构化.标准化.自动化集团全部异构系统数据,提升全公司整体项目管理水平:梳理与简化跨部门.跨系统流程,清晰定义流程节点及业务边界,打通部门间信息流通 ...
- STM32外设:串行通信 USART、I2C、SPI
USART:Universal Synchronous Asynchronous Receiver Transmitter 通用同步异步接收发送器 UART:异步中断 主要功能:接收指定长度的帧 数据 ...