
Spark Streaming的优化之路—从Receiver到Direct模式
作者:个推数据研发工程师 学长
1 业务背景
随着大数据的快速发展,业务场景越来越复杂,离线式的批处理框架MapReduce已经不能满足业务,大量的场景需要实时的数据处理结果来进行分析、决策。Spark Streaming是一种分布式的大数据实时计算框架,他提供了动态的,高吞吐量的,可容错的流式数据处理,不仅可以实现用户行为分析,还能在金融、舆情分析、网络监控等方面发挥作用。个推开发者服务——消息推送“应景推送”正是应用了Spark Streaming技术,基于大数据分析人群属性,同时利用LBS地理围栏技术,实时触发精准消息推送,实现用户的精细化运营。此外,个推在应用Spark Streaming做实时处理kafka数据时,采用Direct模式代替Receiver模式的手段,实现了资源优化和程序稳定性提升。
本文将从Spark Streaming获取kafka数据的两种模式入手,结合个推实践,带你解读Receiver和Direct模式的原理和特点,以及从Receiver模式到Direct模式的优化对比。
2 两种模式的原理和区别
Receiver模式
1. Receiver模式下的运行架构
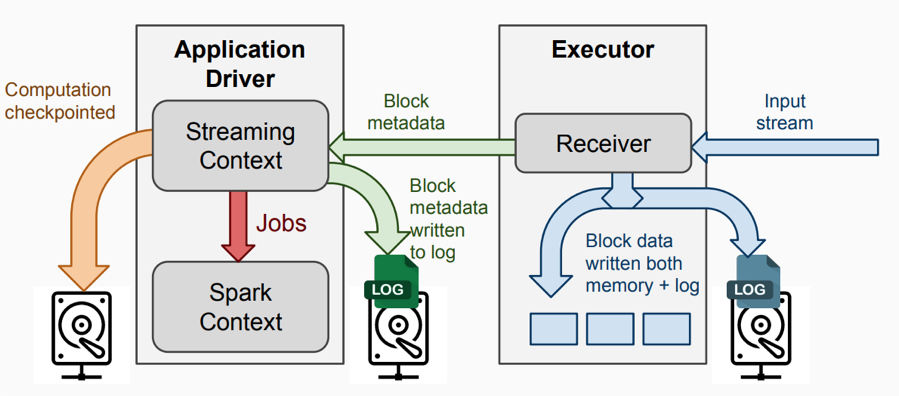
1)InputDStream: 从流数据源接收的输入数据。
2)Receiver:负责接收数据流,并将数据写到本地。
3)Streaming Context:代表SparkStreaming,负责Streaming层面的任务调度,生成jobs发送到Spark engine处理。
4)Spark Context: 代表Spark Core,负责批处理层面的任务调度,真正执行job的Spark engine。
2. Receiver从kafka拉取数据的过程
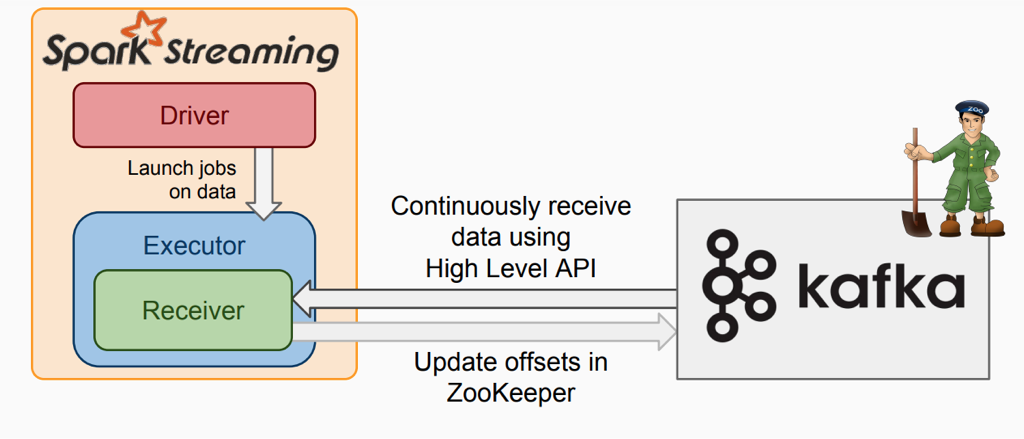
该模式下:
1)在executor上会有receiver从kafka接收数据并存储在Spark executor中,在到了batch时间后触发job去处理接收到的数据,1个receiver占用1个core;
2)为了不丢数据需要开启WAL机制,这会将receiver接收到的数据写一份备份到第三方系统上(如:HDFS);
3)receiver内部使用kafka High Level API去消费数据及自动更新offset。
Direct模式
1. Direct模式下的运行架构
与receiver模式类似,不同在于executor中没有receiver组件,从kafka拉去数据的方式不同。
2. Direct从kafka拉取数据的过程
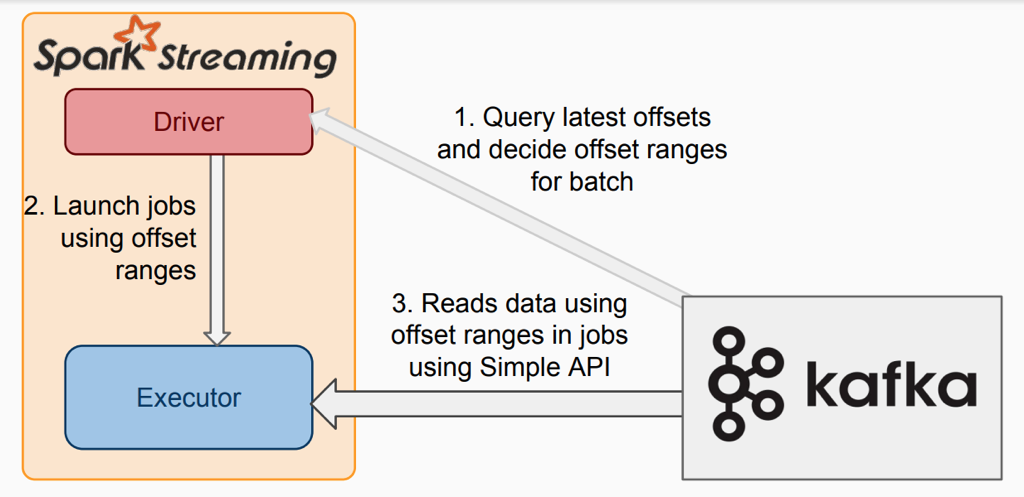
该模式下:
1)没有receiver,无需额外的core用于不停地接收数据,而是定期查询kafka中的每个partition的最新的offset,每个批次拉取上次处理的offset和当前查询的offset的范围的数据进行处理;
2)为了不丢数据,无需将数据备份落地,而只需要手动保存offset即可;
3)内部使用kafka simple Level API去消费数据, 需要手动维护offset,kafka zk上不会自动更新offset。
Receiver与Direct模式的区别
1.前者在executor中有Receiver接受数据,并且1个Receiver占用一个core;而后者无Receiver,所以不会暂用core;
2.前者InputDStream的分区是 num_receiver *batchInterval/blockInteral,后者的分区数是kafka topic partition的数量。Receiver模式下num_receiver的设置不合理会影响性能或造成资源浪费;如果设置太小,并行度不够,整个链路上接收数据将是瓶颈;如果设置太多,则会浪费资源;
3.前者使用zookeeper来维护consumer的偏移量,而后者需要自己维护偏移量;
4.为了保证不丢失数据,前者需要开启WAL机制,而后者不需要,只需要在程序中成功消费完数据后再更新偏移量即可。
3 Receiver改造成Direct模式
个推使用Spark Streaming做实时处理kafka数据,先前使用的是receiver模式;
receiver有以下特点:
1.receiver模式下,每个receiver需要单独占用一个core;
2.为了保证不丢失数据,需要开启WAL机制,使用checkpoint保存状态;
3.当receiver接受数据速率大于处理数据速率,导致数据积压,最终可能会导致程序挂掉。
由于以上特点,receiver模式下会造成一定的资源浪费;使用checkpoint保存状态, 如果需要升级程序,则会导致checkpoint无法使用;第3点receiver模式下会导致程序不太稳定;并且如果设置receiver数量不合理也会造成性能瓶颈在receiver。为了优化资源和程序稳定性,应将receiver模式改造成direct模式。
修改方式如下:
1. 修改InputDStream的创建
将receiver的:
val kafkaStream = KafkaUtils.createStream(streamingContext,

     [ZK quorum], [consumer group id], [per-topic number of Kafka partitions to consume])
改成direct的:
val directKafkaStream = KafkaUtils.createDirectStream[

     [key class], [value class], [key decoder class], [value decoder class] ](

     streamingContext, [map of Kafka parameters], [set of topics to consume])
2. 手动维护offset
receiver模式代码:
(receiver模式不需要手动维护offset,而是内部通过kafka consumer high level API 提交到kafka/zk保存)
kafkaStream.map {

           ...

 }.foreachRDD { rdd =>

    // 数据处理

    doCompute(rdd)

 }
direct模式代码:
directKafkaStream.map {

           ...

 }.foreachRDD { rdd =>

    // 获取当前rdd数据对应的offset

    val offsetRanges = rdd.asInstanceOf[HasOffsetRanges].offsetRanges

    // 数据处理

    doCompute(rdd)

    // 自己实现保存offset

    commitOffsets(offsetRanges)

 }
4 其他优化点
1. 在receiver模式下:
1)拆分InputDStream,增加Receiver,从而增加接收数据的并行度;
2)调整blockInterval,适当减小,增加task数量,从而增加并行度(在core的数量>task数量的情况下);
3)如果开启了WAL机制,数据的存储级别设置为MOMERY_AND_DISK_SER。
2.数据序列化使用Kryoserializationl,相比Java serializationl 更快,序列化后的数据更小;
3.建议使用CMS垃圾回收器降低GC开销;
4.选择高性能的算子(mapPartitions, foreachPartitions, aggregateByKey等);
5.repartition的使用:在streaming程序中因为batch时间特别短,所以数据量一般较小,所以repartition的时间短,可以解决一些因为topicpartition中数据分配不均匀导致的数据倾斜问题;
6.因为SparkStreaming生产的job最终都是在sparkcore上运行的,所以sparkCore的优化也很重要;
7.BackPressure流控
1)为什么引入Backpressure?
当batch processing time>batchinterval 这种情况持续过长的时间,会造成数据在内存中堆积,导致Receiver所在Executor内存溢出等问题;
2)Backpressure:根据JobScheduler反馈作业的执行信息来动态调整数据接收率;
3)配置使用:
spark.streaming.backpressure.enabled

含义: 是否启用 SparkStreaming内部的backpressure机制,

默认值:false ,表示禁用

spark.streaming.backpressure.initialRate

含义: receiver 为第一个batch接收数据时的比率

spark.streaming.receiver.maxRate

含义: receiver接收数据的最大比率,如果设置值<=0, 则receiver接收数据比率不受限制

spark.streaming.kafka.maxRatePerPartition

含义: 从每个kafka partition中读取数据的最大比率
8.speculation机制
spark内置speculation机制,推测job中的运行特别慢的task,将这些task kill,并重新调度这些task执行。
默认speculation机制是关闭的,通过以下配置参数开启:
spark.speculation=true
注意:在有些情况下,开启speculation反而效果不好,比如:streaming程序消费多个topic时,从kafka读取数据直接处理,没有重新分区,这时如果多个topic的partition的数据量相差较大那么可能会导致正常执行更大数据量的task会被认为执行缓慢,而被中途kill掉,这种情况下可能导致batch的处理时间反而变长;可以通过repartition来解决这个问题,但是要衡量repartition的时间;而在streaming程序中因为batch时间特别短,所以数据量一般较小,所以repartition的时间短,不像spark_batch一次处理大量数据一旦repartition则会特别久,所以最终还是要根据具体情况测试来决定。
5 总结
将Receiver模式改成Direct模式,实现了资源优化,提升了程序的稳定性,缺点是需要自己管理offset,操作相对复杂。未来,个推将不断探索和优化Spark Streaming技术,发挥其强大的数据处理能力,为建设实时数仓提供保障。
Spark Streaming的优化之路—从Receiver到Direct模式的更多相关文章
- Spark Streaming性能优化: 如何在生产环境下应对流数据峰值巨变
1.为什么引入Backpressure 默认情况下,Spark Streaming通过Receiver以生产者生产数据的速率接收数据,计算过程中会出现batch processing time > ...
- Spark Streaming性能优化系列-怎样获得和持续使用足够的集群计算资源?
一:数据峰值的巨大影响 1. 数据确实不稳定,比如晚上的时候訪问流量特别大 2. 在处理的时候比如GC的时候耽误时间会产生delay延迟 二:Backpressure:数据的反压机制 基本思想:依据上 ...
- 【转】Spark Streaming 实时计算在甜橙金融监控系统中的应用及优化
系统架构介绍 整个实时监控系统的架构是先由 Flume 收集服务器产生的日志 Log 和前端埋点数据, 然后实时把这些信息发送到 Kafka 分布式发布订阅消息系统,接着由 Spark Streami ...
- 9. Spark Streaming技术内幕 : Receiver在Driver的精妙实现全生命周期彻底研究和思考
原创文章,转载请注明:转载自 听风居士博客(http://www.cnblogs.com/zhouyf/) Spark streaming 程序需要不断接收新数据,然后进行业务逻辑 ...
- spark streaming 3: Receiver 到 submitJobSet
对于spark streaming来说,receiver是数据的源头.spark streaming的框架上,将receiver替换spark-core的以磁盘为数据源的做法,但是数据源(如监听某个 ...
- (转)用Flink取代Spark Streaming!知乎实时数仓架构演进
转:https://mp.weixin.qq.com/s/e8lsGyl8oVtfg6HhXyIe4A AI 前线导读:“数据智能” (Data Intelligence) 有一个必须且基础的环节,就 ...
- Spark Streaming的简单介绍
本文讲解Spark流数据处理之Spark Streaming.本文的写作时值Spark 1.6.2发布之际,Spark 2.0预览版也已发布,Spark发展如此迅速,请随时关注Spark Stream ...
- 【慕课网实战】Spark Streaming实时流处理项目实战笔记十三之铭文升级版
铭文一级: 第10章 Spark Streaming整合Kafka spark-submit \--class com.imooc.spark.KafkaReceiverWordCount \--ma ...
- Spark Streaming简介及原理
简介: SparkStreaming是一套框架. SparkStreaming是Spark核心API的一个扩展,可以实现高吞吐量的,具备容错机制的实时流数据处理. 支持多种数据源获取数据: Spark ...
随机推荐
- [转帖]功耗降50%,性能升35%!三星3nm GAA 2021年量产
功耗降50%,性能升35%!三星3nm GAA 2021年量产 http://www.chinaflashmarket.com/Instructor 在三星晶圆代工技术论坛(Samsung Found ...
- 这款多线程中间件,吊打 Redis!
Java技术栈 www.javastack.cn 优秀的Java技术公众号 今天给大家介绍的是KeyDB,KeyDB项目是从redis fork出来的分支.众所周知redis是一个单线程的kv内存存储 ...
- JS案例经验1
一 可以通过设置在一个div中的多个div的定位属性为absolute,从而使得这几个元素重叠.他们都脱离了标准流. 二 对于absolute的left和right属性,当left和right同时出现 ...
- P3198 [HNOI2008]遥远的行星
传送门 发现 $A$ 不大,又允许较大的误差,考虑乱搞 考虑求出每个位置的答案,因为有 $1e5$ 个位置,所以每个位置差不多可以计算 $100$ 次贡献 所以把每个可以贡献的位置尽量均匀分成 $10 ...
- 2019 360杯 re wp--Here are some big nums
测试文件:https://www.lanzous.com/i7303oh 1.准备 获取信息: 32位文件 2.IDA打开 找到主函数之后,反编译为伪C代码 int sub_404D70() { in ...
- 实现webpack的实时打包构建
1. 由于每次重新修改代码之后,都需要手动运行webpack打包的命令,比较麻烦,所以使用`webpack-dev-server`来实现代码实时打包编译,当修改代码之后,会自动进行打包构建.2. 运行 ...
- spring.jar是包含有完整发布的单个jar 包,spring.jar中包含除了spring-mock.jar里所包含的内容外其它所有jar包的内容,因为只有在开发环境下才会用到 spring-mock.jar来进行辅助测试,正式应用系统中是用不得这些类的。
Spring jar包的描述:针对3.2.2以上版本 org.springframework spring-aop ——Spring的面向切面编程,提供AOP(面向切面编程)实现 org.spring ...
- Python 中的Lock与RLock
摘要 由于多线程共享进程的资源和地址空间,因此,在对这些公共资源进行操作时,为了防止这些公共资源出现异常的结果,必须考虑线程的同步和互斥问题. 为什么加锁:1.用于非线程安全, 2.控制一段代码,确保 ...
- uwsgi支持http长链接
http1.1支持长链接,而http1.0不支持,所以,在切换http版本号或者升级服务端版本时候,尤其要注意这个造成的影响. 当客户端以http1.1长链接方式连接服务端时,服务端如果不支持1.1, ...
- 2019 蓝桥杯国赛 B 组模拟赛 E 蒜头图 (并查集判环)
思路: 我们看条件,发现满足条件的子图无非就是一些环构成的图, 因为只有形成环,才满足边的两个点都在子图中,并且子图中节点的度是大于0的偶数. 那么如果当前有k个环,我们可以选2^k-1个子图,为什么 ...