
第1节 flume:11、flume的failover机制实现高可用
1.4 高可用Flum-NG配置案例failover
在完成单点的Flume NG搭建后,下面我们搭建一个高可用的Flume NG集群,架构图如下所示:
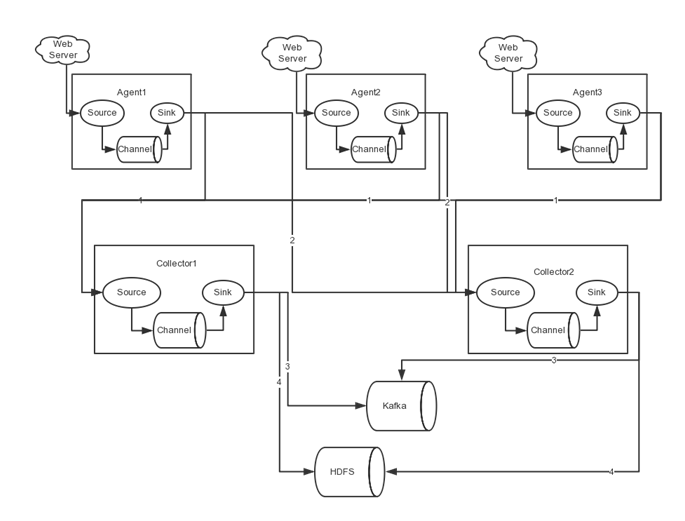
图中,我们可以看出,Flume的存储可以支持多种,这里只列举了HDFS和Kafka(如:存储最新的一周日志,并给Storm系统提供实时日志流)。
1.4.1、角色分配
Flume的Agent和Collector分布如下表所示:
|
名称 |
HOST |
角色 |
|
Agent1 |
node01 |
Web Server |
|
Collector1 |
node02 |
AgentMstr1 |
|
Collector2 |
node03 |
AgentMstr2 |
图中所示,Agent1数据分别流入到Collector1和Collector2,Flume NG本身提供了Failover机制,可以自动切换和恢复。在上图中,有3个产生日志服务器分布在不同的机房,要把所有的日志都收集到一个集群中存储。下 面我们开发配置Flume NG集群
1.4.2、node01安装配置flume与拷贝文件脚本
将node03机器上面的flume安装包以及文件生产的两个目录拷贝到node01机器上面去
node03机器执行以下命令
cd /export/servers
scp -r apache-flume-1.6.0-cdh5.14.0-bin/ node01:$PWD
scp -r shells/ taillogs/ node01:$PWD
node01机器配置agent的配置文件
cd /export/servers/apache-flume-1.6.0-cdh5.14.0-bin/conf
vim agent.conf
#agent1 name
agent1.channels = c1
agent1.sources = r1
agent1.sinks = k1 k2
#
##set gruop
agent1.sinkgroups = g1
#
##set channel
agent1.channels.c1.type = memory
agent1.channels.c1.capacity = 1000
agent1.channels.c1.transactionCapacity = 100
#
agent1.sources.r1.channels = c1
agent1.sources.r1.type = exec
agent1.sources.r1.command = tail -F /export/servers/taillogs/access_log
#
agent1.sources.r1.interceptors = i1 i2
agent1.sources.r1.interceptors.i1.type = static
agent1.sources.r1.interceptors.i1.key = Type
agent1.sources.r1.interceptors.i1.value = LOGIN
agent1.sources.r1.interceptors.i2.type = timestamp
#
## set sink1
agent1.sinks.k1.channel = c1
agent1.sinks.k1.type = avro
agent1.sinks.k1.hostname = node02
agent1.sinks.k1.port = 52020
#
## set sink2
agent1.sinks.k2.channel = c1
agent1.sinks.k2.type = avro
agent1.sinks.k2.hostname = node03
agent1.sinks.k2.port = 52020
#
##set sink group
agent1.sinkgroups.g1.sinks = k1 k2
#
##set failover
agent1.sinkgroups.g1.processor.type = failover
agent1.sinkgroups.g1.processor.priority.k1 = 10
agent1.sinkgroups.g1.processor.priority.k2 = 1
agent1.sinkgroups.g1.processor.maxpenalty = 10000
#
1.4.3、node02与node03配置flumecollection
node02机器修改配置文件
cd /export/servers/apache-flume-1.6.0-cdh5.14.0-bin/conf
vim collector.conf
#set Agent name
a1.sources = r1
a1.channels = c1
a1.sinks = k1
#
##set channel
a1.channels.c1.type = memory
a1.channels.c1.capacity = 1000
a1.channels.c1.transactionCapacity = 100
#
## other node,nna to nns
a1.sources.r1.type = avro
a1.sources.r1.bind = node02
a1.sources.r1.port = 52020
a1.sources.r1.interceptors = i1
a1.sources.r1.interceptors.i1.type = static
a1.sources.r1.interceptors.i1.key = Collector
a1.sources.r1.interceptors.i1.value = node02
a1.sources.r1.channels = c1
#
##set sink to hdfs
a1.sinks.k1.type=hdfs
a1.sinks.k1.hdfs.path= hdfs://node01:8020/flume/failover/
a1.sinks.k1.hdfs.fileType=DataStream
a1.sinks.k1.hdfs.writeFormat=TEXT
a1.sinks.k1.hdfs.rollInterval=10
a1.sinks.k1.channel=c1
a1.sinks.k1.hdfs.filePrefix=%Y-%m-%d
#
node03机器修改配置文件
cd /export/servers/apache-flume-1.6.0-cdh5.14.0-bin/conf
vim collector.conf
#set Agent name
a1.sources = r1
a1.channels = c1
a1.sinks = k1
#
##set channel
a1.channels.c1.type = memory
a1.channels.c1.capacity = 1000
a1.channels.c1.transactionCapacity = 100
#
## other node,nna to nns
a1.sources.r1.type = avro
a1.sources.r1.bind = node03
a1.sources.r1.port = 52020
a1.sources.r1.interceptors = i1
a1.sources.r1.interceptors.i1.type = static
a1.sources.r1.interceptors.i1.key = Collector
a1.sources.r1.interceptors.i1.value = node03
a1.sources.r1.channels = c1
#
##set sink to hdfs
a1.sinks.k1.type=hdfs
a1.sinks.k1.hdfs.path= hdfs://node01:8020/flume/failover/
a1.sinks.k1.hdfs.fileType=DataStream
a1.sinks.k1.hdfs.writeFormat=TEXT
a1.sinks.k1.hdfs.rollInterval=10
a1.sinks.k1.channel=c1
a1.sinks.k1.hdfs.filePrefix=%Y-%m-%d
1.4.4、顺序启动命令
node03机器上面启动flume
cd /export/servers/apache-flume-1.6.0-cdh5.14.0-bin
bin/flume-ng agent -n a1 -c conf -f conf/collector.conf -Dflume.root.logger=DEBUG,console
node02机器上面启动flume
cd /export/servers/apache-flume-1.6.0-cdh5.14.0-bin
bin/flume-ng agent -n a1 -c conf -f conf/collector.conf -Dflume.root.logger=DEBUG,console
node01机器上面启动flume
cd /export/servers/apache-flume-1.6.0-cdh5.14.0-bin
bin/flume-ng agent -n agent1 -c conf -f conf/agent.conf -Dflume.root.logger=DEBUG,console
node01机器启动文件产生脚本
cd /export/servers/shells
sh tail-file.sh
1.4.5、 FAILOVER测试
下面我们来测试下Flume NG集群的高可用(故障转移)。场景如下:我们在Agent1节点上传文件,由于我们配置Collector1的权重比Collector2大,所以 Collector1优先采集并上传到存储系统。然后我们kill掉Collector1,此时有Collector2负责日志的采集上传工作,之后,我 们手动恢复Collector1节点的Flume服务,再次在Agent1上次文件,发现Collector1恢复优先级别的采集工作。具体截图如下所 示:
Collector1优先上传
HDFS集群中上传的log内容预览
Collector1宕机,Collector2获取优先上传权限
重启Collector1服务,Collector1重新获得优先上传的权限
第1节 flume:11、flume的failover机制实现高可用的更多相关文章
- 11.Redis 哨兵集群实现高可用
作者:中华石杉 Redis 哨兵集群实现高可用 哨兵的介绍 sentinel,中文名是哨兵.哨兵是 redis 集群机构中非常重要的一个组件,主要有以下功能: 集群监控:负责监控 redis mast ...
- 《即时消息技术剖析与实战》学习笔记11——IM系统如何保证服务高可用:流量控制和熔断机制
IM 系统的不可用主要有以下两个原因: 一是无法预测突发流量,即使进行了服务拆分.自动扩容,但流量增长过快时,服务已经不可用了: 二是业务中依赖的这些接口.资源不可用或变慢时,比如发消息可能需要依赖& ...
- Kubernetes实战(一):k8s v1.11.x v1.12.x 高可用安装
说明:部署的过程中请保证每个命令都有在相应的节点执行,并且执行成功,此文档已经帮助几十人(仅包含和我取得联系的)快速部署k8s高可用集群,文档不足之处也已更改,在部署过程中遇到问题请先检查是否遗忘某个 ...
- Flume的load-balance、failover
配置flume集群参考https://www.cnblogs.com/jifengblog/p/9277793.html load-balance负载均衡 介绍 负载均衡是用于解决一台机器(一个进程) ...
- 高可用Hadoop平台-Flume NG实战图解篇
1.概述 今天补充一篇关于Flume的博客,前面在讲解高可用的Hadoop平台的时候遗漏了这篇,本篇博客为大家讲述以下内容: Flume NG简述 单点Flume NG搭建.运行 高可用Flume N ...
- 整体认识flume:Flume介绍、分布式安装、常见问题及解决方案
问题导读 1.什么是flume? 2.flume包含哪些组件? 3.Flume在读取utf-8格式的文件时会出现解析不了时间戳,该如何解决? Flume是一个分布式.可靠.和高可用的海量日志采集.聚合 ...
- [Flume][Kafka]Flume 与 Kakfa结合例子(Kakfa 作为flume 的sink 输出到 Kafka topic)
Flume 与 Kakfa结合例子(Kakfa 作为flume 的sink 输出到 Kafka topic) 进行准备工作: $sudo mkdir -p /flume/web_spooldir$su ...
- Flume 高可用配置案例+load balance负载均衡+ 案例:日志的采集及汇总
高可用配置案例 (一).failover故障转移 在完成单点的Flume NG搭建后,下面我们搭建一个高可用的Flume NG集群,架构图如下所示: (1)节点分配 Flume的Agent和Colle ...
- Flume NG高可用集群搭建详解
.Flume NG简述 Flume NG是一个分布式,高可用,可靠的系统,它能将不同的海量数据收集,移动并存储到一个数据存储系统中.轻量,配置简单,适用于各种日志收集,并支持 Failover和负载均 ...
随机推荐
- PHP 数组序列化,转为字符串
serialize() <?php $a = array('a' => 'as' ,'b' => 'bs' , 'c' => 'cs'); //序列化数组 $s = seria ...
- assembly x86(nasm)修改后的日常
data segment ENG db 'SUNdayS Coming I Wanna Drive My Car,SUN,SUN$' ;9,3 sun1 db 'SUN' swcount db 0ah ...
- java面试基础问题
1.一个".java"源文件中是否可以包括多个类(不是内部类)?有什么限制? 可以有多个类,但只能有一个public的类,并且public的类名必须与文件名相一致. 2.Java有 ...
- IP服务-5-网络时间协议
NTP版本3(RFC1305)允许IP主机向一个通用的时钟源同步它们的日期和时间. 从设计上来说,大多数路由器和交换机都使用NTP客户端模式,根据NTP服务器所提供的时间来调整自己的时钟.NTP定义了 ...
- flask环境安装
virtualenv venv #创建venv .venv/bin/activate #进入venv venv/bin/pip install flask venv/bin/pip install f ...
- Qt 进程和线程之二:启动线程
Qt提供了对线程的支持,这包括一组与平台无关的线程类.一个线程安全的发送事件的方式,以及跨线程的信号槽的关联.这些使得可以很容易地开发可移植的多线程Qt应用程序,可以充分利用多处理器的机器.多线程编程 ...
- Java集合框架常见面试题
点击关注公众号及时获取笔主最新更新文章,并可免费领取本文档配套的<Java面试突击>以及Java工程师必备学习资源. 剖析面试最常见问题之Java基础知识 说说List,Set,Map三者 ...
- 实战:liunx定时清理日志脚本
参考https://blog.csdn.net/qq_39291929/article/details/79054452 1.需求:我们在 /var/log下面有 EmcsYn.log 和 ...
- 高性能Javascript总结
一.加载和运行 Javascript代码执行会阻塞其他浏览器处理过程.充分利用webpack或gulp工具对文件打包压缩,减少js文件的数量,从而减少http请求的次数,以提高网页应用的实际性能. 二 ...
- CSS元素隐藏的display和visibility
一.CSS元素隐藏 在CSS中,让元素隐藏(指屏幕范围内肉眼不可见)的方法很多,有的占据空间,有的不占据空间:有的可以响应点击,有的不能响应点击. { display: none; /* 不占据空间, ...