
中文多分类 BERT
直接把自己的工作文档导入的,由于是在外企工作,所以都是英文写的
Steps:
- git clone https://github.com/google-research/bert
- prepare data, download pre-trained models
- modify code in run_classifier.py
- add a new processor

- add the processor in main function

Train and predict
- train
python run_classifier.py \
--task_name=multiclass \
--do_train=true \
--do_eval=true \
--data_dir=/home/wxl/bertProject/bertTextClassification/data\
--vocab_file=/home/wxl/bertProject/chinese_L-12_H-768_A-12/vocab.txt \
--bert_config_file=/home/wxl/bertProject/chinese_L-12_H-768_A-12/bert_config.json \
--init_checkpoint=/home/wxl/bertProject/chinese_L-12_H-768_A-12/bert_model.ckpt \
--max_seq_length=128 \
--train_batch_size=16 \
--learning_rate=2e-5 \
--num_train_epochs=100.0 \
--output_dir=/home/wxl/bertProject/bertTextClassification/outputThree/
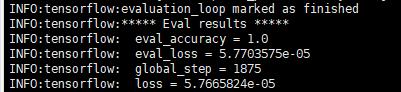
you would get the following result if success:
- predict
python run_classifier.py \
--task_name=multiclass \
--do_predict=true \
--data_dir=/home/wxl/bertProject/bertTextClassification/data\
--vocab_file=/home/wxl/bertProject/chinese_L-12_H-768_A-12/vocab.txt \
--bert_config_file=/home/wxl/bertProject/chinese_L-12_H-768_A-12/bert_config.json \
--init_checkpoint=/home/wxl/bertProject/bertTextClassification/outputThreeV1 \
--max_seq_length=128 \
--output_dir=/home/wxl/bertProject/bertTextClassification/mulitiPredictThreeV1/
中文多分类 BERT的更多相关文章
- colab上基于tensorflow2.0的BERT中文多分类
bert模型在tensorflow1.x版本时,也是先发布的命令行版本,随后又发布了bert-tensorflow包,本质上就是把相关bert实现封装起来了. tensorflow2.0刚刚在2019 ...
- 利用CNN进行中文文本分类(数据集是复旦中文语料)
利用TfidfVectorizer进行中文文本分类(数据集是复旦中文语料) 利用RNN进行中文文本分类(数据集是复旦中文语料) 上一节我们利用了RNN(GRU)对中文文本进行了分类,本节我们将继续使用 ...
- Chinese-Text-Classification,用卷积神经网络基于 Tensorflow 实现的中文文本分类。
用卷积神经网络基于 Tensorflow 实现的中文文本分类 项目地址: https://github.com/fendouai/Chinese-Text-Classification 欢迎提问:ht ...
- 基于Text-CNN模型的中文文本分类实战 流川枫 发表于AI星球订阅
Text-CNN 1.文本分类 转眼学生生涯就结束了,在家待就业期间正好有一段空闲期,可以对曾经感兴趣的一些知识点进行总结. 本文介绍NLP中文本分类任务中核心流程进行了系统的介绍,文末给出一个基于T ...
- 基于Text-CNN模型的中文文本分类实战
Text-CNN 1.文本分类 转眼学生生涯就结束了,在家待就业期间正好有一段空闲期,可以对曾经感兴趣的一些知识点进行总结. 本文介绍NLP中文本分类任务中核心流程进行了系统的介绍,文末给出一个基于T ...
- 利用RNN进行中文文本分类(数据集是复旦中文语料)
利用TfidfVectorizer进行中文文本分类(数据集是复旦中文语料) 1.训练词向量 数据预处理参考利用TfidfVectorizer进行中文文本分类(数据集是复旦中文语料) ,现在我们有了分词 ...
- 万字总结Keras深度学习中文文本分类
摘要:文章将详细讲解Keras实现经典的深度学习文本分类算法,包括LSTM.BiLSTM.BiLSTM+Attention和CNN.TextCNN. 本文分享自华为云社区<Keras深度学习中文 ...
- CNN在中文文本分类的应用
深度学习近一段时间以来在图像处理和NLP任务上都取得了不俗的成绩.通常,图像处理的任务是借助CNN来完成的,其特有的卷积.池化结构能够提取图像中各种不同程度的纹理.结构,并最终结合全连接网络实现信息的 ...
- hugging face-基于pytorch-bert的中文文本分类
1.安装hugging face的transformers pip install transformers 2.下载相关文件 字表: wget http://52.216.242.246/model ...
随机推荐
- MUI 样式按钮的禁用
1)如果是button,input等标签,可以 .attr("disabled",true)或者.attr("disabled","disab ...
- 反射attr以及模块动态导入
一.实现自省的四个函数 1.hasattr判断一个对象中有没有一个name字符串对应的方法或属性 class BlackMedium: feture="Ugly" def __in ...
- Linux中如何安装RAR
在Windows下的winrar几乎一统压缩软件的市场占有率,winrar只是RAR在Windows环境下的图形界面而已,核心功能还是RAR,那么如何在Linux中安装RAR呢? 1.下载RAR下载地 ...
- a超链接之返回顶部的两种实现方法
1.通过css实现: 为页面顶部如body或者自己设置的盒子等加上唯一id属性 <body id="id"> .... <a href="#id&quo ...
- spring tool suite处理 maven项目名称红色感叹号的问题
今天构建一个springboot项目时,发现项目有个红色感叹号,但是pom.xml跟Build Path 都没问题. 解决方案: 选择 Windows --> show view --> ...
- POJ - 1850 Code(组合数学)
https://vjudge.net/problem/POJ-1850 题意 输出某字符串在字典中的位置.字符串不合规则时输出0. 分析 首先判断字符串合法性,也就是判断是不是升序排列的.如果符合,以 ...
- Gitlab配置阿里邮件通知
1. 在/etc/gitlab/gitlab.rb 中添加如下内容 $ vi /etc/gitlab/gitlab.rb gitlab_rails['smtp_enable'] = true git ...
- STM32固件库下载地址
http://www.stmcu.org/document/list/index/sort-hot/category-517找标准外设库命名的资源
- js 报delete object in strict mode
JAVA->Compiler->Building->No strictly compatible JRE for execution environment available Ig ...
- pyqt5的安装
第一步:需要安装:pip3 install pyqt5 安装工具:pip3 install pyqt5-tools 第二步:打开Pycharm,进入设置,添加外部工具 file-->sett ...