
Apache RocketMQ分布式消息传递和流数据平台及大厂面试宝典v4.9.2
概述
**本人博客网站 **IT小神 www.itxiaoshen.com
定义
Apache RocketMQ官网地址 https://rocketmq.apache.org/ Latest release v4.9.2
Apache RocketMQ GitHub源码地址 https://github.com/apache/rocketmq
Apache RocketMQ是一个分布式消息传递和流媒体平台、统一的消息传递引擎,轻量级的数据处理平台;具有低延迟、高性能和可靠性、万亿级容量和灵活的可伸缩性。
今天我们又来学习一个Apache顶级项目Apache RocketMQ,RocketMQ由国人阿里团队采用Java语言开发和开源的,曾获得2016、2018中国最受欢迎的开源软件奖。RocketMQ凭借其强大的存储能力和强大的消息索引能力,以及各种类型消息和消息的特性脱颖而出。Apache RocketMQ官网地址及其GitHub都提供非常详细中文学习文档如Apache RocketMQ开发者指南等,学习起来可谓是非常之流畅、酸爽、so easy!让我们通过官网和及其GitHub来深入学习这个与时俱进非常优秀互联网主流的消息中间件。
为何需要Apache RocketMQ?
阿里早期是基于ActiveMQ 5的分布式消息传递中间件,随着队列和虚拟主题的增加ActiveMQ IO模块达到了瓶颈,当时也研讨过Kafka但当时的Kafka不能满足阿里的要求(特别是在低延迟和高可靠性方面),因此阿里决定自行研发一个消息中间件,从传统的发布/订阅场景到高容量的实时零损失容忍度事务系统,这就是RocketMQ诞生的原因。
RocketMQ vs. ActiveMQ vs. Kafka
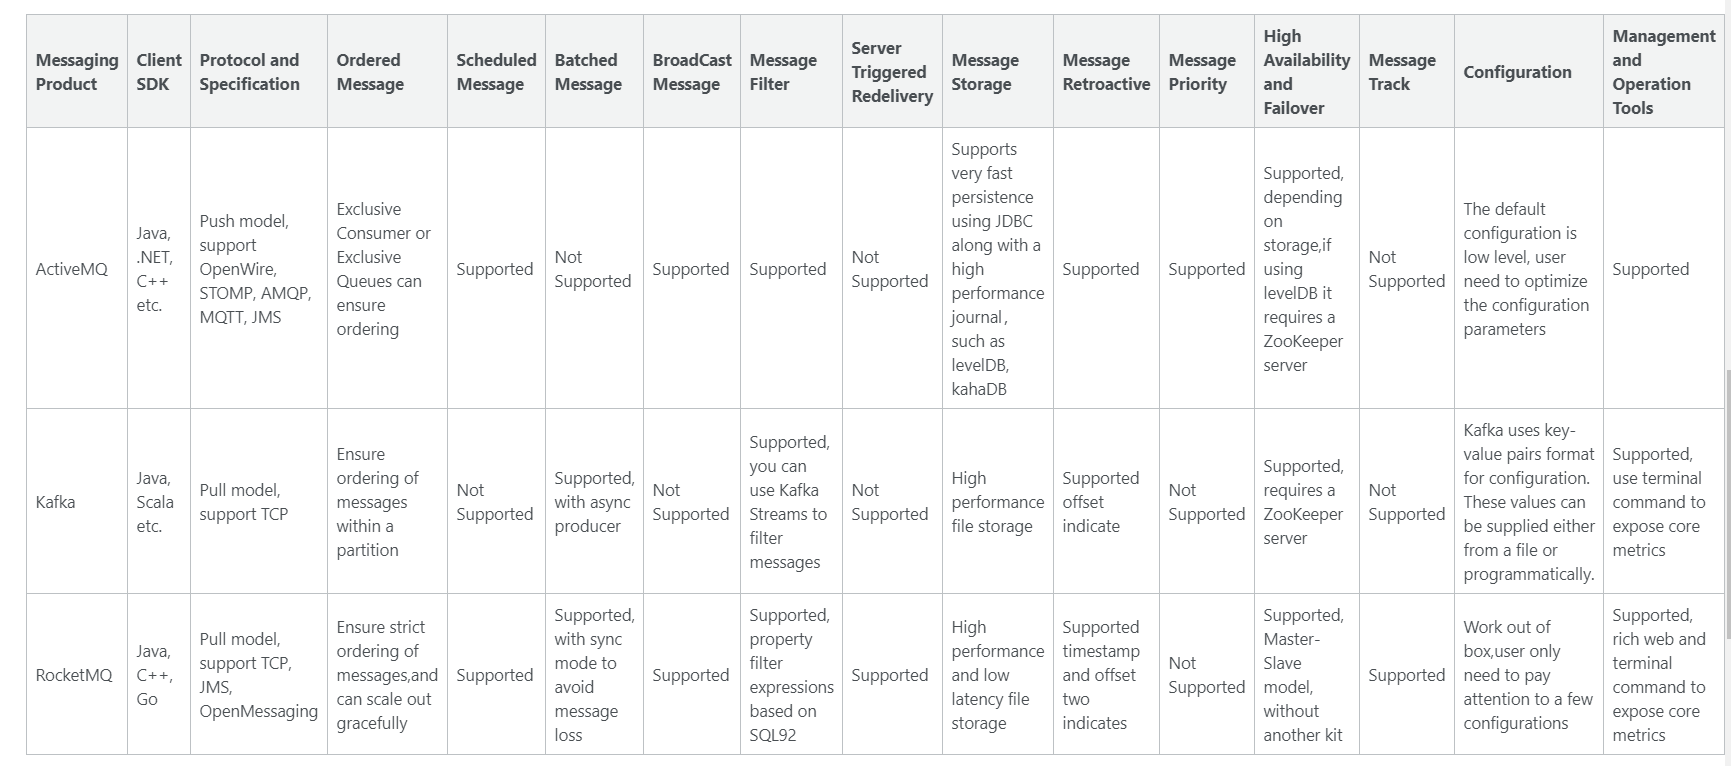
下表展示了RocketMQ、ActiveMQ和Kafka(根据awesome-java的Apache最流行的消息传递解决方案)之间的比较。根据个人经验,如果不是大数据场景下如大数据日志采集等场景外建议优先使用RocketMQ,性能和功能都有保障,当然需要用于云原生领域还有Apache Pulsar云原生分布式消息和流平台,这个在前面的文章也有较少。
安装部署
安装说明
the latest release is 4.9.2
二进制下载地址 https://dlcdn.apache.org/rocketmq/4.9.2/rocketmq-all-4.9.2-bin-release.zip
源码下载地址 https://dlcdn.apache.org/rocketmq/4.9.2/rocketmq-all-4.9.2-source-release.zip
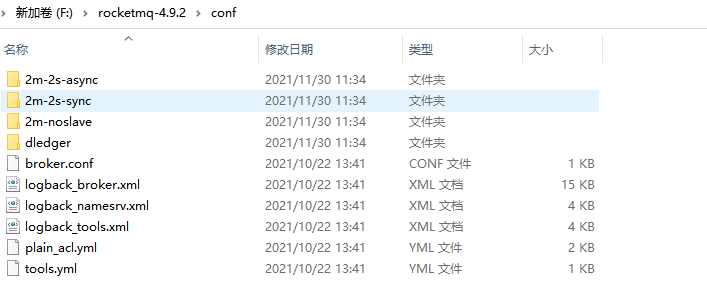
Apache RocketMQ部署方式有单Master模式、多Master模式、多Master多slave模式、Dledger的集群部署模式等,官网也提供额外的CLI Admin Tool和运维工具mqadmin。在二进制包下conf目录提供了两主两从异步方式、两主两从同步方式、两主无从、Dledger集群的配置模板。
网络部署特点
- NameServer是一个几乎无状态节点,可集群部署,节点之间无任何信息同步。
- Broker部署相对复杂,Broker分为Master与Slave,Master提供RW访问,而Slave只接受读访问;一个Master可以对应多个Slave,但是一个Slave只能对应一个Master,Master与Slave 的对应关系通过指定相同的BrokerName,不同的BrokerId 来定义,BrokerId为0表示Master,非0表示Slave。Master也可以部署多个。每个Broker与NameServer集群中的所有节点建立长连接,定时注册Topic信息到所有NameServer。 注意:当前RocketMQ版本在部署架构上支持一Master多Slave,但只有BrokerId=1的从服务器才会参与消息的读负载。
- Producer与NameServer集群中的其中一个节点(随机选择)建立长连接,定期从NameServer获取Topic路由信息,并向提供Topic 服务的Master建立长连接,且定时向Master发送心跳。Producer完全无状态,可集群部署。
- Consumer与NameServer集群中的其中一个节点(随机选择)建立长连接,定期从NameServer获取Topic路由信息,并向提供Topic服务的Master、Slave建立长连接,且定时向Master、Slave发送心跳。Consumer既可以从Master订阅消息,也可以从Slave订阅消息,消费者在向Master拉取消息时,Master服务器会根据拉取偏移量与最大偏移量的距离(判断是否读老消息,产生读I/O),以及从服务器是否可读等因素建议下一次是从Master还是Slave拉取。
配置推荐
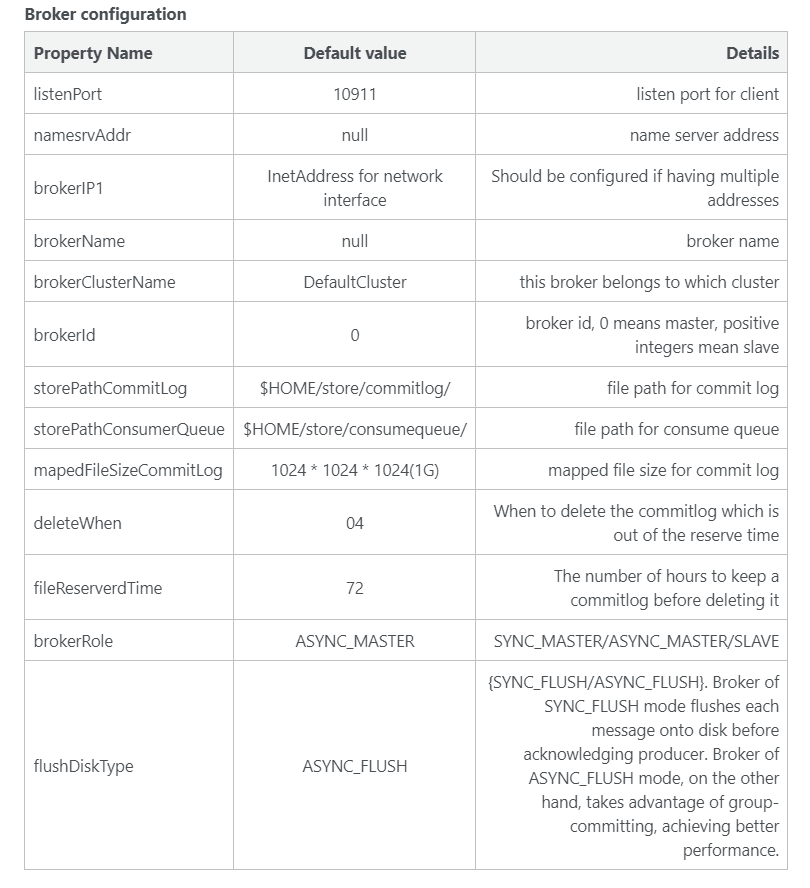
在部署RocketMQ集群时,推荐的配置如下所示:
部署方式说明
单Master模式
- 这种方式风险较大,一旦Broker重启或者宕机时,会导致整个服务不可用。不建议线上环境使用,可以用于本地测试。
多Master模式
- 一个集群无Slave,全是Master,例如2个Master或者3个Master,这种模式的优缺点如下:
- 优点:配置简单,单个Master宕机或重启维护对应用无影响,在磁盘配置为RAID10时,即使机器宕机不可恢复情况下,由于RAID10磁盘非常可靠,消息也不会丢(异步刷盘丢失少量消息,同步刷盘一条不丢),性能最高;
- 缺点:单台机器宕机期间,这台机器上未被消费的消息在机器恢复之前不可订阅,消息实时性会受到影响。
- 一个集群无Slave,全是Master,例如2个Master或者3个Master,这种模式的优缺点如下:
多Master多Slave模式-异步复制
- 每个Master配置一个Slave,有多对Master-Slave,HA采用异步复制方式,主备有短暂消息延迟(毫秒级),这种模式的优缺点如下:
- 优点:即使磁盘损坏,消息丢失的非常少,且消息实时性不会受影响,同时Master宕机后,消费者仍然可以从Slave消费,而且此过程对应用透明,不需要人工干预,性能同多Master模式几乎一样;
- 缺点:Master宕机,磁盘损坏情况下会丢失少量消息。
- 每个Master配置一个Slave,有多对Master-Slave,HA采用异步复制方式,主备有短暂消息延迟(毫秒级),这种模式的优缺点如下:
多Master多Slave模式-同步双写
- 每个Master配置一个Slave,有多对Master-Slave,HA采用同步双写方式,即只有主备都写成功,才向应用返回成功,这种模式的优缺点如下:
- 优点:数据与服务都无单点故障,Master宕机情况下,消息无延迟,服务可用性与数据可用性都非常高;
- 缺点:性能比异步复制模式略低(大约低10%左右),发送单个消息的RT会略高,且目前版本在主节点宕机后,备机不能自动切换为主机。
- 每个Master配置一个Slave,有多对Master-Slave,HA采用同步双写方式,即只有主备都写成功,才向应用返回成功,这种模式的优缺点如下:
单Master部署
单Master模式部署非常简单,这种方式风险较大,一旦Broker重启或者宕机时,会导致整个服务不可用。不建议线上环境使用,可以用于本地测试。先启动NameServer后启动Broker。
#linux部署,解压下载zip进入二级制加压的根目录

unzip rocketmq-all-4.9.2-bin-release.zip

cd rocketmq-4.9.2

#启动NameServer

nohup sh bin/mqnamesrv &

#查看NameServer运行日志

tail -f ~/logs/rocketmqlogs/namesrv.log

#启动Broker

nohup sh bin/mqbroker -n localhost:9876 &

#查看Broker运行日志

tail -f ~/logs/rocketmqlogs/broker.log

#关闭Broker

sh bin/mqshutdown broker

#关闭NameServer

sh bin/mqshutdown namesrv
Dledger集群部署
多主多从模式有模板配置,根据不同配置拉起Broker即可,但是从上面我们知道在多主多从模式下是不支持自动容灾切换功能,因此还不具备完全的高可用,我们这里使用Dledger集群部署实现自动容灾切换;之前我们在ZooKeeper章节也了解到分布式一致性算法,其实Dledger也是依赖Raft算法实现选举的功能。Dledger一个基于java库用于构建高可用性、高耐用性、强一致性的提交,它可以作为分布式存储系统的持久化层,如消息传递、流、kv、db等。Dledger是已被证明可以应用于生产级别的产品。
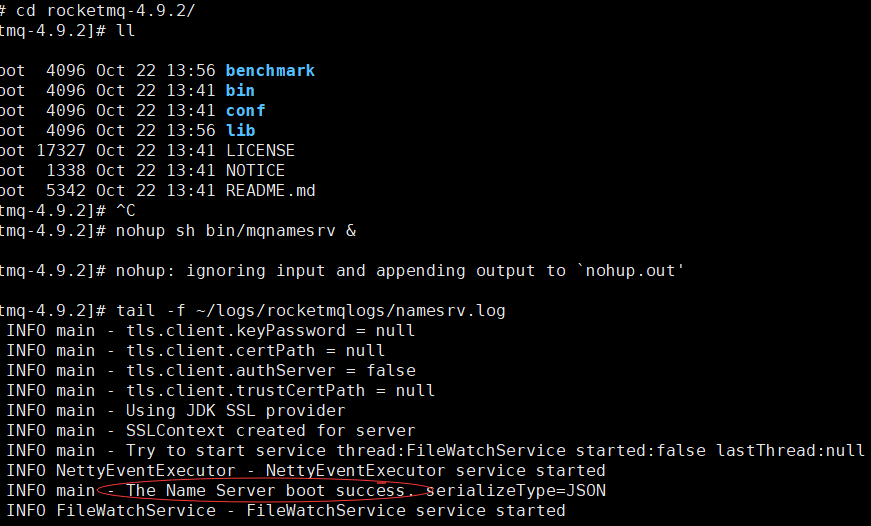
NameServer需要先于Broker启动,且如果在生产环境使用,为了保证高可用,建议一般规模的集群启动3个NameServer。我们本次准备3台服务器192.168.50.95(n0)、192.168.50.156(n1)、192.168.50.196(n2)。
cd rocketmq-4.9.2

#3台服务器启动Name Server

nohup sh bin/mqnamesrv &

#验证Name Server 是否启动成功

tail -f ~/logs/rocketmqlogs/namesrv.log
在conf\dledger参考broker-n0.conf数据创建文件名为broker.conf数据内容如下,其他两台和这个数据一样,只需要修改dLegerSelfId为n1和n2即可。
vi conf/dledger/broker.conf
brokerClusterName = RaftCluster

brokerName=RaftNode00

listenPort=30911

namesrvAddr=192.168.50.95:9876;192.168.50.156:9876;192.168.50.196:9876

storePathRootDir=/home/commons/rocketmq-4.9.2/rmqstore/node00

storePathCommitLog=/home/commons/rocketmq-4.9.2/rmqstore/node00/commitlog

enableDLegerCommitLog=true

dLegerGroup=RaftNode00

dLegerPeers=n0-192.168.50.95:40911;n1-192.168.50.156:40911;n2-192.168.50.196:40911

## must be unique

dLegerSelfId=n0

sendMessageThreadPoolNums=16
#可以3台分别先创建配置文件路径,非必要

mkdir /home/commons/rocketmq-4.9.2/rmqstore/node00

mkdir /home/commons/rocketmq-4.9.2/rmqstore/node00/commitlog

#3台分别启动broker

nohup sh bin/mqbroker -c conf/dledger/broker.conf &

#查看Broker运行日志

tail -f ~/logs/rocketmqlogs/broker.log
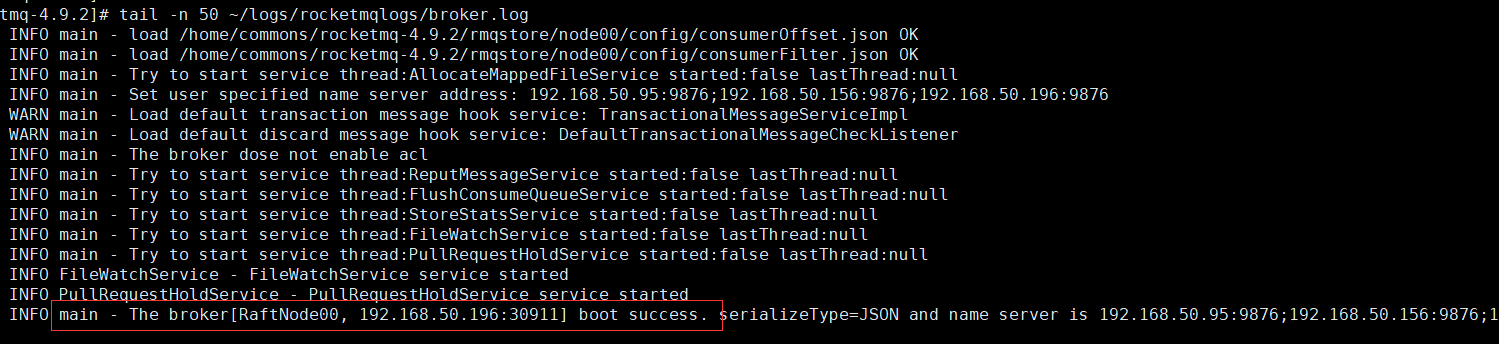
通过 mqadmin 运维命令查看集群状态,可指定任意一台Name Server
sh bin/mqadmin clusterList -n 192.168.50.95:9876
[外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传(img-PcYuzQb9-1638544959716)(http://www.itxiaoshen.com:3001/assets/1638501706653H0QPMbWB.png)]

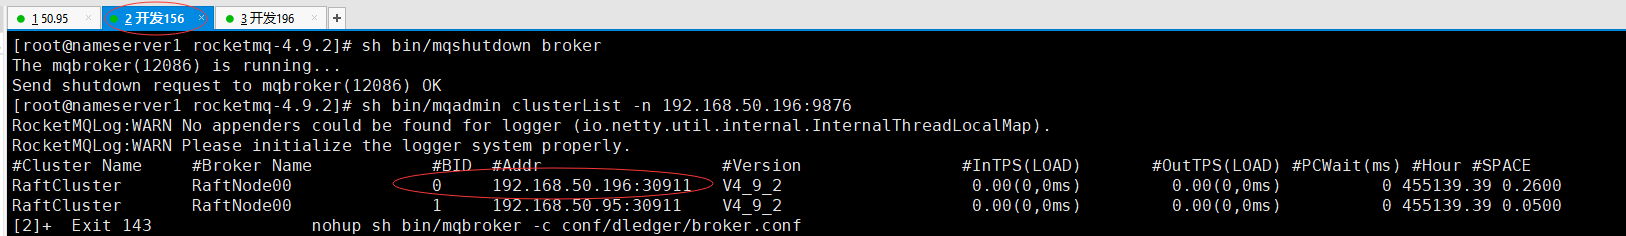
BID 为 0 的表示 Master,其余都是 Follower,从当前看192.168.50.156为Master,我们进行容灾切换测试,停掉192.168.50.156上的Broker进程,等待约 10s 左右,用 clusterList 命令再次查看集群,就会发现 Leader 切换到另一个节点192.168.50.196上
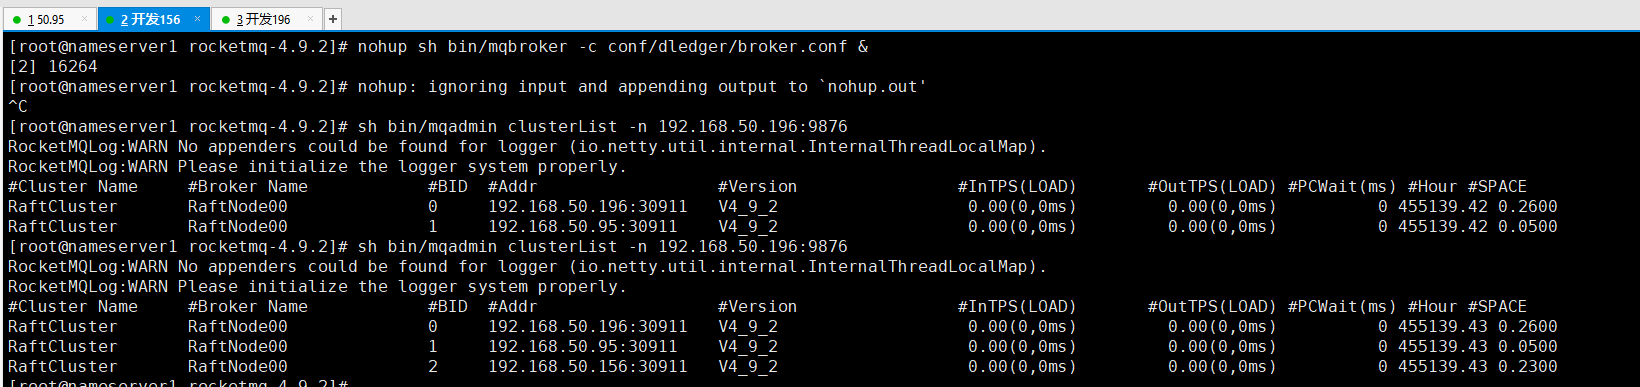
再次启动192.168.50.156上的broker重新再加入集群并作为集群的Follower
简单收发消息测试
#192.168.50.95上执行测试工具的生产者发送消息

export NAMESRV_ADDR="192.168.50.95:9876;192.168.50.156:9876;192.168.50.196:9876"

sh bin/tools.sh org.apache.rocketmq.example.quickstart.Producer
[外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传(img-HFLt4ZFo-1638544959726)(http://www.itxiaoshen.com:3001/assets/1638502366597EjsQW4e8.png)]

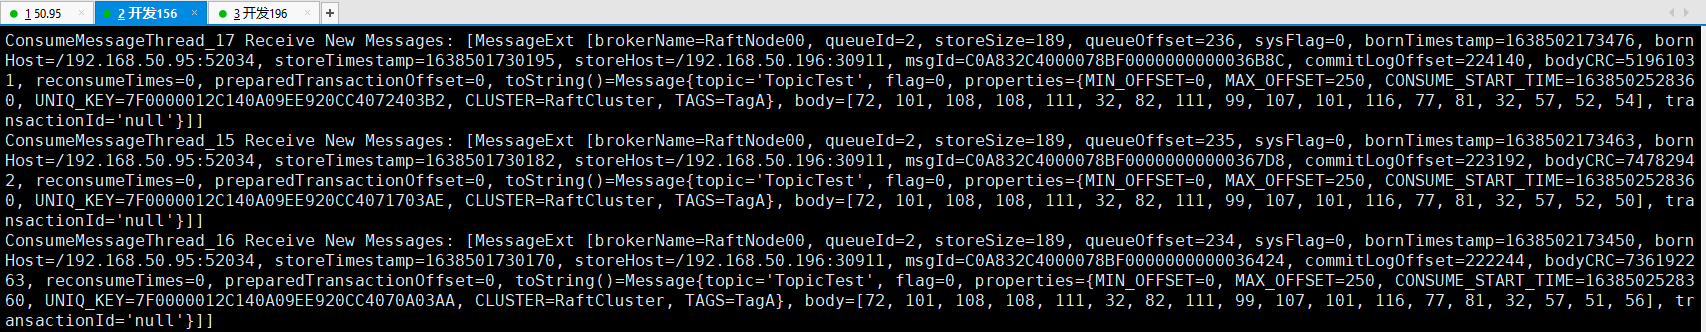
#192.168.50.95上执行测试工具的消费者接收消息

export NAMESRV_ADDR="192.168.50.95:9876;192.168.50.156:9876;192.168.50.196:9876"

sh bin/tools.sh org.apache.rocketmq.example.quickstart.Consumer
Java示例
常用消息样例说明
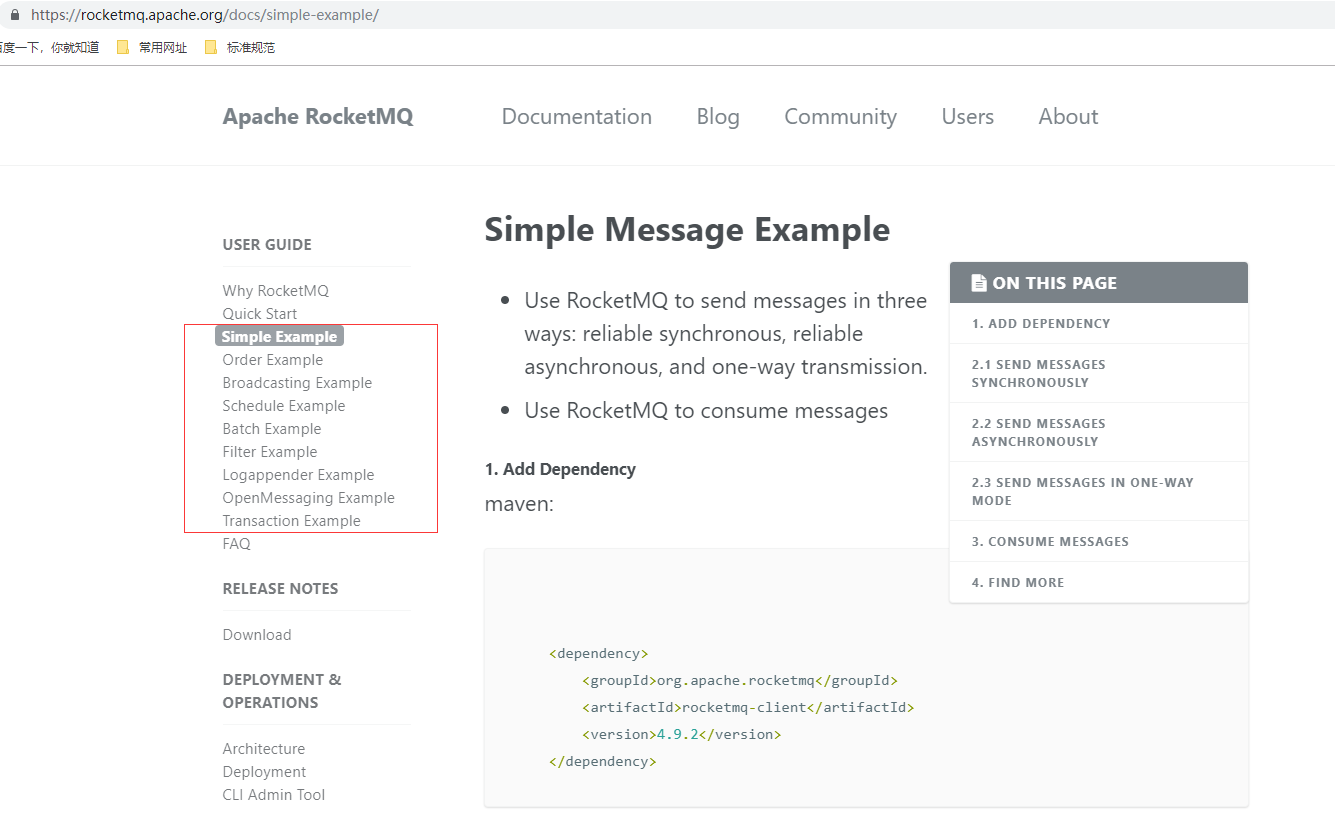
简单消息(三种方式发送消息)
- 可靠同步,使用的比较广泛,比如:重要的消息通知,短信通知。
- 可靠异步,通常用在对响应时间敏感的业务场景,即发送端不能容忍长时间地等待Broker的响应。
- 单向传输,用在不特别关心发送结果的场景,例如日志发送。
顺序消息
- RocketMQ使用FIFO顺序提供有序消息,RocketMQ可以严格的保证消息有序,可以分为分区有序或者全局有序。
- 比如用订单场景,一个订单的顺序流程是:创建、付款、推送、完成。订单号相同的消息会被先后发送到同一个队列中,消费时,同一个OrderId获取到的肯定是同一个队列。
广播消息
- 向一个主题的所有订阅者发送消息。
延迟消息
- 延迟消息与普通消息的不同之处在于它们将在稍后提供的时间内被传递,比如电商里提交了一个订单就可以发送一个延时消息,1h后去检查这个订单的状态,如果还是未付款就取消订单释放库存。
批量消息
- 批量发送消息可以提高发送小消息的性能。
- 约束:同一批的消息应该有:相同的主题,相同的waitStoreMsgOK,不支持延迟。
过滤消息
- 在大多数情况下,TAG是一个简单而有用的设计,其可以来选择您想要的消息。
- 在RocketMQ定义的语法下可以使用SQL表达式筛选消息,SQL特性可以通过发送消息时的属性来进行计算。
- 只有使用push模式的消费者才能用使用SQL92标准的sql语句。
Logappender日志
- RocketMQ日志提供log4j、log4j2和logback日志框架作为业务应用
OpenMessaging
- 旨在建立消息和流处理规范,以为金融、电子商务、物联网和大数据领域提供通用框架及工业级指导方案。在分布式异构环境中,设计原则是面向云、简单、灵活和独立于语言。符合这些规范将帮助企业方便的开发跨平台和操作系统的异构消息传递应用程序。提供了openmessaging-api 0.3.0-alpha的部分实现。
事务消息
可以将其视为两阶段提交消息实现,以确保分布式系统中的最终一致性。事务性消息确保本地事务的执行和消息的发送能够被原子地执行。
限制约束
- 事务消息不支持延时消息和批量消息。
- 为了避免单个消息被检查太多次而导致半队列消息累积,我们默认将单个消息的检查次数限制为 15 次,但是用户可以通过 Broker 配置文件的
transactionCheckMax参数来修改此限制。如果已经检查某条消息超过 N 次的话( N =transactionCheckMax) 则 Broker 将丢弃此消息,并在默认情况下同时打印错误日志。用户可以通过重写AbstractTransactionalMessageCheckListener类来修改这个行为。 - 事务消息将在 Broker 配置文件中的参数 transactionTimeout 这样的特定时间长度之后被检查。当发送事务消息时,用户还可以通过设置用户属性 CHECK_IMMUNITY_TIME_IN_SECONDS 来改变这个限制,该参数优先于
transactionTimeout参数。 - 事务性消息可能不止一次被检查或消费。
- 提交给用户的目标主题消息可能会失败,目前这依日志的记录而定。它的高可用性通过 RocketMQ 本身的高可用性机制来保证,如果希望确保事务消息不丢失、并且事务完整性得到保证,建议使用同步的双重写入机制。
- 事务消息的生产者 ID 不能与其他类型消息的生产者 ID 共享。与其他类型的消息不同,事务消息允许反向查询、MQ服务器能通过它们的生产者 ID 查询到消费者。
事务性消息有三种状态:
(1) TransactionStatus。CommitTransaction:提交事务,它意味着允许使用者使用此消息。
(2) TransactionStatus。rollback transaction:回滚事务,它意味着消息将被删除并且不允许使用。
(3) TransactionStatus。未知:中间状态,这意味着MQ需要进行回查以确定状态。
简单消息示例代码
pom加入maven依赖
        <dependency>

            <groupId>org.apache.rocketmq</groupId>

            <artifactId>rocketmq-client</artifactId>

            <version>4.9.2</version>

        </dependency>
可靠同步生产者实现代码
package com.itxs.rocketmq;

import org.apache.rocketmq.client.producer.DefaultMQProducer;

import org.apache.rocketmq.client.producer.SendResult;

import org.apache.rocketmq.common.message.Message;

import org.apache.rocketmq.remoting.common.RemotingHelper;

public class SyncProducer {

    public static void main(String[] args) throws Exception {

        //Instantiate with a producer group name.

        DefaultMQProducer producer = new

                DefaultMQProducer("default_group");

        // Specify name server addresses.

        producer.setNamesrvAddr("192.168.50.95:9876;192.168.50.156:9876;192.168.50.196:9876");

        //Launch the instance.

        producer.start();

        for (int i = 0; i < 10; i++) {

            //Create a message instance, specifying topic, tag and message body.

            Message msg = new Message("DefaultTopic" /* Topic */,

                    "TagA" /* Tag */,

                    ("Hello RocketMQ " +

                            i).getBytes(RemotingHelper.DEFAULT_CHARSET) /* Message body */

            );

            //Call send message to deliver message to one of brokers.

            SendResult sendResult = producer.send(msg);

            System.out.printf("%s%n", sendResult);

        }

        //Shut down once the producer instance is not longer in use.

        producer.shutdown();

    }

}
可靠异步生产者实现代码
package com.itxs.rocketmq;

import org.apache.rocketmq.client.producer.DefaultMQProducer;

import org.apache.rocketmq.client.producer.SendCallback;

import org.apache.rocketmq.client.producer.SendResult;

import org.apache.rocketmq.common.message.Message;

import org.apache.rocketmq.remoting.common.RemotingHelper;

import java.util.concurrent.CountDownLatch;

import java.util.concurrent.TimeUnit;

public class AsyncProducer {

    public static void main(String[] args) throws Exception {

        //Instantiate with a producer group name.

        DefaultMQProducer producer = new DefaultMQProducer("default_group");

        // Specify name server addresses.

        producer.setNamesrvAddr("192.168.50.95:9876;192.168.50.156:9876;192.168.50.196:9876");

        //Launch the instance.

        producer.start();

        producer.setRetryTimesWhenSendAsyncFailed(0);

        int messageCount = 10;

        final CountDownLatch countDownLatch = new CountDownLatch(messageCount);

        for (int i = 0; i < messageCount; i++) {

            try {

                final int index = i;

                Message msg = new Message("DefaultTopic",

                        "TagA",

                        "OrderID888888",

                        "Hello world".getBytes(RemotingHelper.DEFAULT_CHARSET));

                producer.send(msg, new SendCallback() {

                    @Override

                    public void onSuccess(SendResult sendResult) {

                        countDownLatch.countDown();

                        System.out.printf("%-10d OK %s %n", index, sendResult.getMsgId());

                    }

                    @Override

                    public void onException(Throwable e) {

                        countDownLatch.countDown();

                        System.out.printf("%-10d Exception %s %n", index, e);

                        e.printStackTrace();

                    }

                });

            } catch (Exception e) {

                e.printStackTrace();

            }

        }

        countDownLatch.await(5, TimeUnit.SECONDS);

        producer.shutdown();

    }

}
单向传输生产者实现代码
package com.itxs.rocketmq;

import org.apache.rocketmq.client.producer.DefaultMQProducer;

import org.apache.rocketmq.common.message.Message;

import org.apache.rocketmq.remoting.common.RemotingHelper;

public class OnewayProducer {

    public static void main(String[] args) throws Exception{

        //Instantiate with a producer group name.

        DefaultMQProducer producer = new DefaultMQProducer("default_group");

        // Specify name server addresses.

        producer.setNamesrvAddr("192.168.50.95:9876;192.168.50.156:9876;192.168.50.196:9876");

        //Launch the instance.

        producer.start();

        for (int i = 0; i < 10; i++) {

            //Create a message instance, specifying topic, tag and message body.

            Message msg = new Message("DefaultTopic" /* Topic */,

                    "TagA" /* Tag */,

                    ("Hello RocketMQ " +

                            i).getBytes(RemotingHelper.DEFAULT_CHARSET) /* Message body */

            );

            //Call send message to deliver message to one of brokers.

            producer.sendOneway(msg);

        }

        //Wait for sending to complete

        Thread.sleep(5000);

        producer.shutdown();

    }

}
消费者实现代码
package com.itxs.rocketmq;

import org.apache.rocketmq.client.consumer.DefaultMQPushConsumer;

import org.apache.rocketmq.client.consumer.listener.ConsumeConcurrentlyContext;

import org.apache.rocketmq.client.consumer.listener.ConsumeConcurrentlyStatus;

import org.apache.rocketmq.client.consumer.listener.MessageListenerConcurrently;

import org.apache.rocketmq.client.exception.MQClientException;

import org.apache.rocketmq.common.message.MessageExt;

import java.util.List;

public class Consumer {

    public static void main(String[] args) throws InterruptedException, MQClientException {

        // Instantiate with specified consumer group name.

        DefaultMQPushConsumer consumer = new DefaultMQPushConsumer("default_group");

        // Specify name server addresses.

        consumer.setNamesrvAddr("192.168.50.95:9876;192.168.50.156:9876;192.168.50.196:9876");

        // Subscribe one more more topics to consume.

        consumer.subscribe("DefaultTopic", "*");

        // Register callback to execute on arrival of messages fetched from brokers.

        consumer.registerMessageListener(new MessageListenerConcurrently() {

            @Override

            public ConsumeConcurrentlyStatus consumeMessage(List<MessageExt> msgs,

                                                            ConsumeConcurrentlyContext context) {

                System.out.printf("%s Receive New Messages: %s %n", Thread.currentThread().getName(), msgs);

                return ConsumeConcurrentlyStatus.CONSUME_SUCCESS;

            }

        });

        //Launch the consumer instance.

        consumer.start();

        System.out.printf("Consumer Started.%n");

    }

}
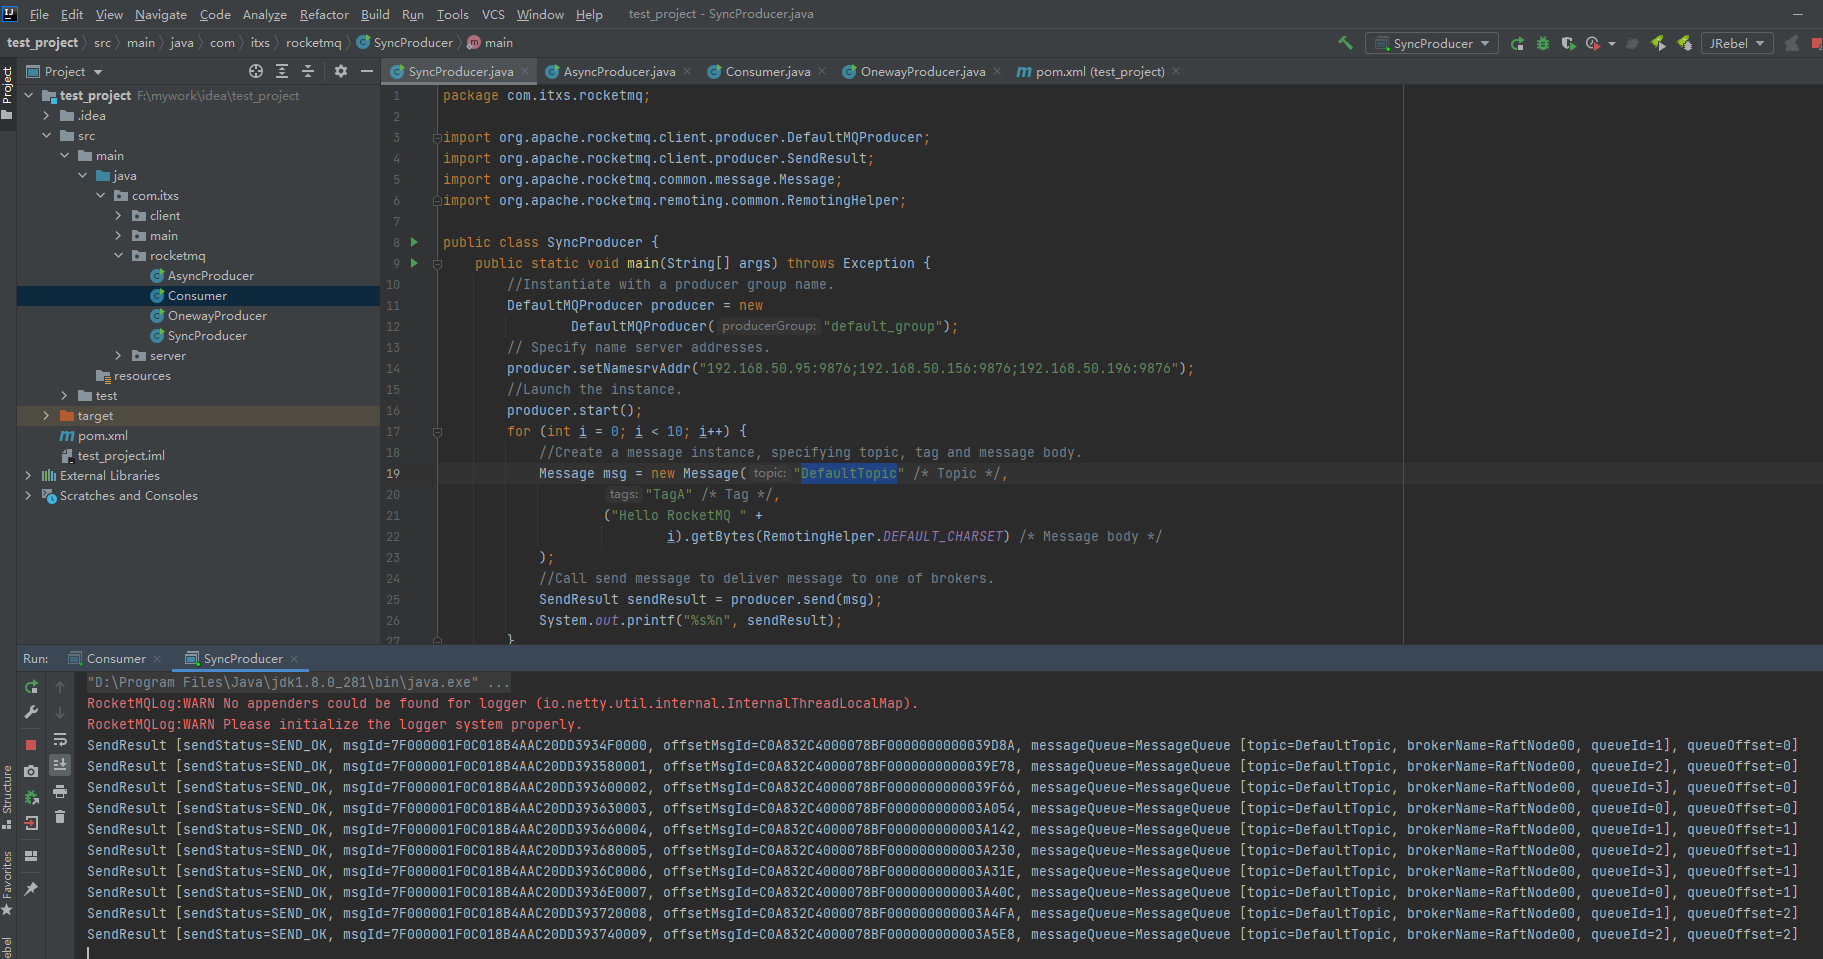
可靠同步生产者发送消息
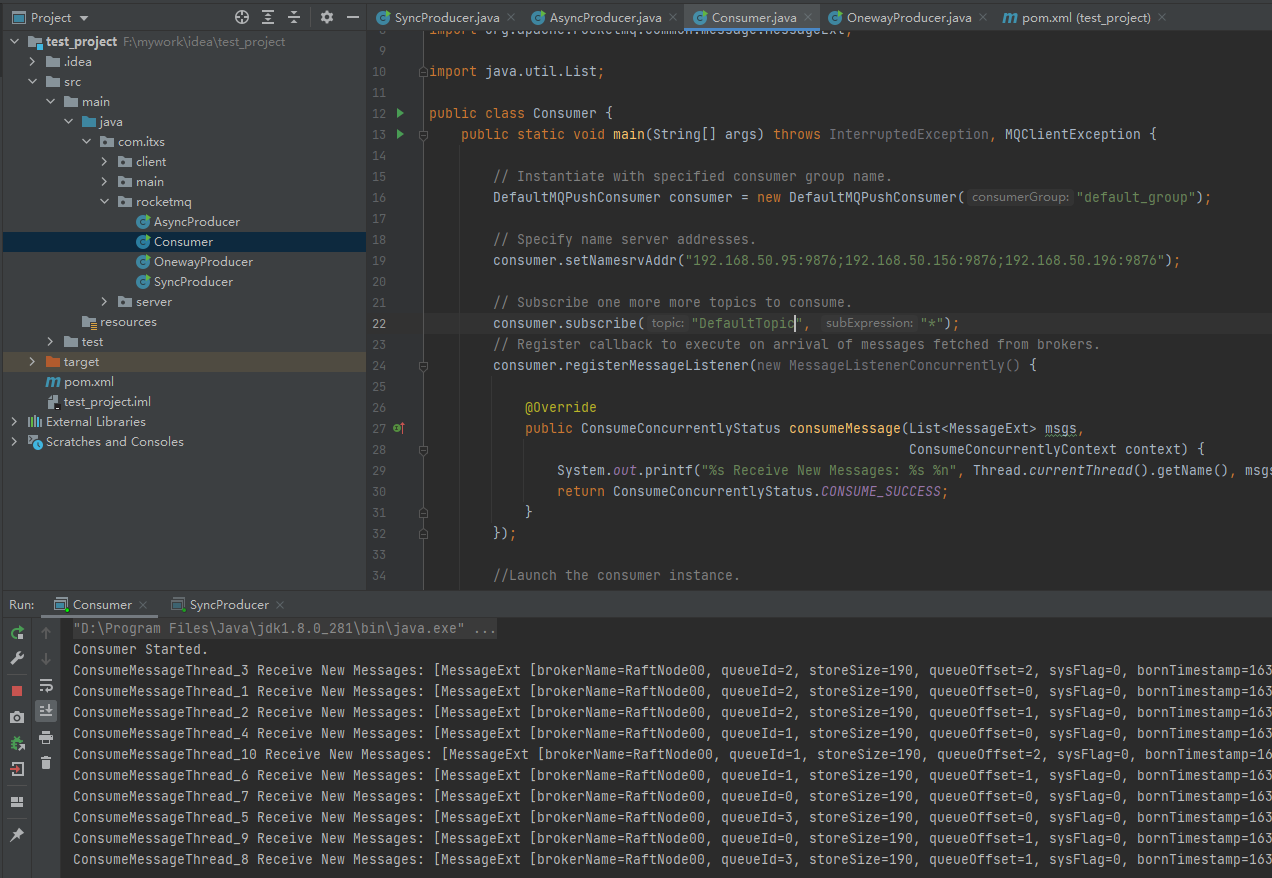
消费者消费消息
其他消息示例可以参考官网的样例使用即可
面试题
说说RocketMQ架构和组成?
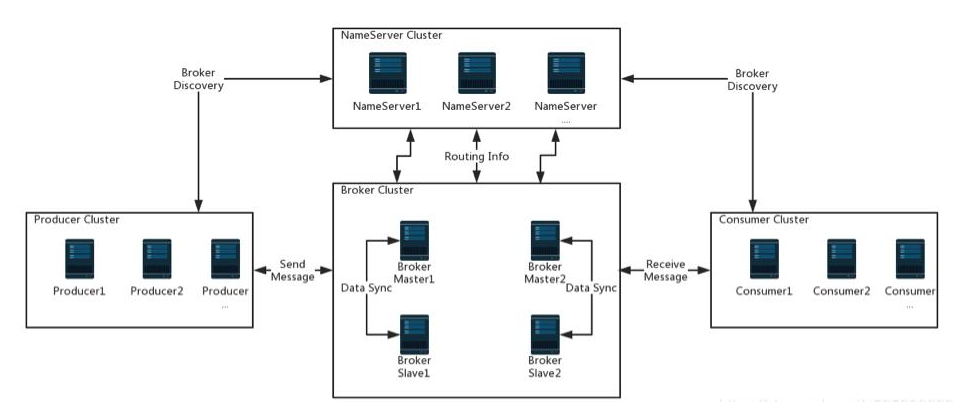
从Apache RocketMQ官网架构图看可知道其由四个大部分组成,分别为名称服务器集群、Broker集群、生产者集群和消费者集群;它们中的每一个都可以水平扩展而不存在单一的故障点。
NameServer Cluster(命名服务器集群):名称服务器提供轻量级的服务发现和路由。每个Name Server记录完整的路由信息,提供相应的读写服务,支持快速的存储扩展。我们知道Kafka是依赖ZooKeeper来实现服务发现和路由的。
- Broker管理,NameServer接受来自Broker集群的注册,并提供心跳机制来检查代理是否处于活动状态。
- 路由管理,每个NameServer将保存关于代理集群的全部路由信息和用于客户端查询的队列信息。
- Producer和Conumser通过NameServer就可以知道整个Broker集群的路由信息,从而进行消息的投递和消费。
- NameServer通常也是集群的方式部署,各实例间相互不进行信息通讯。Broker是向每一台NameServer注册自己的路由信息,所以每一个NameServer实例上面都保存一份完整的路由信息。当某个NameServer因某种原因下线了,Broker仍然可以向其它NameServer同步其路由信息,Producer,Consumer仍然可以动态感知Broker的路由的信息。
- RocketMQ客户端(生产者/消费者)将从NameServer查询队列路由信息,客户端可以通过多种方式找到NameServer的地址,下面列出几种
- 编程方式,如producer.setNamesrvAddr("ip:port")。
- Java选项,使用rocketmq.namesrv.addr。
- 环境变量使用NAMESRV_ADDR。
- HTTP Endpoint。
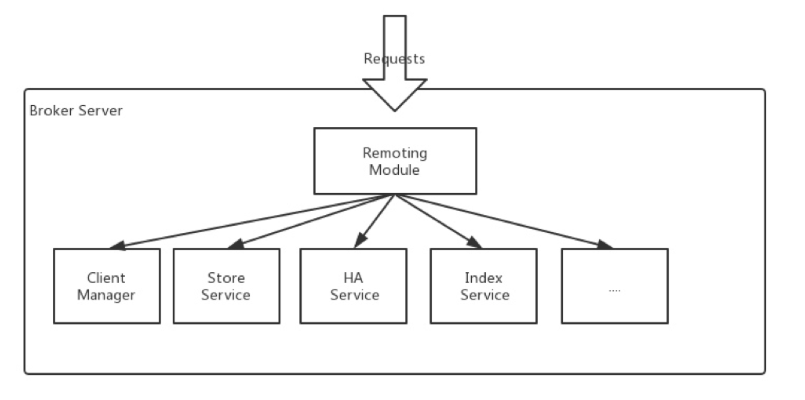
Broker Cluster(代理集群):Broker是作为RocketMQ最核心消息Server,Broker通过提供轻量级的TOPIC和QUEUE机制来负责消息存储。它们支持Push和Pull模型,包含容错机制(2副本或3副本),并提供强大的填充峰值和按原始时间顺序累积数千亿条消息的能力。此外,Broker提供灾难恢复、丰富的度量统计信息和警报机制,这些都是传统消息中间件系统所缺乏的;代理服务器负责消息存储和传递、消息查询、HA保证等,Broker服务器有几个重要的子模块:
- 远程模块,Broker的入口,处理来自客户机的请求。
- 客户端管理器,管理客户端(生产者/消费者)并维护消费者的主题订阅。
- 存储服务,提供简单的api在物理磁盘中存储或查询消息。
- HA服务,在主Broker和从Broker之间提供数据同步功能。
- 索引服务,根据指定的键为消息构建索引,并提供快速的消息查询。
Producer Cluster(生产者集群):生产者支持分布式部署;分布式生产者通过多种负载均衡模式向Broker集群发送消息;发送过程支持快速失败和低延迟。
Consumer Cluster(消费者集群):消费者也支持Push和Pull模型中的分布式部署;它还支持集群使用和消息广播;它提供了实时消息订阅机制,可以满足大多数用户的需求。
说说RocketMQ核心概念?
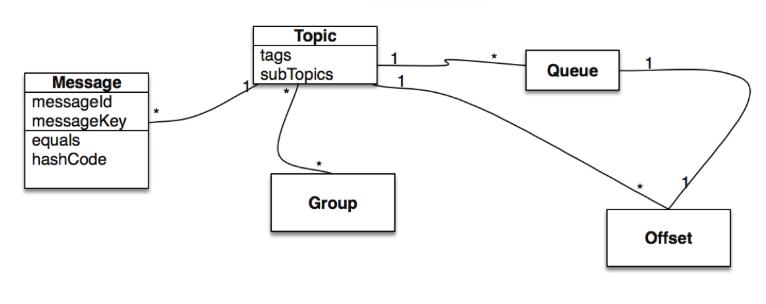
Broker 在实际部署过程中对应一台服务器,每个 Broker 可以存储多个Topic的消息,每个Topic的消息也可以分片存储于不同的 Broker。Message Queue 用于存储消息的物理地址,每个Topic中的消息地址存储于多个 Message Queue 中,ConsumerGroup 由多个Consumer 实例构成。
消息模型
- Clustering:集群消费模式下,相同Consumer Group的每个Consumer实例平均分摊消息。
- Broadcasting:广播消费模式下,相同Consumer Group的每个Consumer实例都接收全量的消息。
生产者组:同一类Producer的集合,这类Producer发送同一类消息且发送逻辑一致。如果发送的是事务消息且原始生产者在发送之后崩溃,则Broker服务器会联系同一生产者组的其他生产者实例以提交或回溯消费。
- Producer(生产者):负责生产消息,一般由业务系统负责生产消息。一个消息生产者会把业务应用系统里产生的消息发送到broker服务器。RocketMQ提供多种发送方式,同步发送、异步发送、顺序发送、单向发送。同步和异步方式均需要Broker返回确认信息,单向发送不需要。
消费者组:同一类Consumer的集合,这类Consumer通常消费同一类消息且消费逻辑一致。消费者组使得在消息消费方面,实现负载均衡和容错的目标变得非常容易。要注意的是,消费者组的消费者实例必须订阅完全相同的Topic。RocketMQ 支持两种消息模式:集群消费(Clustering)和广播消费(Broadcasting)。
- Consumer (消费者):负责消费消息,一般是后台系统负责异步消费。一个消息消费者会从Broker服务器拉取消息、并将其提供给应用程序。从用户应用的角度而言提供了两种消费形式:拉取式消费、推动式消费。
- Pull:主动调用Consumer的拉消息方法从Broker服务器拉消息、主动权由应用控制。一旦获取了批量消息,应用就会启动消费过程。拉取型消费者主动从broker中拉取消息消费,只要拉取到消息,就会启动消费过程,称为主动型消费。
- Push:Broker收到数据后会主动推送给消费端,该消费模式一般实时性较高。推送型消费者就是要注册消息的监听器,监听器是要用户自行实现的。当消息达到broker服务器后,会触发监听器拉取消息,然后启动消费过程。但是从实际上看还是从broker中拉取消息,称为被动消费型。
- push:消费端慢的话导致消费端缓冲区溢出。
- pull:考虑拉的频率,可能导致很多无效请求的RPC开销影响整体网络性能。
- Consumer (消费者):负责消费消息,一般是后台系统负责异步消费。一个消息消费者会从Broker服务器拉取消息、并将其提供给应用程序。从用户应用的角度而言提供了两种消费形式:拉取式消费、推动式消费。
Broker Server :消息中转角色,负责存储消息、转发消息。代理服务器在RocketMQ系统中负责接收从生产者发送来的消息并存储、同时为消费者的拉取请求作准备。代理服务器也存储消息相关的元数据,包括消费者组、消费进度偏移和主题和队列消息等。
TOPIC:主题,表示一类消息的集合,每个主题包含若干条消息,每条消息只能属于一个主题,是RocketMQ进行消息订阅的基本单位。生产者在其中传递消息,消费者在其中提取消息。一个Topic可能有0个、一个或多个生产者向它发送消息;从消费者的角度来看一个主题可以由零个、一个或多个消费者群体订阅。类似地,一个消费者组可以订阅一个或多个主题,只要该组的实例保持订阅一致。
- message queue:消息队列,一个Topic可以划分成多个消息队列。Topic只是个逻辑上的概念,消息队列是消息的物理管理单位,当发送消息的时候,Broker会轮询包含该Topic的所有消息队列,然后将消息发出去。有了消息队列,可以使得消息的存储可以分布式集群化,具有了水平的扩展能力。
- message:消息系统所传输信息的物理载体,生产和消费数据的最小单位,每条消息必须属于一个主题。RocketMQ中每个消息拥有唯一的Message ID,且可以携带具有业务标识的Key。系统提供了通过Message ID和Key查询消息的功能。
- message order:当使用DefaultMQPushConsumer时,可以决定有序或并发地使用消息.
- Orderly:有序地使用消息意味着对于每个消息队列,消息的使用顺序与生产者发送消息的顺序相同。如果您正在处理全局顺序是强制性的场景,请确保您使用的Topic只有一个消息队列;消费者通过同一个消息队列( Topic 分区,称作 Message Queue) 收到的消息是有顺序的,不同消息队列收到的消息则可能是无顺序的。如果指定了有序消费,则消息消费的最大并发性是消费组订阅的消息队列的数量。
- Concurrently:当并发地使用消息时,消息使用的最大并发性仅受为每个客户端指定的线程池的限制;在此模式下不再保证消息顺序。
- 严格顺序消息模式下,消费者收到的所有消息均是有顺序的。
- message order:当使用DefaultMQPushConsumer时,可以决定有序或并发地使用消息.
- tag:为消息设置的标志,用于同一主题下区分不同类型的消息。来自同一业务单元的消息,可以根据不同业务目的在同一主题下设置不同标签。标签能够有效地保持代码的清晰度和连贯性,并优化RocketMQ提供的查询系统。消费者可以根据Tag实现对不同子主题的不同消费逻辑,实现更好的扩展性。
- offset:是指消息队列中的offset,可以认为就是下标,消息队列可看做数组。offset是java long型,64位,理论上100年不会溢出,所以可以认为消息队列是一个长度无限的数据结构。
- RocketMQ支持按照下面两种维度(“按照Message Id查询消息”、“按照Message Key查询消息”)进行消息查询。
RocketMQ集群的工作流程?
- 启动NameServer,NameServer起来后监听端口,等待Broker、Producer、Consumer连上来,相当于一个路由控制中心。
- Broker启动,跟所有的NameServer保持长连接,定时发送心跳包。心跳包中包含当前Broker信息(IP+端口等)以及存储所有Topic信息。注册成功后,NameServer集群中就有Topic跟Broker的映射关系。
- 收发消息前,先创建Topic,创建Topic时需要指定该Topic要存储在哪些Broker上,也可以在发送消息时自动创建Topic。
- Producer发送消息,启动时先跟NameServer集群中的其中一台建立长连接,并从NameServer中获取当前发送的Topic存在哪些Broker上,轮询从队列列表中选择一个队列,然后与队列所在的Broker建立长连接从而向Broker发消息。
- Consumer跟Producer类似,跟其中一台NameServer建立长连接,获取当前订阅Topic存在哪些Broker上,然后直接跟Broker建立连接通道,开始消费消息。
RocketMQ消息存储设计?
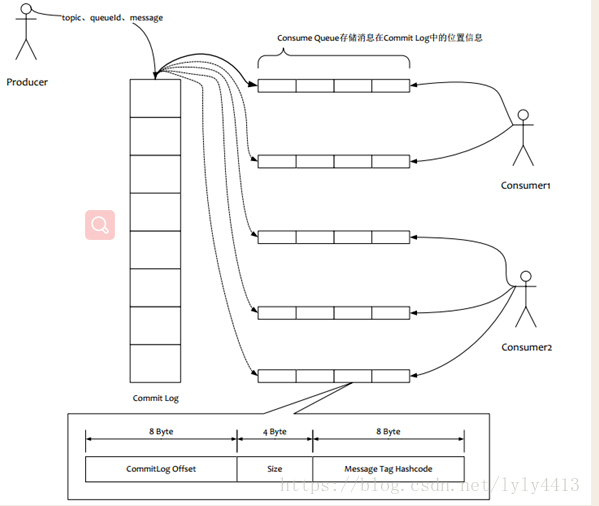
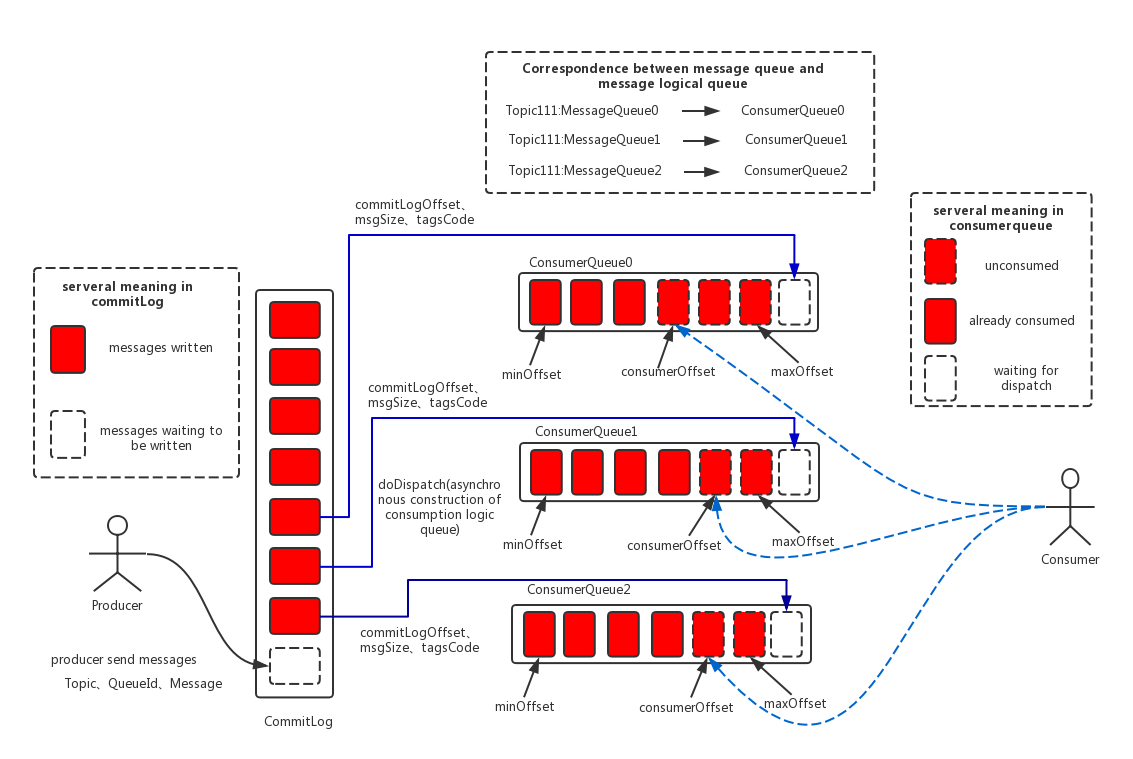
RocketMQ的设计理念很大程度借鉴了kafka,RocketMQ消息存储是整个系统的核心,直接决定着吞吐性能和高可用性;RocketMQ存储消息是直接操作文件,借助java NIO的力量,使得I/O性能十分高。当消息来的时候,顺序写入CommitLog。为了Consumer消费消息的时候,能够方便的根据topic查询消息,在CommitLog的基础上衍生出了ConsumerQueue文件,存放了某topic的消息在CommitLog中的偏移位置。此外为了支持根据消息key查询消息,RocketMQ的强大的支持消息索引的特性靠的就是indexFile索引文件。
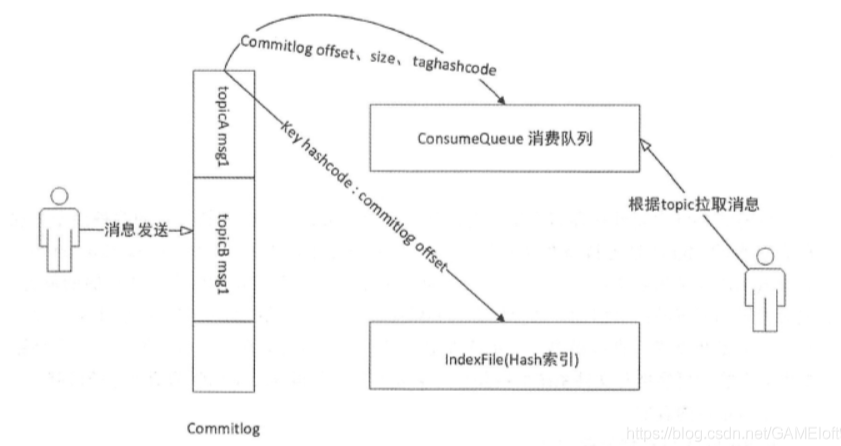
- CommitLog:消息主体以及元数据的存储主体,存储Producer端写入的消息主体内容,消息内容不是定长的。单个文件大小默认1G, 文件名长度为20位,左边补零,剩余为起始偏移量,比如00000000000000000000代表了第一个文件,起始偏移量为0,文件大小为1G=1073741824;当第一个文件写满了,第二个文件为00000000001073741824,起始偏移量为1073741824,以此类推。
- CommitLog文件的最大的一个特点就是消息顺序写入日志文件,当文件满了,写入下一个文件;随机读写,关于commitLog的文件的落盘有两种,一种是同步刷盘,一种是异步刷盘,可通过 flushDiskType 进行配置。
- CommitLog除了消息本身,它记录了消息的方方面面的信息,通过一条CommitLog可以还原出很多东西。例如消息是何时、由哪个producer发送的,被发送到了哪个消息队列,属于哪个topic,有哪些属性等等。RokcetMQ存储的消息其实存储的就是这个CommitLog记录;可以将CommitLog记录等同于消息,而CommitLog指存储消息的文件。
- CommitLog类属性很多,但是最重要的是mappedFileQueue属性。消息最终存储在CommitLog里,实际上CommitLog是一个逻辑上的概念。真正的文件是一个个MappedFile,然后组成了mappedFileQueue。一个MappedFile最多能存放1G的CommitLog,这个大小在MessageStoreConfi类里面定义了的。
- MappedFile 中WriteBuffer使用的是堆外内存,MappedByteBuffer是直接将文件映射到内存中,两者的使用是互斥的。如果启用了临时缓冲池(默认不启用),那么就会使用WriteBuffer写CommitLog,否则就是MappedByteBuffer写CommitLog。
- ConsumeQueue:消息消费队列,引入的目的主要是提高消息消费的性能,由于RocketMQ是基于主题topic的订阅模式,消息消费是针对主题进行的,如果要遍历commitlog文件中根据topic检索消息是非常低效的。Consumer即可根据ConsumeQueue来查找待消费的消息。其中,ConsumeQueue(逻辑消费队列)作为消费消息的索引,保存了指定Topic下的队列消息在CommitLog中的起始物理偏移量offset,消息大小size和消息Tag的HashCode值。consumequeue文件可以看成是基于topic的commitlog索引文件,故consumequeue文件夹的组织方式如下:topic/queue/file三层组织结构,具体存储路径为:$HOME/store/consumequeue/{topic}/{queueId}/{fileName}。同样consumequeue文件采取定长设计,每一个条目共20个字节,分别为8字节的commitlog物理偏移量、4字节的消息长度、8字节tag hashcode,单个文件由30W个条目组成,可以像数组一样随机访问每一个条目,每个ConsumeQueue文件大小约5.72M;
- IndexFile:IndexFile(索引文件)提供了一种可以通过key或时间区间来查询消息的方法。Index文件的存储位置是:\(HOME \store\index\){fileName},文件名fileName是以创建时的时间戳命名的,固定的单个IndexFile文件大小约为400M,一个IndexFile可以保存 2000W个索引,IndexFile的底层存储设计为在文件系统中实现HashMap结构,故RocketMQ的索引文件其底层实现为hash索引。
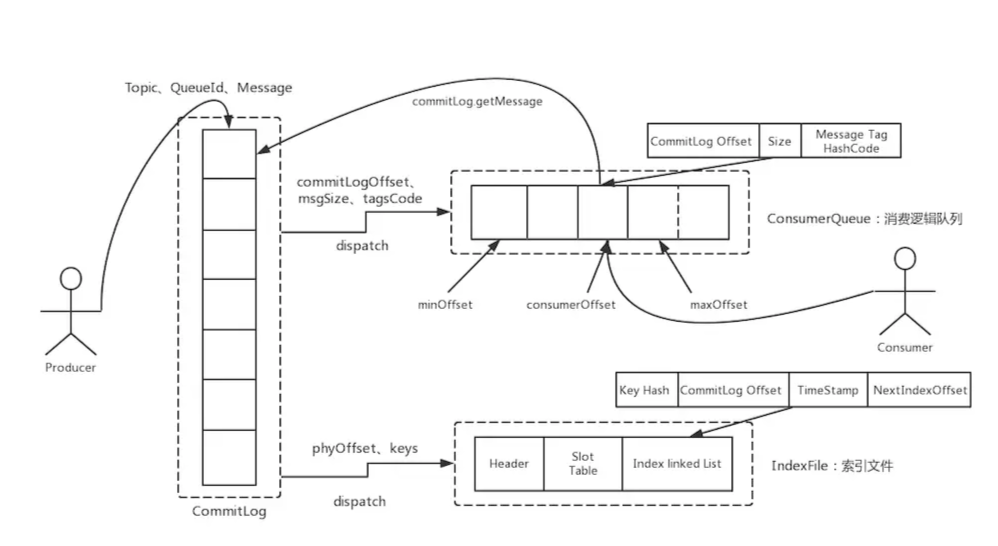
在上面的RocketMQ的消息存储整体架构图中可以看出,RocketMQ采用的是混合型的存储结构,即为Broker单个实例下所有的队列共用一个日志数据文件(即为CommitLog)来存储。RocketMQ的混合型存储结构(多个Topic的消息实体内容都存储于一个CommitLog中)针对Producer和Consumer分别采用了数据和索引部分相分离的存储结构,Producer发送消息至Broker端,然后Broker端使用同步或者异步的方式对消息刷盘持久化,保存至CommitLog中。只要消息被刷盘持久化至磁盘文件CommitLog中,那么Producer发送的消息就不会丢失。正因为如此,Consumer也就肯定有机会去消费这条消息。当无法拉取到消息后,可以等下一次消息拉取,同时服务端也支持长轮询模式,如果一个消息拉取请求未拉取到消息,Broker允许等待30s的时间,只要这段时间内有新消息到达,将直接返回给消费端。这里,RocketMQ的具体做法是,使用Broker端的后台服务线程—ReputMessageService不停地分发请求并异步构建ConsumeQueue(逻辑消费队列)和IndexFile(索引文件)数据。
说说RocketMQ存储底层实现?
- MappedByteBuffer
- RocketMQ主要通过MappedByteBuffer对文件进行读写操作。其中,利用了NIO中的FileChannel模型将磁盘上的物理文件直接映射到用户态的内存地址中(这种Mmap的方式减少了传统IO将磁盘文件数据在操作系统内核地址空间的缓冲区和用户应用程序地址空间的缓冲区之间来回进行拷贝的性能开销),将对文件的操作转化为直接对内存地址进行操作,从而极大地提高了文件的读写效率(正因为需要使用内存映射机制,故RocketMQ的文件存储都使用定长结构来存储,方便一次将整个文件映射至内存)。
- PageCache
- 是OS对文件的缓存,用于加速对文件的读写。一般来说,程序对文件进行顺序读写的速度几乎接近于内存的读写速度,主要原因就是由于OS使用PageCache机制对读写访问操作进行了性能优化,将一部分的内存用作PageCache。对于数据的写入,OS会先写入至Cache内,随后通过异步的方式由pdflush内核线程将Cache内的数据刷盘至物理磁盘上。对于数据的读取,如果一次读取文件时出现未命中PageCache的情况,OS从物理磁盘上访问读取文件的同时,会顺序对其他相邻块的数据文件进行预读取。
- 在RocketMQ中,ConsumeQueue逻辑消费队列存储的数据较少,并且是顺序读取,在page cache机制的预读取作用下,Consume Queue文件的读性能几乎接近读内存,即使在有消息堆积情况下也不会影响性能。而对于CommitLog消息存储的日志数据文件来说,读取消息内容时候会产生较多的随机访问读取,严重影响性能。如果选择合适的系统IO调度算法,比如设置调度算法为“Deadline”(此时块存储采用SSD的话),随机读的性能也会有所提升。
说说RocketMQ文件存储模型层次结构?
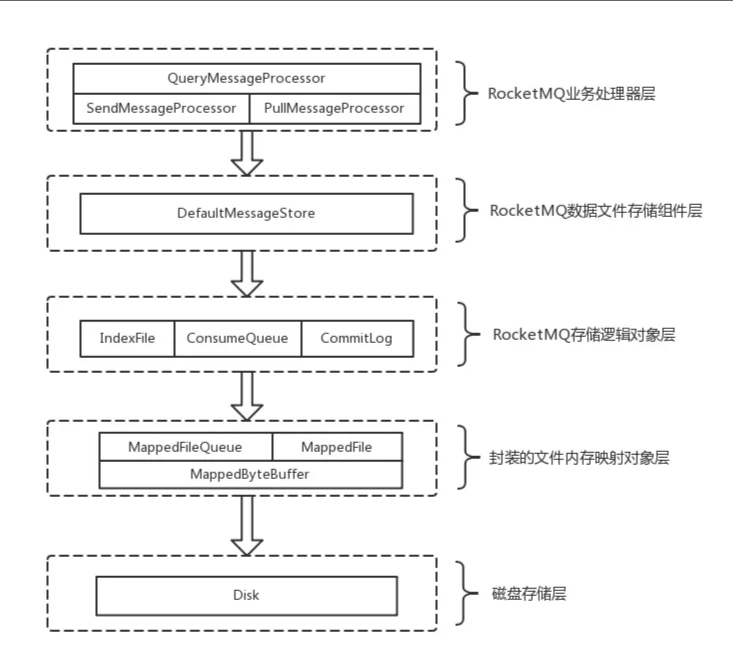
- RocketMQ业务处理器层
- Broker端对消息进行读取和写入的业务逻辑入口,这一层主要包含了业务逻辑相关处理操作(根据解析RemotingCommand中的RequestCode来区分具体的业务操作类型,进而执行不同的业务处理流程),比如前置的检查和校验步骤、构造MessageExtBrokerInner对象、decode反序列化、构造Response返回对象等。
- RocketMQ数据存储组件层
- 该层主要是RocketMQ的存储核心类—DefaultMessageStore,其为RocketMQ消息数据文件的访问入口,通过该类的“putMessage()”和“getMessage()”方法完成对CommitLog消息存储的日志数据文件进行读写操作(具体的读写访问操作还是依赖下一层中CommitLog对象模型提供的方法);另外,在该组件初始化时候,还会启动很多存储相关的后台服务线程,包括AllocateMappedFileService(MappedFile预分配服务线程)、ReputMessageService(回放存储消息服务线程)、HAService(Broker主从同步高可用服务线程)、StoreStatsService(消息存储统计服务线程)、IndexService(索引文件服务线程)等。
- RocketMQ存储逻辑对象层
- 该层主要包含了RocketMQ数据文件存储直接相关的三个模型类IndexFile、ConsumerQueue和CommitLog。IndexFile为索引数据文件提供访问服务,ConsumerQueue为逻辑消息队列提供访问服务,CommitLog则为消息存储的日志数据文件提供访问服务。这三个模型类也是构成了RocketMQ存储层的整体结构(对于这三个模型类的深入分析将放在后续篇幅中)。
- 封装的文件内存映射层
- RocketMQ主要采用JDK NIO中的MappedByteBuffer和FileChannel两种方式完成数据文件的读写。其中,采用MappedByteBuffer这种内存映射磁盘文件的方式完成对大文件的读写,在RocketMQ中将该类封装成MappedFile类。这里限制的问题在上面已经讲过;对于每类大文件(IndexFile/ConsumerQueue/CommitLog),在存储时分隔成多个固定大小的文件(单个IndexFile文件大小约为400M、单个ConsumerQueue文件大小约5.72M、单个CommitLog文件大小为1G),其中每个分隔文件的文件名为前面所有文件的字节大小数+1,即为文件的起始偏移量,从而实现了整个大文件的串联。这里,每一种类的单个文件均由MappedFile类提供读写操作服务(其中,MappedFile类提供了顺序写/随机读、内存数据刷盘、内存清理等和文件相关的服务)。
- 磁盘存储层
- 主要指的是部署RocketMQ服务器所用的磁盘。这里,需要考虑不同磁盘类型(如SSD或者普通的HDD)特性以及磁盘的性能参数(如IOPS、吞吐量和访问时延等指标)对顺序写/随机读操作带来的影响。
如何保证 RocketMQ 不丢失消息?
一条消息从生产到被消费,将会经历生产阶段、存储阶段、消费阶段三个阶段。
生产阶段,Producer 新建消息,然后通过网络将消息投递给 MQ Broker。
生产者(Producer) 通过网络发送消息给 Broker,当 Broker 收到之后,将会返回确认响应信息给 Producer;所以生产者只要接收到返回的确认响应,就代表消息在生产阶段未丢失。
返回消息方式可以是同步也可以是异步,但不管是同步还是异步的方式,都会碰到网络问题导致发送失败的情况。针对这种情况,我们可以设置合理的重试次数,当出现网络问题,可以自动重试。
// 同步发送消息重试次数,默认为 2

mqProducer.setRetryTimesWhenSendFailed(3);

// 异步发送消息重试次数,默认为 2

mqProducer.setRetryTimesWhenSendAsyncFailed(3);
存储阶段,消息将会存储在 Broker 端磁盘中。
默认情况下,消息只要到了 Broker 端,将会优先保存到内存中,然后立刻返回确认响应给生产者。随后 Broker 定期批量的将一组消息从内存异步刷入磁盘。这种方式减少 I/O 次数,可以取得更好的性能,但是如果发生机器掉电,异常宕机等情况,消息还未及时刷入磁盘,就会出现丢失消息的情况。
若想保证 Broker 端不丢消息,保证消息的可靠性,我们需要将消息保存机制修改为同步刷盘方式,即消息存储磁盘成功,才会返回响应。若 Broker 未在同步刷盘时间内(默认为 5s)完成刷盘,将会返回
SendStatus.FLUSH_DISK_TIMEOUT状态给生产者。集群部署:为了保证可用性,Broker 通常采用一主(master)多从(slave)部署方式。为了保证消息不丢失,消息还需要复制到 slave 节点。默认方式下,消息写入 master 成功,就可以返回确认响应给生产者,接着消息将会异步复制到 slave 节点。此时若 master 突然宕机且不可恢复,那么还未复制到 slave 的消息将会丢失。为了进一步提高消息的可靠性,我们可以采用同步的复制方式,master 节点将会同步等待 slave节点复制完成,才会返回确认响应。提高消息的高可靠性,但是会降低性能,生产实践中需要综合选择。
## master 节点配置

flushDiskType = SYNC_FLUSH

brokerRole=SYNC_MASTER

## slave 节点配置

brokerRole=slave

flushDiskType = SYNC_FLUSH
消费阶段, Consumer 将会从 Broker 拉取消息。
消费者从 broker 拉取消息,然后执行相应的业务逻辑。一旦执行成功,将会返回
ConsumeConcurrentlyStatus.CONSUME_SUCCESS状态给 Broker。如果 Broker 未收到消费确认响应或收到其他状态,消费者下次还会再次拉取到该条消息,进行重试。这样的方式有效避免了消费者消费过程发生异常,或者消息在网络传输中丢失的情况。
说说RocketMQ同步异步复制和刷盘?
- 复制
- 为了确保成功发布的消息不会丢失,RocketMQ提供了同步和异步两种复制模式获得更强的持久性和更高的可用性。
- 同步Broker要等到提交日志被复制到从服务器后才进行确认。
- 相反,异步Broker在主服务器上处理消息后立即返回。
- 刷盘
- 同步刷盘:在消息达到Broker的内存之后,必须刷到commitLog日志文件中才算成功,然后返回Producer数据已经发送成功。
- 异步刷盘:异步刷盘是指消息达到Broker内存后就返回Producer数据已经发送成功,会唤醒一个线程去将数据持久化到CommitLog日志文件中。
优缺点分析:同步刷盘保证了消息不丢失,但是响应时间相对异步刷盘要多出10%左右,适用于对消息可靠性要求比较高的场景。异步刷盘的吞吐量比较高,RT小,但是如果broker断电了内存中的部分数据会丢失,适用于对吞吐量要求比较高的场景。
说说RocketMQ负载均衡?
RocketMQ中的负载均衡都在Client端完成,具体来说的话,主要可以分为Producer端发送消息时候的负载均衡和Consumer端订阅消息的负载均衡。
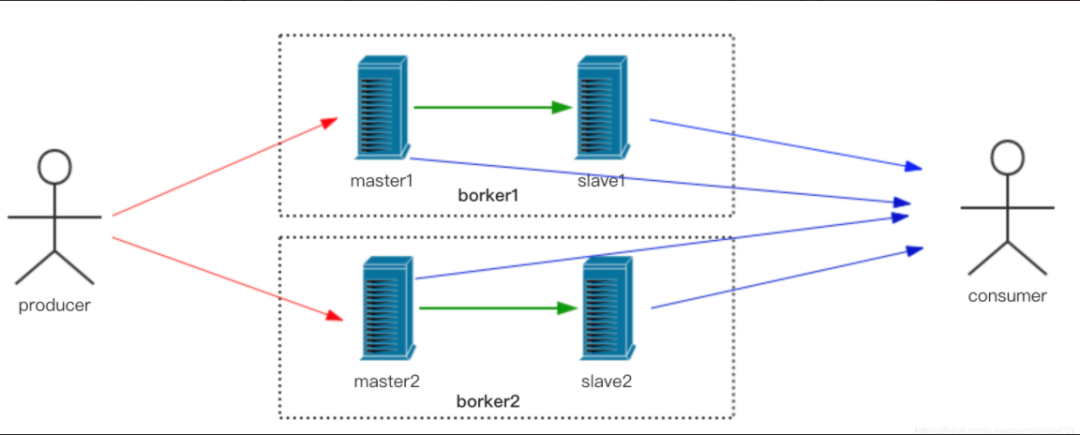
nameServer保存着Topic的路由信息,路由记录了broker集群节点的通讯地址,broker的名称以及读写队列数量等信息。写队列writeQueue表示生产者可以写入的队列数,如果不做配置默认为4,也就是queueId是0,1,2,3.broker收到消息后根据queueId生成消息队列,生产者负载均衡的过程的实质就是选择broker集群和queueId的过程。读队列readQueue表示broker中可以供消费者读取信息的队列个数,默认也是4个,也就是queueId也是0,1,2,3。消费者拿到路由信息后会选择queueId,从对应的broker中读取数据消费
- Producer的负载均衡
- Producer端在发送消息的时候,会先根据Topic找到指定的TopicPublishInfo,在获取了TopicPublishInfo路由信息后,RocketMQ的客户端在默认方式下selectOneMessageQueue()方法会从TopicPublishInfo中的messageQueueList中选择一个队列(MessageQueue)进行发送消息。具体的容错策略均在MQFaultStrategy这个类中定义。这里有一个sendLatencyFaultEnable开关变量,如果开启,在随机递增取模的基础上,再过滤掉not available的Broker代理。所谓的"latencyFaultTolerance",是指对之前失败的,按一定的时间做退避。例如,如果上次请求的latency超过550Lms,就退避3000Lms;超过1000L,就退避60000L;如果关闭,采用随机递增取模的方式选择一个队列(MessageQueue)来发送消息,latencyFaultTolerance机制是实现消息发送高可用的核心关键所在。简单的说选择的标准:尽量不选刚刚选过的broker,尽量不选发送上条消息延迟过高或没有响应的broker,也就是找到一个可用的
- Consumer的负载均衡
- 将MessageQueue中的消息队列分配到消费者组里的具体消费者;Consumer在启动的时候会实例化RebalanceImpl,这个类负责消费端的负载均衡。在Consumer实例的启动流程中的启动MQClientInstance实例部分,会完成负载均衡服务线程—RebalanceService的启动(每隔20s执行一次)。通过查看源码可以发现,RebalanceService线程的run()方法最终调用的是RebalanceImpl类的rebalanceByTopic()方法,该方法是实现Consumer端负载均衡的核心
- 负载均衡算法
- 平均分配算法
- 环形算法
- 指定机房算法
- 就近机房算法
- 一致性哈希算法
- 手动配置算法
RocketMQ如何保证顺序消息?
- 在默认的情况下消息发送会采取Round Robin轮询方式把消息发送到不同的queue(分区队列);而消费消息的时候从多个queue上拉取消息,这种情况发送和消费是不能保证顺序。但是如果控制发送的顺序消息只依次发送到同一个queue中,消费的时候只从这个queue上依次拉取,则就保证了顺序。当发送和消费参与的queue只有一个,则是全局有序;如果多个queue参与,则为分区有序,即相对每个queue,消息都是有序的。顺序消费不能是并发的。
- 怎么保证消息发到同一个queue里?RocketMQ给我们提供了MessageQueueSelector接口,可以重写里面的接口,实现自己的算法,比如判断i%2==0,那就发送消息到queue1否则发送到queue2。
RocketMQ如何实现消息去重?
- 这个得依赖于消息的幂等性原则:就是用户对于同一种操作发起的多次请求的结果是一样的,不会因为操作了多次就产生不一样的结果。只要保持幂等性,不管来多少条消息,最后处理结果都一样,需要Consumer端自行实现。
- 在RocketMQ去重的方案:因为每个消息都有一个MessageId, 保证每个消息都有一个唯一键,可以是数据库的主键或者唯一约束,也可以是Redis缓存中的键,当消费一条消息前,先检查数据库或缓存中是否存在这个唯一键,如果存在就不再处理这条消息,如果消费成功,要保证这个唯一键插入到去重表中。
说说RocketMQ分布式事务消息?
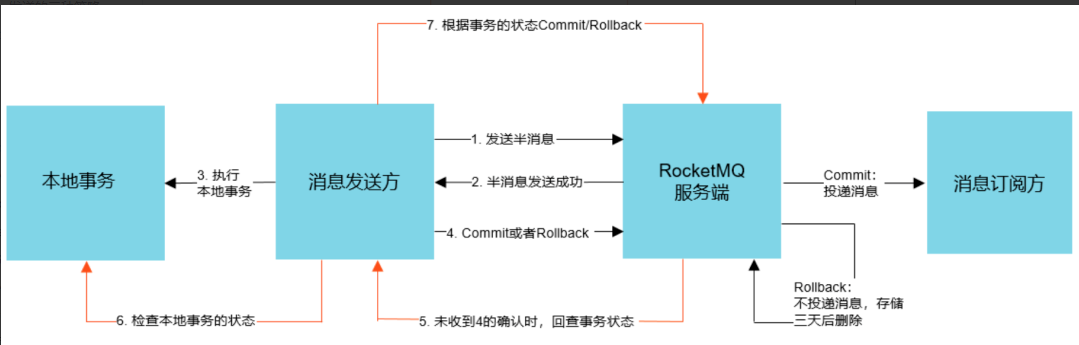
半消息:是指暂时还不能被Consumer消费的消息,Producer成功发送到broker端的消息,但是此消息被标记为“暂不可投递”状态,只有等Producer端执行完本地事务后经过二次确认了之后,Consumer才能消费此条消息。主要分为正常事务消息的发送及提交、事务消息的补偿流程两大块。RocketMQ事务消息依赖半消息,二次确认以及消息回查机制。
- 1、Producer向broker发送半消息
- 2、Producer端收到响应,消息发送成功,此时消息是半消息,标记为“不可投递”状态,Consumer消费不了。
- 3、Producer端执行本地事务。
- 4、正常情况本地事务执行完成,Producer向Broker发送Commit/Rollback,如果是Commit,Broker端将半消息标记为正常消息,Consumer可以消费,如果是Rollback,Broker丢弃此消息。
- 5、异常情况,Broker端迟迟等不到二次确认。在一定时间后,会查询所有的半消息,然后到Producer端查询半消息的执行情况。
- 6、Producer端查询本地事务的状态
- 7、根据事务的状态提交commit/rollback到broker端。(5,6,7是消息回查)
简单归纳RocketMQ高性能原因?
网络模型,RocketMQ 使用 Netty 框架实现高性能的网络传输,也遵循了Reactor多线程模型,同时又在这之上做了一些扩展和优化。而Netty高性能我们在前一篇文章也以学习过,这里就不重复说了。
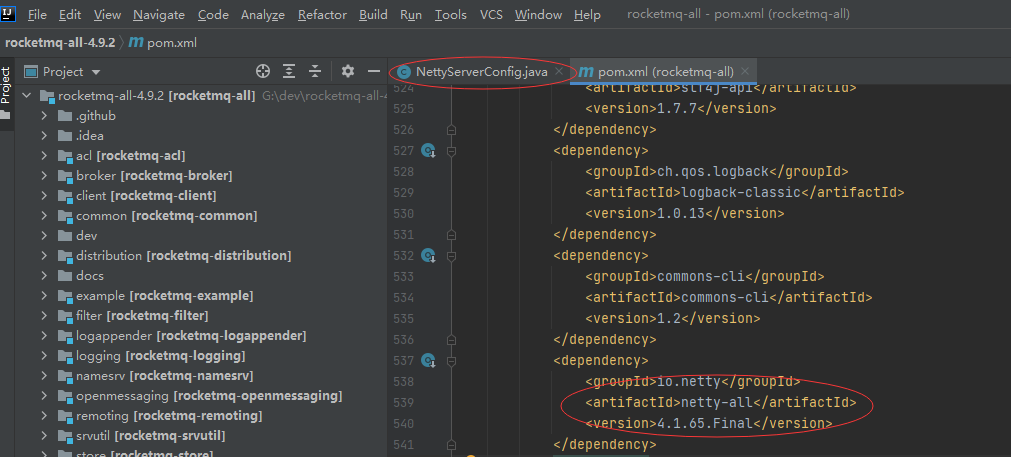
顺序写、随机读、零拷贝。
多主多从,创建topic时,多个message queue可以在多个broker上,master提供读写,从broker可以分担读消息的压力。
同步复制和异步复制。
同步刷盘和异步刷盘(PageCache)。
同步和异步发送消息。
业务线程池隔离,RocketMQ 对 Broker 的线程池进行了精细的隔离。使得消息的生产、消费、客户端心跳、客户端注册等请求不会互相干扰。
并行消费和批量消费。
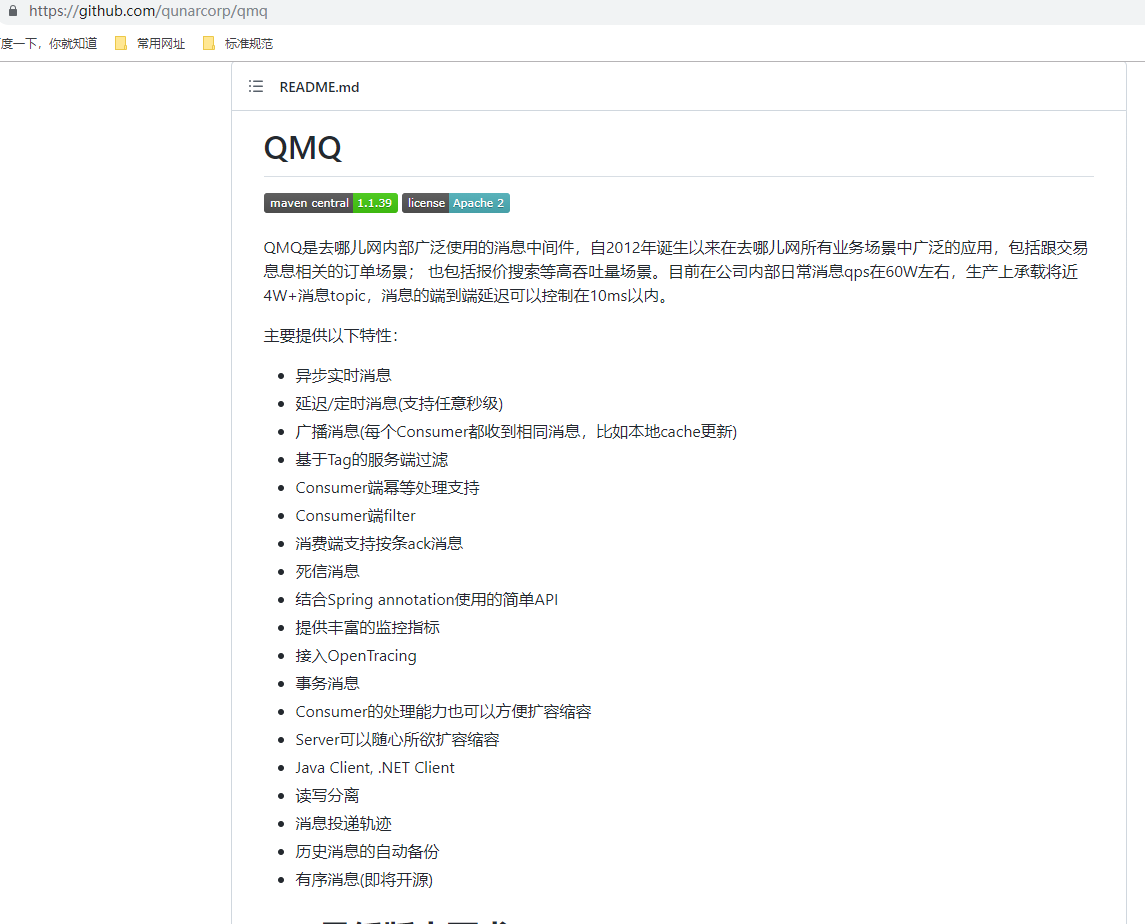
最后:去哪儿网开源的QMQ消息中间件也可以好好的研究,功能非常齐全,消息中间件的应用是比较简单的,更多应该思考和理解主流开源中间件Kafka、RocketMQ、QMQ、Palsar等的设计思想。
Apache RocketMQ分布式消息传递和流数据平台及大厂面试宝典v4.9.2的更多相关文章
- Apache Kafka分布式流处理平台及大厂面试宝典v3.0.0
概述 **本人博客网站 **IT小神 www.itxiaoshen.com 定义 Apache Kafka官网地址 http://kafka.apache.org/ 最新版本为 3.0.0 Apach ...
- 用Apache Kafka构建流数据平台的建议
在<流数据平台构建实战指南>第一部分中,Confluent联合创始人Jay Kreps介绍了如何构建一个公司范围的实时流数据中心.InfoQ前期对此进行过报道.本文是根据第二部分整理而成. ...
- 用Apache Kafka构建流数据平台
近来,有许多关于“流处理”和“事件数据”的讨论,它们往往都与像Kafka.Storm或Samza这样的技术相关.但并不是每个人都知道如何将这种技术引入他们自己的技术栈.于是,Confluent联合创始 ...
- 分布式处理与大数据平台(RabbitMQ&Celery&Hadoop&Spark&Storm&Elasticsearch)
热门的消息队列中间件RabbitMQ,分布式任务处理平台Celery,大数据分布式处理的三大重量级武器:Hadoop.Spark.Storm,以及新一代的数据采集和分析引擎Elasticsearch. ...
- Docker实战(十)之分布式处理与大数据平台
分布式系统和大数据处理平台是目前业界关注的热门技术. 1.RabbitMQ RabbitMQ是一个支持AMQP的开源消息队列实现,由Erlang编写,因以高性能.高可用以及可伸缩性出名.它支持多种客户 ...
- 单机,伪分布式,完全分布式-----搭建Hadoop大数据平台
Hadoop大数据——随着计算机技术的发展,互联网的普及,信息的积累已经到了一个非常庞大的地步,信息的增长也在不断的加快.信息更是爆炸性增长,收集,检索,统计这些信息越发困难,必须使用新的技术来解决这 ...
- 海豚调度5月Meetup:6个月重构大数据平台,帮你避开调度升级改造/集群迁移踩过的坑
当今许多企业都有着技术架构的DataOps程度不够.二次开发成本高.迁移成本高.集群部署混乱等情况,团队在技术选型之后发现并不适合自己的需求,但是迁移成本和难度又比较大,甚至前团队还留下了不少坑,企业 ...
- Pulsar云原生分布式消息和流平台v2.8.0
Pulsar云原生分布式消息和流平台 **本人博客网站 **IT小神 www.itxiaoshen.com Pulsar官方网站 Apache Pulsar是一个云原生的分布式消息和流媒体平台,最初创 ...
- Apache RocketMQ 正式开源分布式事务消息
近日,Apache RocketMQ 社区正式发布4.3版本.此次发布不仅包括提升性能,减少内存使用等原有特性增强,还修复了部分社区提出的若干问题,更重要的是该版本开源了社区最为关心的分布式事务消息, ...
随机推荐
- 多边形——————区间dp
原题链接:https://www.acwing.com/problem/content/285/ 题意简单来说就是:给你一个环,断掉一条边使其成为一个链,用这个链跑dp,求最大得分. 首先这不是一道板 ...
- linux ar
转载:Linux ar命令 | 菜鸟教程 (runoob.com) Linux ar命令用于建立或修改备存文件,或是从备存文件中抽取文件. ar可让您集合许多文件,成为单一的备存文件.在备存文件中,所 ...
- 汇编--LDR
转载:https://my.oschina.net/zengsai/blog/23733 ARM LDR 伪指令的格式: LDR Rn, =expr 如果name是立即数的话LDR R0,=0X123 ...
- VIVADO 2017.4配置MIG IP注意事项
1.2GB的single rank SODIMMs配置pin还是和以前一样没有问题: 2.8GB SODIMMs配置pin需要注意4点: (1).所有的DDR3引脚都需要在连续的BANK上,例如Z71 ...
- Vue2高级原理
<div id="app"> <input type="text" v-model="username"> ...
- Downward API —— 在容器内部获取 Pod 信息
我们知道,每个 Pod 在被超过创建出来之后,都会被系统分配唯一的名字.IP地址,并且处于某个 Namespace 中,那么我们如何在 Pod 的容器内获取 Pod 的这些重要信息呢? 答案就是使用 ...
- 理解ASP.NET Core - 日志(Logging)
注:本文隶属于<理解ASP.NET Core>系列文章,请查看置顶博客或点击此处查看全文目录 快速上手 添加日志提供程序 在文章主机(Host)中,讲到Host.CreateDefault ...
- Redis核心原理与实践--事务实践与源码分析
Redis支持事务机制,但Redis的事务机制与传统关系型数据库的事务机制并不相同. Redis事务的本质是一组命令的集合(命令队列).事务可以一次执行多个命令,并提供以下保证: (1)事务中的所有命 ...
- Linux mem 2.5 Buddy 内存回收机制
文章目录 1. 简介 2. LRU 组织 2.1 LRU 链表 2.2 LRU Cache 2.3 LRU 移动操作 2.3.1 page 加入 LRU 2.3.2 其他 LRU 移动操作 3. LR ...
- celery tasks always in pending
Result backend doesn't work or tasks are always in PENDING state¶All tasks are PENDING by default, s ...