
大数据SQL中的Join谓词下推,真的那么难懂?
听到谓词下推这个词,是不是觉得很高大上,找点资料看了半天才能搞懂概念和思想,借这个机会好好学习一下吧。
引用范欣欣大佬的博客中写道,以前经常满大街听到谓词下推,然而对谓词下推却总感觉懵懵懂懂,并不明白的很真切。这里拿出来和大家交流交流。个人认为谓词下推有两个层面的理解:
其一是逻辑执行计划优化层面的说法,比如SQL语句:select * from order ,item where item.id = order.item_id and item.category = ‘book’,正常情况语法解析之后应该是先执行Join操作,再执行Filter操作。通过谓词下推,可以将Filter操作下推到Join操作之前执行。即将where item.category = ‘book’下推到 item.id = order.item_id之前先行执行。
其二是真正实现层面的说法,谓词下推是将过滤条件从计算进程下推到存储进程先行执行,注意这里有两种类型进程:计算进程以及存储进程。计算与存储分离思想,这在大数据领域相当常见,比如最常见的计算进程有SparkSQL、Hive、impala等,负责SQL解析优化、数据计算聚合等,存储进程有HDFS(DataNode)、Kudu、HBase,负责数据存储。正常情况下应该是将所有数据从存储进程加载到计算进程,再进行过滤计算。谓词下推是说将一些过滤条件下推到存储进程,直接让存储进程将数据过滤掉。这样的好处显而易见,过滤的越早,数据量越少,序列化开销、网络开销、计算开销这一系列都会减少,性能自然会提高。
谓词下推 Predicate Pushdown(PPD):简而言之,就是在不影响结果的情况下,尽量将过滤条件提前执行。谓词下推后,过滤条件在map端执行,减少了map端的输出,降低了数据在集群上传输的量,节约了集群的资源,也提升了任务的性能。
PPD 配置
PPD控制参数:hive.optimize.ppd,默认值:true
PPD规则:
| Preserved Row tables | Null Supplying tables | |
|---|---|---|
| Join Predicate | Case J1: Not Pushed | Case J2: Pushed |
| Where Predicate | Case W1: Pushed | Case W2: Not Pushed |
Push:谓词下推,可以理解为被优化
Not Push:谓词没有下推,可以理解为没有被优化
实验
实验结果列表形式:
| Pushed or Not | SQL |
|---|---|
| Pushed | select ename,dept_name from E join D on ( E.dept_id = D.dept_id and E.eid='HZ001'); |
| Pushed | select ename,dept_name from E join D on E.dept_id = D.dept_id where E.eid='HZ001'; |
| Pushed | select ename,dept_name from E join D on ( E.dept_id = D.dept_id and D.dept_id='D001'); |
| Pushed | select ename,dept_name from E join D on E.dept_id = D.dept_id where D.dept_id='D001'; |
| Not Pushed | select ename,dept_name from E left outer join D on ( E.dept_id = D.dept_id and E.eid='HZ001'); |
| Pushed | select ename,dept_name from E left outer join D on E.dept_id = D.dept_id where E.eid='HZ001'; |
| Pushed | select ename,dept_name from E left outer join D on ( E.dept_id = D.dept_id and D.dept_id='D001'); |
| Not Pushed | select ename,dept_name from E left outer join D on E.dept_id = D.dept_id where D.dept_id='D001'; |
| Pushed | select ename,dept_name from E right outer join D on ( E.dept_id = D.dept_id and E.eid='HZ001'); |
| Not Pushed | select ename,dept_name from E right outer join D on E.dept_id = D.dept_id where E.eid='HZ001'; |
| Not Pushed | select ename,dept_name from E right outer join D on ( E.dept_id = D.dept_id and D.dept_id='D001'); |
| Pushed | select ename,dept_name from E right outer join D on E.dept_id = D.dept_id where D.dept_id='D001'; |
| Not Pushed | select ename,dept_name from E full outer join D on ( E.dept_id = D.dept_id and E.eid='HZ001'); |
| Not Pushed | select ename,dept_name from E full outer join D on E.dept_id = D.dept_id where E.eid='HZ001'; |
| Not Pushed | select ename,dept_name from E full outer join D on ( E.dept_id = D.dept_id and D.dept_id='D001'); |
| Not Pushed | select ename,dept_name from E full outer join D on E.dept_id = D.dept_id where D.dept_id='D001'; |
实验结果表格形式:
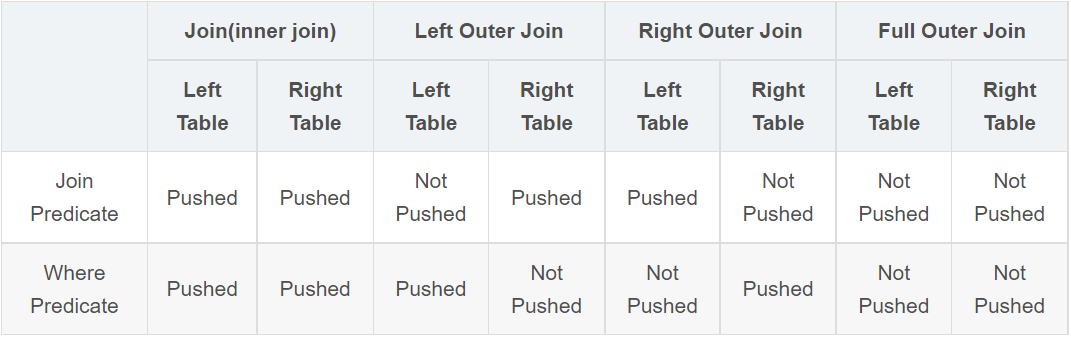
此表实际上就是上述PPD规则表。
结论
1、对于Join(Inner Join)、Full outer Join,条件写在on后面,还是where后面,性能上面没有区别;
2、对于Left outer Join ,右侧的表写在on后面、左侧的表写在where后面,性能上有提高;
3、对于Right outer Join,左侧的表写在on后面、右侧的表写在where后面,性能上有提高;
4、当条件分散在两个表时,谓词下推可按上述结论2和3自由组合,情况如下:
| SQL | 过滤时机 |
|---|---|
select ename,dept_name from E left outer join D on ( E.dept_id = D.dept_id and E.eid='HZ001' and D.dept_id = 'D001'); |
dept_id在map端过滤,eid在reduce端过滤 |
select ename,dept_name from E left outer join D on ( E.dept_id = D.dept_id and D.dept_id = 'D001') where E.eid='HZ001'; |
dept_id,eid都在map端过滤 |
select ename,dept_name from E left outer join D on ( E.dept_id = D.dept_id and E.eid='HZ001') where D.dept_id = 'D001'; |
dept_id,eid都在reduce端过滤 |
select ename,dept_name from E left outer join D on ( E.dept_id = D.dept_id ) where E.eid='HZ001' and D.dept_id = 'D001'; |
dept_id在reduce端过滤,eid在map端过滤 |
注意:如果在表达式中含有不确定函数,整个表达式的谓词将不会被pushed,例如
select a.*

from a join b on a.id = b.id

where a.ds = '2019-10-09' and a.create_time = unix_timestamp();
因为unix_timestamp是不确定函数,在编译的时候无法得知,所以,整个表达式不会被pushed,即ds='2019-10-09'也不会被提前过滤。类似的不确定函数还有rand()等。
参考文献:
[1] https://cwiki.apache.org/confluence/display/Hive/OuterJoinBehavior
引用:https://blog.csdn.net/strongyoung88/article/details/81156271
猜你喜欢
Hive计算最大连续登陆天数
Hadoop 数据迁移用法详解
Hbase修复工具Hbck
数仓建模分层理论
一文搞懂Hive的数据存储与压缩
大数据组件重点学习这几个
大数据SQL中的Join谓词下推,真的那么难懂?的更多相关文章
- SparkSQL大数据实战:揭开Join的神秘面纱
本文来自 网易云社区 . Join操作是数据库和大数据计算中的高级特性,大多数场景都需要进行复杂的Join操作,本文从原理层面介绍了SparkSQL支持的常见Join算法及其适用场景. Join背景介 ...
- 最强最全面的大数据SQL经典面试题(由31位大佬共同协作完成)
本套SQL题的答案是由许多小伙伴共同贡献的,1+1的力量是远远大于2的,有不少题目都采用了非常巧妙的解法,也有不少题目有多种解法.本套大数据SQL题不仅题目丰富多样,答案更是精彩绝伦! 注:以下参考答 ...
- 开发一个不需要重写成Hive QL的大数据SQL引擎
摘要:开发一款能支持标准数据库SQL的大数据仓库引擎,让那些在Oracle上运行良好的SQL可以直接运行在Hadoop上,而不需要重写成Hive QL. 本文分享自华为云社区< ...
- SQL中inner join、outer join和cross join的区别
对于SQL中inner join.outer join和cross join的区别简介:现有两张表,Table A 是左边的表.Table B 是右边的表.其各有四条记录,其中有两条记录name是相同 ...
- SQL中关于Join、Inner Join、Left Join、Right Join、Full Join、On、 Where区别
前言: 今天主要的内容是要讲解SQL中关于Join.Inner Join.Left Join.Right Join.Full Join.On. Where区别和用法,不用我说其实前面的这些基本SQL语 ...
- 【转载】SQL中inner join、outer join和cross join的区别
对于SQL中inner join.outer join和cross join的区别很多人不知道,我也是别人问起,才查找资料看了下,跟自己之前的认识差不多, 如果你使用join连表,缺陷的情况下是inn ...
- LINQ TO SQL 中的join(转帖)
http://www.cnblogs.com/ASPNET2008/archive/2008/12/21/1358152.html join对于喜欢写SQL的朋友来说还是比较实用,也比较容易接受的东西 ...
- Hbase和Hive在大数据架构中处在不同位置
先放结论:Hbase和Hive在大数据架构中处在不同位置,Hbase主要解决实时数据查询问题,Hive主要解决数据处理和计算问题,一般是配合使用.一.区别:Hbase: Hadoop database ...
- sql中的join
首先准备数据 有以下数据,三张表:role(角色表).hero(英雄表).skill(技能表),我们以英雄联盟的数据做示例 一个hero对应一个role(我们这里暂定) 一个role可以对应多个her ...
随机推荐
- js原型和原型链理解 constructor 构造函数
一.对象:普通对象 函数对象 二.构造函数特点:1.需要new实例化,内部使用this对象指向即将要生成的实例对象 2.首字母大写,用于区分普通函数 function Person(name){ ...
- 解决联想R720双系统Ubuntu16.04的无线网卡开启问题及信号不稳定
问题一:1.问题描述笔记本型号:Lenovo r720笔记本(i5-7300hq,gtx1060 maxq 6g),默认装入Win10系统,然而当装入Ubuntu16.04双系统时,会出现无线网卡(型 ...
- RabbitMQ 3.9.7 镜像模式集群与Springboot 2.5.5 整合
1. 概述 老话说的好:做人要懂得变通,善于思考,有时稍微转个弯,也许问题就解决了. 言归正传,之前我们聊了 RabbitMQ 3.9.7 镜像模式集群的搭建,今天我们来聊聊 RabbitMQ 3.9 ...
- 转载 使用wce进行本地和域的hash注入
参数解释:-l 列出登录的会话和NTLM凭据(默认值)-s 修改当前登录会话的NTLM凭据 参数:<用户名>:<域名>:<LM哈希>:<NT哈希>-r ...
- VulnHub 实战靶场Breach-1.0
相比于CTF题目,Vulnhub的靶场更贴近于实际一些,而且更加综合考察了知识.在这里记录以下打这个靶场的过程和心得. 测试环境 Kali linux IP:192.168.110.128 Breac ...
- 02Prism WPF 入门实战 - 建项
1.概要 Prism介绍 Github: https://github.com/PrismLibrary/Prism 开发文档:https://prismlibrary.com/docs/ Prism ...
- 【Java技术专题】「性能优化系列」针对Java对象压缩及序列化技术的探索之路
序列化和反序列化 序列化就是指把对象转换为字节码: 对象传递和保存时,保证对象的完整性和可传递性.把对象转换为有字节码,以便在网络上传输或保存在本地文件中: 反序列化就是指把字节码恢复为对象: 根据字 ...
- 初探JavaScript PDF blob转换为Word docx方法
PDF转WORD为什么是历史难题 PDF 转Word 是一个非常非常普遍的需求,可谓人人忌危,为什么如此普遍的需求,却如此难行呢,还得看为什么会有这样的一个需求: PDF文档遵循iOS32000的规范 ...
- 【java】【作业】定义课程信息;继承和组合练习
问题: 定义课程信息类,包含课程编号.课程名称及学生成绩.编程实现对软件工程专业的某班级的所有课程成绩统计,包括平均成绩.最高成绩.最低成绩,并打印成绩等级分布律. 分析 初分析: 父类(课程信息类) ...
- 改善深层神经网络-week3编程题(Tensorflow 实现手势识别 )
TensorFlow Tutorial Initialize variables Start your own session Train algorithms Implement a Neural ...