
[特征工程] encoding
参考:An Overview of Encoding Techniques | Kaggle
Method 1: Label encoding
给每个类别以一个数字label,作为分类。将类别映射到自然数数值空间上
from sklearn.preprocessing import LabelEncoder

train=pd.DataFrame()

label=LabelEncoder()

for c in  X.columns:

    if(X[c].dtype=='object'):

        train[c]=label.fit_transform(X[c])

    else:

        train[c]=X[c]
Method 2 : One hot encoding
即独热码,每一个category对应特征向量中的一位,对应位置是否为1判定是否为该类。
可以使用pd.get_dummies()或sklearn.preprocessing中OneHotEncoder
from sklearn.preprocessing import OneHotEncoder

one=OneHotEncoder(

one.fit(X)

train=one.transform(X)
Method 3 : Feature Hashing/Hashing Trick
一个“one hot encoding style” 的编码方式,将数据编入特定维数的散度矩阵中,降维中使用了hash方法。
from sklearn.feature_extraction import FeatureHasher

X_train_hash=X.copy()

for c in X.columns:

    X_train_hash[c]=X[c].astype('str')

hashing=FeatureHasher(input_type='string')

train=hashing.transform(X_train_hash.values)
Method 4 :Encoding categories with dataset statistics
尝试为模型提供较低维的每个类别的表示,且其中类似的类别的表示相近。 最简单的方法是将每个类别替换为我们在数据集中看到它的次数,即用出现频率作为他们的embedding。
X_train_stat=X.copy()

for c in X_train_stat.columns:

    if(X_train_stat[c].dtype=='object'):

        X_train_stat[c]=X_train_stat[c].astype('category')

        counts=X_train_stat[c].value_counts()

        counts=counts.sort_index()

        counts=counts.fillna(0)

        counts += np.random.rand(len(counts))/1000

        X_train_stat[c].cat.categories=counts
对于循环出现的特征,例如日期,星期等,常用sin\cos将其转为二维空间中的数据。这是基于“循环”的性质,类似于对圆进行分割。
X_train_cyclic=X.copy()

columns=['day','month']

for col in columns:

    X_train_cyclic[col+'_sin']=np.sin((2*np.pi*X_train_cyclic[col])/max(X_train_cyclic[col]))

    X_train_cyclic[col+'_cos']=np.cos((2*np.pi*X_train_cyclic[col])/max(X_train_cyclic[col]))

X_train_cyclic=X_train_cyclic.drop(columns,axis=1)
one=OneHotEncoder()

one.fit(X_train_cyclic)

train=one.transform(X_train_cyclic)
Method 5 : Target encoding
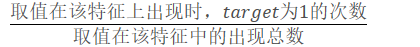
Target encoding 通过目标数据对类别变量进行编码,使用目标对应概率或平均概率替换该类别,即出现频次相近的被视为同一类(大城市,热门项等)。这个方法比较依赖训练集与测试集合的分布,要求他们数据分布一致。另外,这种方法可能会导致过拟合。
X_target=df_train.copy()

X_target['day']=X_target['day'].astype('object')

X_target['month']=X_target['month'].astype('object')

for col in X_target.columns:

    if (X_target[col].dtype=='object'):

        target= dict ( X_target.groupby(col)['target'].agg('sum')/X_target.groupby(col)['target'].agg('count'))

        X_target[col]=X_target[col].replace(target).values
为了减轻过拟合可能带来的影响,可以使用K-Fold Validation ,每次对一份样本进行目标编码时,使用的都是其他K-1份数据之中的数据。
X['target']=y

cols=X.drop(['target','id'],axis=1).columns

%%time

X_fold=X.copy()

X_fold[['ord_0','day','month']]=X_fold[['ord_0','day','month']].astype('object')

X_fold[['bin_3','bin_4']]=X_fold[['bin_3','bin_4']].replace({'Y':1,'N':0,'T':1,"F":0})

kf = KFold(n_splits = 5, shuffle = False, random_state=2019)

for train_ind,val_ind in kf.split(X):

    for col in cols:

        if(X_fold[col].dtype=='object'):

            replaced=dict(X.iloc[train_ind][[col,'target']].groupby(col)['target'].mean())

            X_fold.loc[val_ind,col]=X_fold.iloc[val_ind][col].replace(replaced).values
此外,在对特征进行编码前也需要进行特征种类的区分。常分为:
- 0-1数值:只有两种取值,可映射到0,1
- 类别数值:多个类别,这也是最常见的数据。
- 时序数据:时间戳等,隐含了顺序信息,可以反应趋势。
[特征工程] encoding的更多相关文章
- 机器学习-特征工程-Missing value和Category encoding
好了,大家现在进入到机器学习中的一块核心部分了,那就是特征工程,洋文叫做Feature Engineering.实际在机器学习的应用中,真正用于算法的结构分析和部署的工作只占很少的一部分,相反,用于特 ...
- 特征工程(Feature Engineering)
一.什么是特征工程? "Feature engineering is the process of transforming raw data into features that bett ...
- 机器学习-特征工程-Feature generation 和 Feature selection
概述:上节咱们说了特征工程是机器学习的一个核心内容.然后咱们已经学习了特征工程中的基础内容,分别是missing value handling和categorical data encoding的一些 ...
- 【Python数据挖掘】第六篇--特征工程
一.Standardization 方法一:StandardScaler from sklearn.preprocessing import StandardScaler sds = Standard ...
- AI学习笔记:特征工程
一.概述 Andrew Ng:Coming up with features is difficult, time-consuming, requires expert knowledge. &quo ...
- Alink漫谈(十) :特征工程 之 特征哈希/标准化缩放
Alink漫谈(十) :特征工程之特征哈希/标准化缩放 目录 Alink漫谈(十) :特征工程之特征哈希/标准化缩放 0x00 摘要 0x01 相关概念 1.1 特征工程 1.2 特征缩放(Scali ...
- 使用sklearn做单机特征工程
目录 1 特征工程是什么?2 数据预处理 2.1 无量纲化 2.1.1 标准化 2.1.2 区间缩放法 2.1.3 标准化与归一化的区别 2.2 对定量特征二值化 2.3 对定性特征哑编码 2.4 缺 ...
- 特征工程(Feature Enginnering)学习记要
最近学习特征工程(Feature Enginnering)的相关技术,主要包含两块:特征选取(Feature Selection)和特征抓取(Feature Extraction).这里记录一些要点 ...
- 【转】使用sklearn做单机特征工程
这里是原文 说明:这是我用Markdown编辑的第一篇随笔 目录 1 特征工程是什么? 2 数据预处理 2.1 无量纲化 2.1.1 标准化 2.1.2 区间缩放法 2.1.3 无量纲化与正则化的区别 ...
随机推荐
- js实现全选与全部取消功能
function checkAll() { //把所有参与选择的checkbox使用相同的name,这里为"num_iid" var eles = document.getE ...
- python实现高斯图像金字塔
一,定义 图像金字塔:同一图像的不同分辨率的子图集合,其生成方式有向上取样和向下取样.向下取样是从G0采样形成分辨率较低的G1,G1再采样形成分辨率较低的G2......,就构成了一个金字塔.向下取样 ...
- [atAGC050F]NAND Tree
当$n$为偶数,暴力$o(n)$枚举第一次操作,以下只考虑$n$为奇数的情况 此时,$n-1$即操作次数为偶数,找到最小的$i$(其中$1\le i\le \frac{n-1}{2}$),满足第$2i ...
- [tc14634]ExtremeSpanningTrees
保序回归论文题 要求某一个边集为原图的最小生成树,这等价于非树边比所在环(指树上)的所有边小,最大生成树类似 将这些大小关系的限制看作一张有向图,即若要求$w_{i}\le w_{j}$则连边$(i, ...
- MyBatis-Plus中如何使用ResultMap
MyBatis-Plus (简称MP)是一个MyBatis的增强工具,在MyBatis的基础上只做增强不做改变,为简化开发.提高效率而生. MyBatis-Plus对MyBatis基本零侵入,完全可以 ...
- 收集的常用的CTF学习资源网站
http://www.sec-wiki.com/skill/ 安全技能学习路线(迷茫就看它) https://wiki.x10sec.org/ 介绍了CTF各个方向的基础知识 ...
- bsp工程管理
1. bsp工程管理的目的 模块化项目,使得项目清晰 2. 代码 拷贝原来工程 创建文件夹 bsp就是工程驱动文件 imx6ull是和芯片有关的文件 obj是生成文件的文件夹 project 工程文件 ...
- 用图像识别玩Chrome断网小游戏
先来看一下效果 正文 最近在学习机器学习方面的知识,想着做个东西玩玩,然后就接触到了TensorFlow这个机器学习框架,这个框架封装了机器学习的一些常用算法. 不过要自己实现一套流程还是比较麻烦,我 ...
- 为了拿捏 Redis 数据结构,我画了 40 张图(完整版)
大家好,我是小林. Redis 为什么那么快? 除了它是内存数据库,使得所有的操作都在内存上进行之外,还有一个重要因素,它实现的数据结构,使得我们对数据进行增删查改操作时,Redis 能高效的处理. ...
- seq生成格式化字符
[root@ansz.quan.bbs ~]$seq -s "+" 10 1+2+3+4+5+6+7+8+9+10 seq为生成数字序列 -s 分隔符