
hadoop学习笔记(一):NameNade持久化和DataNode概念
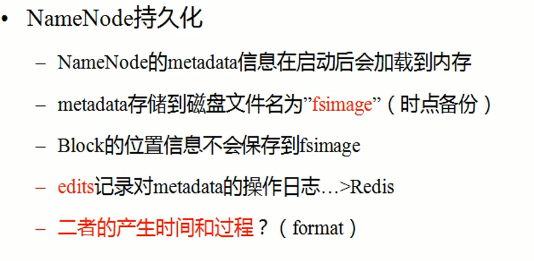
其中的fsimage 称为时点备份,又叫磁盘镜像快照,这个是NameNode的一个
持久化的方式之一:缺点,在内存数据序列化的时候比较慢
具体的过程:因为我们所知道的NameNode一般是存储在内存中的,并没有和磁盘进行交互,这和redis这类的非关系型数据库差不多,但是内存中的数据总是没有持久化的,那么怎么去持久化呢?就比如我们的NameNode结点数据的持久化过程:先将内存中的数据序列化为二进制字节流,之后将其通过IO的形式存入到计算机的文件系统中,就完成了持久化的过程,具体的如果NameNode需要数据的过程的时候,需要将外存中的字节码文件,反序列化,之后加载到内存中,就可以供NameNode使用了
注意点:时点快照:只会按规定的间隔一段时间之后再去持久化到外存中,如13点,15点,17点。。。。而不是每一秒都在进行持久化,因为这样的话又会频繁的和外存也就是磁盘进行交互,这样数据的获取的时间就会很长了
持久化的方式之二:缺点,在数据存入外存的过程不慢,但是当存外存恢复到内存的时候比较慢
edits记录对metadata的操作日志。。。>Redis
即日志编辑方式:1)数据存入外村会将客户端对服务器中的任何的一条指令都写入到操作日志log这个文件当中 2)数据从外存加载到内存中:直接再执行一遍log中的指令即可。
此方式也是时隔一段规定的时间才回去持久化,而不是实时的
********Hadoop集群中NameNode的信息一般的是将这两个结合起来持久化的
下面是具体的持久化 的过程:
但是怎么去将这两种方式结合起来使用呢?首先先要理解fsimage文件和edits文件的产生的时候,对于fsimage文件是产生于搭建hadoop集群系统的时候,此时产生的文件是空的。edits的产生时机:集群启动的时候,会产生一个edits log文件,此时的文件也是空的,之后启动完毕之后,log文件会和fsimage文件进行合并,之后log一直会增大,因为集群启动之后,客户端会不断的通过NameNode实时的向集群发送指令,这都会记录到log文件中,这个时候 所带来的问题:log文件一直会增大,所以此时更不能通过edits进行恢复数据了,时间会很长,所以hadoop会通过SecondNameNode有时对edits和fsimage文件进行合并
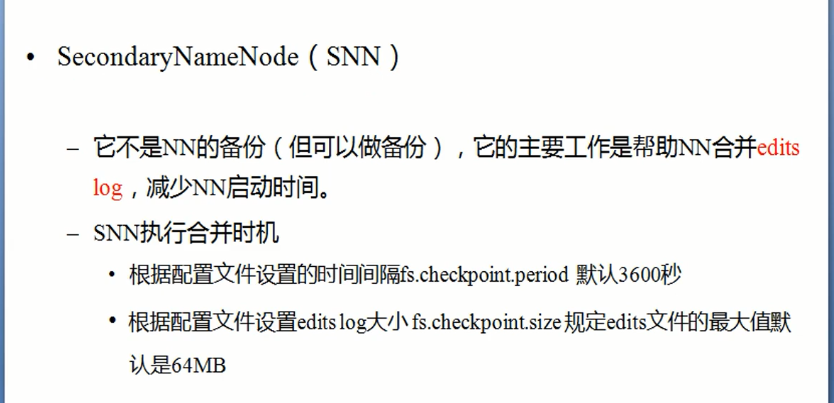
SecondaryNameNode概念:并不是nameNode的备份,而仅仅是为了合并fsimage文件和log文件出现的这个
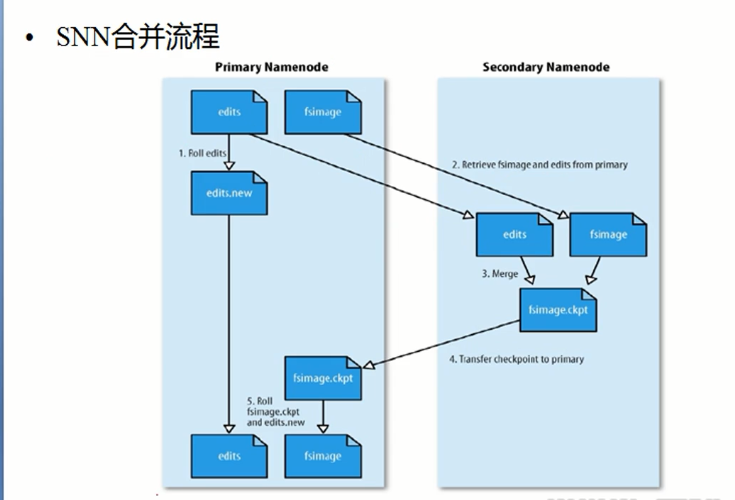
具体的合并过程
刚刚集群搭建完毕之后:生成了一个空的fsimage,之后启动了系统之后,就会产生一个fsimage文件,之后客户端对NameNode进行发送指令记录在edits中,所以edits会变大,但是通过第二主节点的检查,当edits达到一定的大小之后,便不会让他继续的去记录指令了,NameNode就会将所在结点(也就是主结点)edits传输至第二主节点进行合并处理,同时主结点的edits会清空,为了以后再次接受指令记录的时候仍然从0的大小开始增长。合并之后会发送给NameNode,将原有的主结点中的fsimage进行替代,之后主结点中的那个edits会从新的开始记录客户端发送的指令,之后整个此过程重复即可。但是这个是hadoop1.0时候的持久化的NameNode数据处理机制。在2.x版本之后,这个SecondaryNameNode就消失了
DataNode学习理解

hadoop学习笔记(一):NameNade持久化和DataNode概念的更多相关文章
- hadoop学习笔记(四):HDFS文件权限,安全模式,以及整体注意点总结
本文原创,转载注明作者和原文链接! 一:总结注意点: 到现在为止学习到的角色:三个NameNode.SecondaryNameNode.DataNode 1.存储的是每一个文件分割存储之后的元数据信息 ...
- Hadoop学习笔记—22.Hadoop2.x环境搭建与配置
自从2015年花了2个多月时间把Hadoop1.x的学习教程学习了一遍,对Hadoop这个神奇的小象有了一个初步的了解,还对每次学习的内容进行了总结,也形成了我的一个博文系列<Hadoop学习笔 ...
- Hadoop学习笔记(2)
Hadoop学习笔记(2) ——解读Hello World 上一章中,我们把hadoop下载.安装.运行起来,最后还执行了一个Hello world程序,看到了结果.现在我们就来解读一下这个Hello ...
- Hadoop学习笔记(2) ——解读Hello World
Hadoop学习笔记(2) ——解读Hello World 上一章中,我们把hadoop下载.安装.运行起来,最后还执行了一个Hello world程序,看到了结果.现在我们就来解读一下这个Hello ...
- Hadoop学习笔记(1) ——菜鸟入门
Hadoop学习笔记(1) ——菜鸟入门 Hadoop是什么?先问一下百度吧: [百度百科]一个分布式系统基础架构,由Apache基金会所开发.用户可以在不了解分布式底层细节的情况下,开发分布式程序. ...
- Hadoop学习笔记(1)(转)
Hadoop学习笔记(1) ——菜鸟入门 Hadoop是什么?先问一下百度吧: [百度百科]一个分布式系统基础架构,由Apache基金会所开发.用户可以在不了解分布式底层细节的情况下,开发分布式程序. ...
- Hadoop学习笔记(10) ——搭建源码学习环境
Hadoop学习笔记(10) ——搭建源码学习环境 上一章中,我们对整个hadoop的目录及源码目录有了一个初步的了解,接下来计划深入学习一下这头神象作品了.但是看代码用什么,难不成gedit?,单步 ...
- Hadoop学习笔记(9) ——源码初窥
Hadoop学习笔记(9) ——源码初窥 之前我们把Hadoop算是入了门,下载的源码,写了HelloWorld,简要分析了其编程要点,然后也编了个较复杂的示例.接下来其实就有两条路可走了,一条是继续 ...
- Hadoop学习笔记(7) ——高级编程
Hadoop学习笔记(7) ——高级编程 从前面的学习中,我们了解到了MapReduce整个过程需要经过以下几个步骤: 1.输入(input):将输入数据分成一个个split,并将split进一步拆成 ...
随机推荐
- 【转载】Hibernate关系映射
1. 单向一对一关联映射(one-to-one): 两个对象之间一对的关系,例如:Person(人)-IdCard(身份证) 有两种策略可以实现一对一的关联映射: *主键关联:即让两个对 ...
- windows下划分逻辑分区
运行命令窗口后,我们输入命令"diskpart"回车! 然后我们在DISKPART>后面输入select disk 0 选择我们的硬盘,然后回车!当然如果你电脑上有好几块硬盘 ...
- Java第一个程序HelloWorld
1.创建一个java源文件:HelloWorld.java public class HelloWorld{ public static void main(String[] args){ Syste ...
- Java-POJ1011-sticks
很经典的搜索题,直接爆搜会卡在连续相同长度的木棍,可以先排序,预处理该长度不行直接跳下一长度木棍的位置 但此题特殊,木棍长度小于50,我们可以直接桶排序 还有就是关于回溯的理解: 我们写的dfs为的是 ...
- 5.springboot-------Yaml
springboot配置文件: Yaml是什么玩意? Yaml的基本语法 编写规则 1.大小写敏感,同json: 2.通过缩进表示层级关系:符号含义 注意事项:字符串默认不需要加上单引号或双引号. # ...
- 启动docker报Failed to start Docker Application Container Engine.解决
[root@docker ~]# systemctl status docker.service● docker.service - Docker Application Container Engi ...
- 每日扫盲:eclipse快捷键 包括查找类、方法、变量汇总
[Ct rl+T] 搜索当前接口的实现类 1. [ALT +/] 此快捷键为用户编辑的好帮手,能为用户提供内容的辅助,不要为记不全方法和属性名称犯愁,当记不全类.方法和属性的名字时,多体验一下[ ...
- 牛客腾讯2020校园招聘-后台&综合-第一次笔试
第一题 Q: 小Q想要给他的朋友发送一个神秘字符串,但是他发现字符串的过于长了,于是小Q发明了一种压缩算法对字符串中重复的部分进行了压缩,对于字符串中连续的m个相同字符串S将会压缩为m|S,例如字符串 ...
- webview在compileSdkVersion 大于等于23 android6.0以上系统执行js代码异常,但是在compileSdkVersion小于23 android6.0以下系统却执行正常问题
问题分析: 在compileSdkVersion>=23 android6.0以上webview.loadUrl用这个方法执行js时会将js中的一些代码当做特殊字符处理, 比如js中var t= ...
- Gevent和猴子补丁
定义 在2018年看Flutent python时了解到猴子补丁,知道咋回事,但是现在通过代码更深刻认识猴子补丁. 猴子补丁:在运行时修改类或模块,而不改动源码. 例子1 没有用猴子补丁 import ...