
pytorch adam 源码 关于优化函数的调整 optimizer 调参 重点
关于优化函数的调整
拆下包:https://ptorch.com/docs/1/optim
class torch.optim.Optimizer(params, defaults)
所有优化的基类.
参数:
params (iterable) —— 可迭代的Variable 或者 dict。指定应优化哪些变量。
defaults-(dict):包含优化选项的默认值的dict(一个参数组没有指定的参数选项将会使用默认值)。
load_state_dict(state_dict)
加载optimizer状态
参数:
state_dict (dict) —— optimizer的状态。应该是state_dict()调用返回的对象。
state_dict()
将优化器的状态返回为一个dict。
它包含两个内容:
state - 持有当前optimization状态的dict。它包含了 优化器类之间的不同。
param_groups - 一个包含了所有参数组的dict。
step(closure)
执行单个优化步骤(参数更新)。
不同的优化算子
参考:莫烦大神视频,传送门不给直接百度搜就好;
首先给出基本的四种更换优化算子的代码:
SGD 就是随机梯度下降
opt_SGD = torch.optim.SGD(net_SGD.parameters(), lr=LR)
momentum 动量加速,在SGD函数里指定momentum的值即可
opt_Momentum = torch.optim.SGD(net_Momentum.parameters(), lr=LR, momentum=0.8)
RMSprop 指定参数alpha
opt_RMSprop = torch.optim.RMSprop(net_RMSprop.parameters(), lr=LR, alpha=0.9)
Adam 参数betas=(0.9, 0.99)
opt_Adam = torch.optim.Adam(net_Adam.parameters(), lr=LR, betas=(0.9, 0.99))
#再看下官方文档
class torch.optim.Adam(params, lr=0.001, betas=(0.9, 0.999), eps=1e-08, weight_decay=0)[source]
实现Adam算法。
它在Adam: A Method for Stochastic Optimization中被提出。
#参数:
params (iterable) – 用于优化的可以迭代参数或定义参数组

lr (float, 可选) – 学习率(默认:1e-3)

betas (Tuple[float, float], 可选) – 用于计算梯度运行平均值及其平方的系数(默认:0.9,    0.999)

eps (float, 可选) – 增加分母的数值以提高数值稳定性(默认:1e-8)

weight_decay (float, 可选) – 权重衰减(L2范数)(默认: 0)

step(closure)  #执行单个优化步骤。
#参数:
closure (callable,可选) – 重新评估模型并返回损失的闭包。
注意:momentum是梯度下降法中一种常用的加速技术。对于一般的SGD,其表达式为,沿负梯度方向下降。而带momentum项的SGD则写生如下形式:
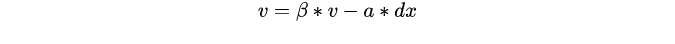
其中即momentum系数,通俗的理解上面式子就是,如果上一次的momentum(即)与这一次的负梯度方向是相同的,那这次下降的幅度就会加大,所以这样做能够达到加速收敛的过程。
关于学习率的调整
首先在一开始的时候我们可以给我们的神经网络附一个“经验性”的学习率:
lr=1e-3 #SGD
lr=1e-3 #Adam一般要求学习率比较小
接着,假设对于不同层想给予不同的学习率怎么办呢?
参考:https://www.cnblogs.com/hellcat/p/8496727.html
# 直接对不同的网络模块制定不同学习率 classifiter的学习率设置为1e-2,所有的momentum=0.9
optimizer = optim.SGD([{‘params’: net.features.parameters()}, # 默认lr是1e-5
{‘params’: net.classifiter.parameters(), ‘lr’: 1e-2}], lr=1e-5,momentum=0.9)
##=======================以层为单位,为不同层指定不同的学习率
## 提取指定层对象为classifiter模块的第0个和第3个
special_layers = t.nn.ModuleList([net.classifiter[0], net.classifiter[3]])
## 获取指定层参数id
special_layers_params = list(map(id, special_layers.parameters()))
print(special_layers_params)
## 获取非指定层的参数id
base_params = filter(lambda p: id§ not in special_layers_params, net.parameters())
optimizer = t.optim.SGD([{‘params’: base_params},
{‘params’: special_layers.parameters(), ‘lr’: 0.01}], lr=0.001)
当你发现你的loss在训练过程中居然还上升了,那么一般来讲,是你此时的学习率设置过大了。这时候我们需要动态调整我们的学习率:
def adjust_learning_rate(optimizer, epoch, t=10):
“”“Sets the learning rate to the initial LR decayed by 10 every t epochs,default=10"”"
new_lr = lr * (0.1 ** (epoch // t))
for param_group in optimizer.param_groups:
param_group[‘lr’] = new_lr
官方文档中还给出用
torch.optim.lr_scheduler 基于循环的次数提供了一些方法来调节学习率.
torch.optim.lr_scheduler.ReduceLROnPlateau 基于验证测量结果来设置不同的学习率.
参考:https://ptorch.com/docs/1/optim
其他调参的策略
1.L2-正则化防止过拟合
weight decay(权值衰减),其最终目的是防止过拟合。在机器学习或者模式识别中,会出现overfitting,而当网络逐渐overfitting时网络权值逐渐变大,因此,为了避免出现overfitting,会给误差函数添加一个惩罚项,常用的惩罚项是所有权重的平方乘以一个衰减常量之和。其用来惩罚大的权值。在损失函数中,weight decay是放在正则项(regularization)前面的一个系数,正则项一般指示模型的复杂度,所以weight decay的作用是调节模型复杂度对损失函数的影响,若weight decay很大,则复杂的模型损失函数的值也就大。
这个在定义优化器的时候可以通过参数 【weight_decay,一般建议0.0005】来设置:
opt_Adam = torch.optim.Adam(net_Adam.parameters(), lr=LR, betas=(0.9, 0.99), eps=1e-06, weight_decay=0.0005)
2、batch normalization。batch normalization的是指在神经网络中激活函数的前面,将按照特征进行normalization,这样做的好处有三点:
提高梯度在网络中的流动。Normalization能够使特征全部缩放到[0,1],这样在反向传播时候的梯度都是在1左右,避免了梯度消失现象。
提升学习速率。归一化后的数据能够快速的达到收敛。
减少模型训练对初始化的依赖。
减少参数选择的依赖
一些通常的解释:https://blog.csdn.net/hjimce/article/details/50866313
3、加入dropout层:dropout一般设置为0.5
4、集成方法
最后,在训练过程中关于loss的一些说明:
参考:https://blog.csdn.net/LIYUAN123ZHOUHUI/article/details/74453980
1 train loss 不断下降,test loss 不断下降,说明网络正在学习
2 train loss 不断下降,test loss 趋于不变,说明网络过拟合
3 train loss 趋于不变,test loss 趋于不变,说明学习遇到瓶颈,需要减小学习率或者批处理大小
4 train loss 趋于不变,test loss 不断下降,说明数据集100%有问题
5 train loss 不断上升,test loss 不断上升(最终变为NaN),可能是网络结构设计不当,训练超参数设置不当,程序bug等某个问题引起
作者:angnuan123
来源:CSDN
原文:https://blog.csdn.net/angnuan123/article/details/81604727
版权声明:本文为博主原创文章,转载请附上博文链接!
相关文章
pytorch adam 源码 关于优化函数的调整 optimizer 调参 重点的更多相关文章
- 梯度下降优化算法综述与PyTorch实现源码剖析
现代的机器学习系统均利用大量的数据,利用梯度下降算法或者相关的变体进行训练.传统上,最早出现的优化算法是SGD,之后又陆续出现了AdaGrad.RMSprop.ADAM等变体,那么这些算法之间又有哪些 ...
- pytorch bert 源码解读
https://daiwk.github.io/posts/nlp-bert.html 目录 概述 BERT 模型架构 Input Representation Pre-training Tasks ...
- [源码解析] PyTorch分布式优化器(1)----基石篇
[源码解析] PyTorch分布式优化器(1)----基石篇 目录 [源码解析] PyTorch分布式优化器(1)----基石篇 0x00 摘要 0x01 从问题出发 1.1 示例 1.2 问题点 0 ...
- [源码解析] PyTorch分布式优化器(2)----数据并行优化器
[源码解析] PyTorch分布式优化器(2)----数据并行优化器 目录 [源码解析] PyTorch分布式优化器(2)----数据并行优化器 0x00 摘要 0x01 前文回顾 0x02 DP 之 ...
- [源码解析] PyTorch分布式优化器(3)---- 模型并行
[源码解析] PyTorch分布式优化器(3)---- 模型并行 目录 [源码解析] PyTorch分布式优化器(3)---- 模型并行 0x00 摘要 0x01 前文回顾 0x02 单机模型 2.1 ...
- ELMo解读(论文 + PyTorch源码)
ELMo的概念也是很早就出了,应该是18年初的事情了.但我仍然是后知后觉,居然还是等BERT出来很久之后,才知道有这么个东西.这两天才仔细看了下论文和源码,在这里做一些记录,如果有不详实的地方,欢迎指 ...
- [源码解析] PyTorch 流水线并行实现 (1)--基础知识
[源码解析] PyTorch 流水线并行实现 (1)--基础知识 目录 [源码解析] PyTorch 流水线并行实现 (1)--基础知识 0x00 摘要 0x01 历史 1.1 GPipe 1.2 t ...
- [源码解析] PyTorch 分布式之弹性训练(2)---启动&单节点流程
[源码解析] PyTorch 分布式之弹性训练(2)---启动&单节点流程 目录 [源码解析] PyTorch 分布式之弹性训练(2)---启动&单节点流程 0x00 摘要 0x01 ...
- [源码解析] PyTorch 分布式之弹性训练(4)---Rendezvous 架构和逻辑
[源码解析] PyTorch 分布式之弹性训练(4)---Rendezvous 架构和逻辑 目录 [源码解析] PyTorch 分布式之弹性训练(4)---Rendezvous 架构和逻辑 0x00 ...
随机推荐
- python之特点
.python区分大小写:2.注释规范:python使用井号#作为单行注释,且注释的位置,一般放在要注释代码的前一行或这代码的右侧:多行注释则可以用连续三个单引号开始一行,并连续三个单引号在要注释的代 ...
- 优化 Tengine HTTPS 握手时间
背景 网络延迟是网络上的主要性能瓶颈之一.在最坏的情况下,客户端打开一个链接需要DNS查询(1个 RTT),TCP握手(1个 RTT),TLS 握手(2个RTT),以及最后的 HTTP 请求和响应,可 ...
- 第十章—DOM(一)——Document类型
DOCUMENT类型 JS通过document类型表示文档,在文档中document对象是HTMLDocument的一个实例,表示整个HTML页面.document对象是window对象的一个属性,因 ...
- sqlserver 大数据量的insert、delete操作优化
http://blog.csdn.net/lanyuzhen/article/details/7547476 --大批量导出orders表:insert DBCC DROPCLEANBUFFERS ...
- linux系统 (实验二)实验楼的课程笔记
who am i 打印用户名和终端 终端的启动时间 whoami 打印用户名 who 命令其它常用参数 参数 说明 -a 打印能打印的全部 -d 打印死掉的进程 -m 同am i,mom li ...
- Linux 上GCC的静态编译和动态编译
静态编译 常规编译示例: $gcc xxx.c yyy.c zzz.c -o rslt 注明: gcc编译器会对源文件min.c进行预处理, 编译, 以及链接, 最后生成可执行文件 $gcc -c x ...
- TYVJ1340 送礼物
P1340 送礼物 时间: 1000ms / 空间: 131072KiB / Java类名: Main 描述 作为惩罚,GY被遣送去帮助某神牛给女生送礼物(GY:貌似是个好差事)但是在GY看到礼物之后 ...
- 利用UIWebView打造一个炫酷的视频背景视图(OC & Swift)
http://www.cocoachina.com/ios/20151023/13860.html 2015-10-6更新:适配 Swift2.0 如有需要,可以通过pjin.elvin@gmail. ...
- 2019-11-12-WPF-添加窗口消息钩子方法
title author date CreateTime categories WPF 添加窗口消息钩子方法 lindexi 2019-11-12 18:46:53 +0800 2019-06-05 ...
- [转]GDB调试基础
一.gdb常用命令: 命令 描述 backtrace(或bt) 查看各级函数调用及参数 finish 连续运行到当前函数返回为止,然后停下来等待命令 frame(或f) 帧编号 选择栈帧 info(或 ...