
myrocks之事务处理
前言
mysql目前支持的事务引擎有innodb,tokudb. rocksdb加入mysql阵营后,mysql支持的事务引擎增长至3个。
myrocks目前支持的事务隔离级别有read-committed和repeatable-read. 同innodb一样,myrocks也支持MVCC机制。
可以说,myrocks提供了很好的事务支持,能够满足的一般业务的事务需求。
sequence number
谈到rocksdb事务,就必须提及rocksdb中的sequence number机制。rocksdb中的每一条记录都有一个sequence number, 这个sequence number存储在记录的key中。
InternalKey: | User key (string) | sequence number (7 bytes) | value type (1 byte) |
对于同样的User key记录,在rocksdb中可能存在多条,但他们的sequence number不同。
sequence number是实现事务处理的关键,同时也是MVCC的基础。
snapshot
snapshot是rocksdb的快照信息,snapshot实际就是对应一个sequence number.
简单的讲,假设snapshot的sequence number为Sa, 那么对于此snapshot来说,只能看到sequence number<=sa的记录,sequence number<=sa的记录是不可见的。
- snapshot 结构
snapshot 主要包含sequence number和snapshot创建时间,sequence number 取自当前的sequence number.
class SnapshotImpl : public Snapshot {

  SequenceNumber number_;  // sequenct number

  int64_t unix_time_;      // snapshow创建时间

  ......

};
snapshot 管理
snapshot由全局双向链表管理,根据sequence number排序。snapshot的创建和删除都需要维护双向链表。snapshot与compact
rocksdb的compact操作与snapshot有紧密联系。以我们熟悉的innodb为例,rocksdb的compact类似于innodb的purge操作, 而snapshot类似于InnoDB的read view. innodb做purge操作时会根据已有的read view来判断哪些undo log可以purge,而rocksdb的compact操作会根据已有snapshot信息即全局双向链表来判断哪些记录在compace时可以清理。判断的大体原则是,从全局双向链表取出最小的snapshot sequence number Sn. 如果已删除的老记录sequence number <=Sn, 那么这些老记录在compact时可以清理掉。
MVCC
有了snapshot,MVCC实现起来就很顺利了。记录的sequence number天然的提供了记录的多版本信息。
每次查询用户记录时,并不需要加锁。而是根据当前的sequence number Sn创建一个snapshot, 查询过程中只取小于或等于Sn的最大sequence number的记录。查询结束时释放snapshot.
关键代码段
DBIter::FindNextUserEntryInternal

 if (ikey.sequence <= sequence_) {

   if (skipping &&

      user_comparator_->Compare(ikey.user_key, saved_key_.GetKey()) <= ) {

     num_skipped++;  // skip this entry

     PERF_COUNTER_ADD(internal_key_skipped_count, );

   } else {

     switch (ikey.type) {

       case kTypeDeletion:

       case kTypeSingleDeletion:

         // Arrange to skip all upcoming entries for this key since

         // they are hidden by this deletion.

         saved_key_.SetKey(

             ikey.user_key,

             !iter_->IsKeyPinned() || !pin_thru_lifetime_ /* copy */);

         skipping = true;

         num_skipped = ;

         PERF_COUNTER_ADD(internal_delete_skipped_count, );

         break;

       case kTypeValue:

         valid_ = true;

         saved_key_.SetKey(

             ikey.user_key,

             !iter_->IsKeyPinned() || !pin_thru_lifetime_ /* copy */);

         return;

       case kTypeMerge:

       ......
隔离级别
隔离级别也是通过snapshot来实现的。在innodb中,隔离级别为read-committed时,事务中每的个stmt都会建立一个read view, 隔离级别为repeatable-read时,只在事务开启时建立一次read view. rocksdb同innodb类似,隔离级别为read-committed时,事务中每的个stmt都会建立一个snapshot, 隔离级别为repeatable-read时,只在事务开启时第一个stmt建立一次snapshot.
关键代码片段
rocksdb_commit:

  if (my_core::thd_tx_isolation(thd) <= ISO_READ_COMMITTED)

  {

    // For READ_COMMITTED, we release any existing snapshot so that we will

    // see any changes that occurred since the last statement.

    tx->release_snapshot();

  }
- 隔离级别实现差异
在read committed隔离级别下,如果一个大事务要更新1000w行,当它更新了前900w行时,
同时另一个事务已经更新了后100w行,那么myrocks会重新获取快照,再次尝试更新,这样 更新的是新提交的数据,也符合read committed逻辑。具体的讨论可以参考最近的issue#340. 而之前的处理方式是直接报死锁错误。
rocksdb::Status ha_rocksdb::get_for_update(

    Rdb_transaction*             tx,

    rocksdb::ColumnFamilyHandle* column_family,

    const rocksdb::Slice&        key,

    std::string*                 value) const

{

  rocksdb::Status s= tx->get_for_update(column_family, key, value);

  // If we have a lock conflict and we are running in READ COMMITTTED mode

  // release and reacquire the snapshot and then retry the get_for_update().

  if (s.IsBusy() && my_core::thd_tx_isolation(ha_thd()) == ISO_READ_COMMITTED)

  {

    tx->release_snapshot();

    tx->acquire_snapshot(false);

    s= tx->get_for_update(column_family, key, value);

  }

  return s;

}
innodb不会出现上述情况,当第一个大事更新是会持有b树的index lock, 第二个事务会一直等待index lock直至第一个事务提交完成。
锁
myrocks目前只支持一种锁类型:排他锁(X锁),并且所有的锁信息都保存在内存中。
- 锁结构
每个锁实际上存储的哪条记录被哪个事务锁住。
struct LockInfo {

  TransactionID txn_id;

  // Transaction locks are not valid after this time in us

  uint64_t expiration_time;

  ......

  }
每个锁实际是key和LockInfo的映射. 锁信息都保存在map中
struct LockMapStripe {

  std::unordered_map<std::string, LockInfo> keys;

  ......

}
为了减少全局锁信息访问的冲突, rocksdb将锁信息进行按key hash分区,
struct LockMap {

    std::vector<LockMapStripe*> lock_map_stripes_;

}
同时每个column family 存储一个这样的LockMap.
using LockMaps = std::unordered_map<uint32_t, std::shared_ptr<LockMap>>;

LockMaps lock_maps_;
锁相关参数:
max_num_locks:事务锁个数限制
expiration:事务过期时间
通过设置以上两个参数,来控制事务锁占用过多的内存。
- 死锁检测
rocksdb内部实现了简单的死锁检测机制,每次加锁发生等待时都会向下面的map中插入一条等待信息,表示一个事务id等待另一个事务id.
同时会检查wait_txn_map_是否存在等待环路,存在环路则发生死锁。
std::unordered_map<TransactionID, TransactionID> wait_txn_map_;
死锁检测关键代码片段
TransactionLockMgr::IncrementWaiters:

    for (int i = ; i < txn->GetDeadlockDetectDepth(); i++) {

      if (next == id) {

        DecrementWaitersImpl(txn, wait_id);

        return true;

      } else if (wait_txn_map_.count(next) == ) {

        return false;

      } else {

        next = wait_txn_map_[next];

      }

    }
死锁检测相关参数
deadlock_detect:是否开启死锁检测
deadlock_detect_depth:死锁检查深度,默认50
gap lock
innodb中是存在gap lock的,主要是为了实现repeatable read和唯一性检查的。
而在rocksdb中,不支持gap lock(rocksdb insert是也会多对唯一键加锁,以防止重复插入,
严格的来讲也算是gap lock).那么在rocksdb一些需要gap lock的地方,目前是报错和打印日志来处理的。
相关参数
gap_lock_write_log: 只打印日志,不返回错误
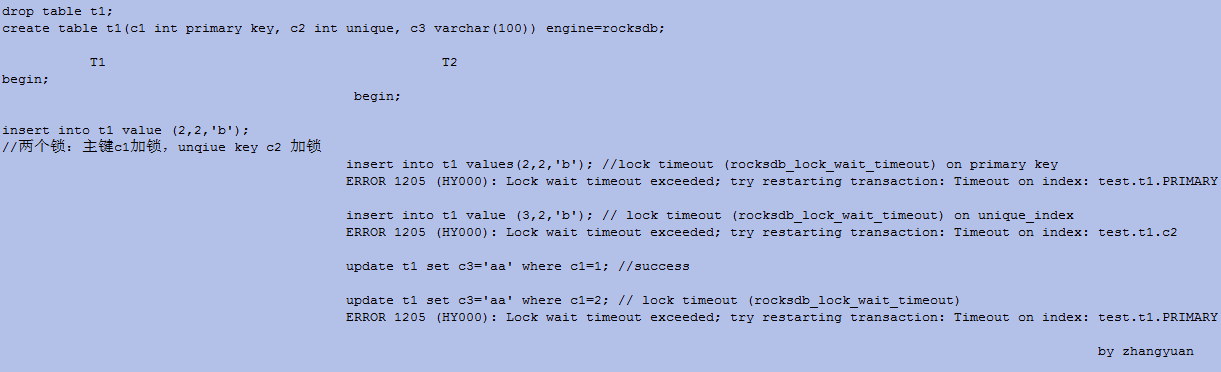
gap_lock_raise_error: 打印日志并且返回错误锁示例
直接看例子
binlog XA & 2pc
myrocks最近也支持了binlog xa.
在开启binlog的情况下,myrocks提交时,会经历两阶段提交阶段。
prepare阶段,根据server层生成的xid(由MySQLXid+server_id+qurey_id组成),在rockdb内部执行2pc操作,生成Prepare(xid),EndPrepare()记录。
commit阶段,根据事务成还是失败,生成Commit(xid)或Rollback(xid)记录。
rocksdb 2pc参考这里
总结
myrocks在事务处理方面还有些不完善的地方,比如锁类型只有单一的X锁,不支持gap lock,纯内存锁占用内存等。 myrocks社区正在持续改进中,一起期待。
myrocks之事务处理的更多相关文章
- myrocks记录格式分析
概况 rocksdb作为KV存储引擎,那么myrocks记录最终会以kv的形式存储在rocksdb中.MySQL中的表一般由若干索引组成, 在innodb存储引擎中,每个索引对应一颗B树,而在rock ...
- In-Memory:内存优化表的事务处理
内存优化表(Memory-Optimized Table,简称MOT)使用乐观策略(optimistic approach)实现事务的并发控制,在读取MOT时,使用多行版本化(Multi-Row ve ...
- myrocks复制中断问题排查
背景 mysql可以支持多种不同的存储引擎,innodb由于其高效的读写性能,并且支持事务特性,使得它成为mysql存储引擎的代名词,使用非常广泛.随着SSD逐渐普及,硬件存储成本越来越高,面向写优化 ...
- 读书笔记--SQL必知必会20--管理事务处理
20.1 事务处理 使用事务处理(transaction processing),通过确保成批的SQL操作要么完全执行,要么完全不执行,来维护数据库的完整性. 如果没有错误发生,整组语句提交给数据库表 ...
- EntityFramework 事务处理
默认情况下,当EF调用SaveChanges()时,会把生成的所有SQL命令“包”到一个“事务(transaction)”中,只要有一个数据更新操作失败,整个事务将回滚. 在多数情况下,如果你总在数据 ...
- Java事务处理
Java事务处理总结 一.什么是Java事务 通常的观念认为,事务仅与数据库相关. 事务必须服从ISO/IEC所制定的ACID原则.ACID是原子性(atomicity).一致性(co ...
- PHP与MYSQL事务处理
/*MYSQL的事务处理主要有两种方法.1.用begin,rollback,commit来实现begin 开始一个事务rollback 事务回滚commit 事务确认2.直接用set来改变mysql的 ...
- 已经过事务处理的 MSMQ 绑定(转载)
https://msdn.microsoft.com/zh-cn/biztalk/ms751493 本示例演示如何使用消息队列 (MSMQ) 执行已经过事务处理的排队通信. 注意 本主题的末尾介绍了此 ...
- SQLite剖析之事务处理技术
前言 事务处理是DBMS中最关键的技术,对SQLite也一样,它涉及到并发控制,以及故障恢复等等.在数据库中使用事务可以保证数据的统一和完整性,同时也可以提高效率.假设需要在一张表内一次插入20个人的 ...
随机推荐
- 拼图 canvas分割 dom拖拽 pc 移动端
参考:Canvas drag 实现拖拽拼图小游戏 参考的案例,不支持手机端.总结下实现过程中遇到的小坑. gitHub:https://github.com/WppFrontEnd/puzzle 大概 ...
- spring filter拦截器
实现的功能:判断用户是否已登录,未登录用户禁止访问任何页面或action,自动跳转到登录页面.比较好的做法是不管什么人都不能直接访问jsp页面,要访问就通过action,这样就变成了一个实实在在的权限 ...
- 一个简单算法题引发的思考<DNA sorting>(about cin/template/new etc)
首先是昨天在北京大学oj网上看到一个简单的算法题目,虽然简单,但是如何完成一段高效.简洁.让人容易看懂的代码对于我这个基础不好,刚刚进入计算机行业的小白来说还是有意义的.而且在写代码的过程中,会发现自 ...
- Codeforces 731C. Socks 联通块
C. Socks time limit per test: 2 seconds memory limit per test: 256 megabytes input: standard input o ...
- python课程第一周重点记录
- div的一些易出错地方
1.div中放一张图片老是显示不出来? 解决方法如下: 设置一下div的宽度与高度,然而此时直接写width与height是不对的,对于块级元素没有这个属性,只能在style="width: ...
- display转块状化
display:block block元素会独占一行,多个block元素会各自新起一行.默认情况下,block元素宽度自动填满其父元素宽度. block元素 ...
- 20145318 GDB调试汇编堆栈分析
20145318 GDB调试汇编堆栈分析 代码 #include<stdio.h> short addend1 = 1; static int addend2 = 2; const sta ...
- hashcode深入理解
带着问题去理解: 1. Object类HashCode方法是如何实现的,和String类有什么区别? 2.HashCode和Equals之间的关系? 一.hashCode作用 hashCode方法返回 ...
- 如何解决pycharm输入中文报错问题
在pycharm中的python文件中输入中文会报错SyntaxError: 问题解决方法在文件开头添加 : # -*- coding:utf-8 -*- 每次添加都很麻烦,一劳永逸解决此问题的方法: ...