
笔记 Bioinformatics Algorithms Chapter1
Chapter1 WHERE IN THE GENOME DOES DNA REPLICATION BEGIN

一、
·聚合酶启动结构域会结合上游序列的一些位点,这些位点有多个,且特异,并且分布在两条链上。通过计算,找到出现频率最高的k-mer可能为为聚合酶结合位点:dnaA BOX。
但是如何定位Ori的大概位置呢?
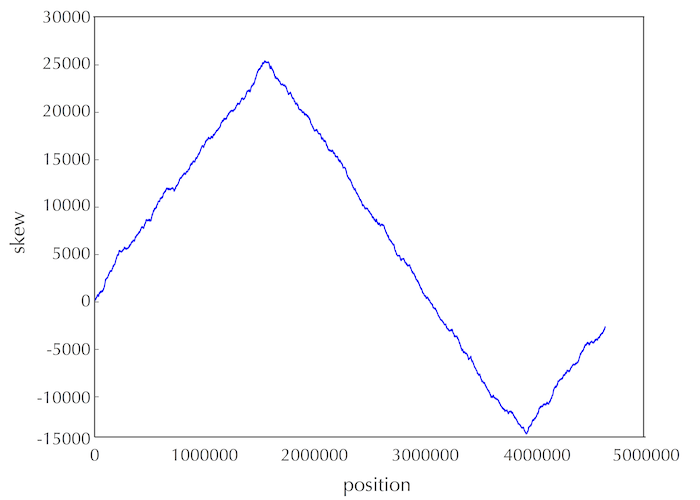
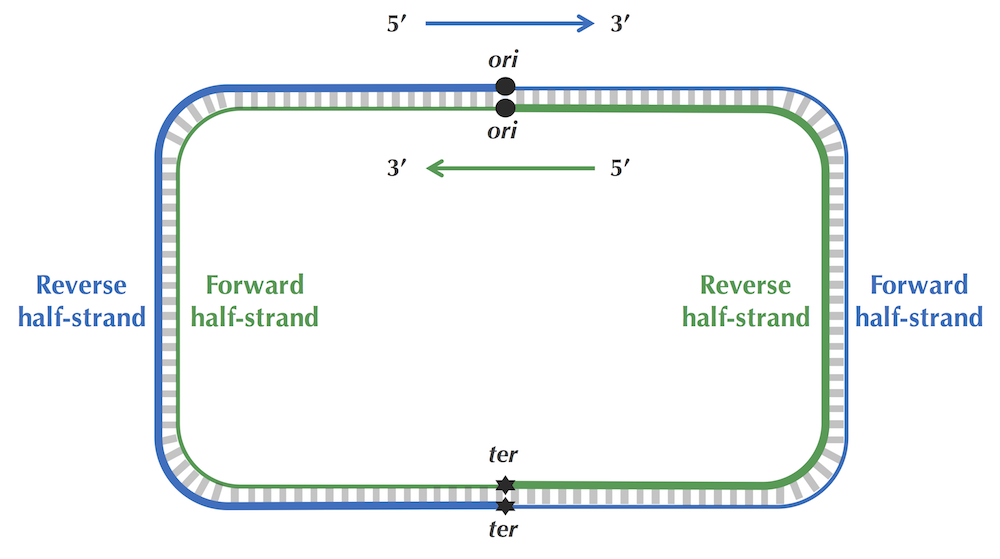
·DNA链复制的不对称性,其导致突变速率的不对称,使得有(forward链C->T,脱氨基)的趋势。由此,依据skew增的处于forward链,skew减的处于reverse链。(skew = G - C ,逢G+1 逢C-1)图中最低点代表Ori区域。
由此可以大致推测出ori的位置,然后在此位置内(100bp),寻找出现频率大的pattern,作为可能的dnaA box。
·由于k-mer之间,会有碱基的若干差异,故应使用能容错的计数方法。
二、
提出问题:The Clump Finding Problem
Find every k-mer that forms a clump in the genome.
ComputingFrequencies(Text, k) #一种遍历一次计算频率的‘桶’方法

        for i ← 0 to 4k − 1

            FrequencyArray(i) ← 0

        for i ← 0 to |Text| − k

            Pattern ← Text(i, k)

            j ← PatternToNumber(Pattern) #hash

            FrequencyArray(j) ← FrequencyArray(j) + 1

        return FrequencyArray
ComputingFrequencies(Text, k)这是一种计算kmer频率的方法
FindingFrequentWordsBySorting(Text , k) #排序法

        FrequentPatterns ← an empty set

        for i ← 0 to |Text| − k

            Pattern ← Text(i, k)

            Index(i) ← PatternToNumber(Pattern)

            Count(i) ← 1

        SortedIndex ← Sort(Index)

        for i ← 1 to |Text| − k

            if SortedIndex(i) = SortedIndex(i − 1)

                Count(i) = Count(i − 1) + 1

        maxCount ← maximum value in the array Count

        for i ← 0 to |Text| − k

            if Count(i) = maxCount

                Pattern ← NumberToPattern(SortedIndex(i), k)

                add Pattern to the set FrequentPatterns

        return FrequentPatterns
FindingFrequentWordsBySorting(Text , k)这是另一种计算kmer频率的方法
ClumpFinding(Genome, k, L, t)

        FrequentPatterns ← an empty set

        for i ← 0 to 4k − 1

            Clump(i) ← 0

        for i ← 0 to |Genome| − L

            Text ← the string of length L starting at position i in Genome

            FrequencyArray ← ComputingFrequencies(Text, k)

            for index ← 0 to 4k − 1

                if FrequencyArray(index) ≥ t

                    Clump(index) ← 1

        for i ← 0 to 4k − 1

            if Clump(i) = 1

                Pattern ← NumberToPattern(i, k)

                add Pattern to the set FrequentPatterns

        return FrequentPatterns
我们不用每次挪动一位搜寻窗就重新计算kmer频率,搜寻窗每挪一位,原来的第一个kmer将少一个,结尾后一个kmer将多一个
BetterClumpFinding(Genome, k, t, L)

        FrequentPatterns ← an empty set

        for i ← 0 to 4k − 1

            Clump(i) ← 0

        Text ← Genome(0, L)

        FrequencyArray ← ComputingFrequencies(Text, k)

        for i ← 0 to 4k − 1

            if FrequencyArray(i) ≥ t

                Clump(i) ← 1

        for i ← 1 to |Genome| − L

            FirstPattern ← Genome(i − 1, k)

            index ← PatternToNumber(FirstPattern)

            FrequencyArray(index) ← FrequencyArray(index) − 1

            LastPattern ← Genome(i + L − k, k)

            index ← PatternToNumber(LastPattern)

            FrequencyArray(index) ← FrequencyArray(index) + 1

            if FrequencyArray(index) ≥ t

                Clump(index) ← 1

        for i ← 0 to 4k − 1

            if Clump(i) = 1

                Pattern ← NumberToPattern(i, k)

                add Pattern to the set FrequentPatterns

        return FrequentPatterns
笔记 Bioinformatics Algorithms Chapter1的更多相关文章
- 读书笔记 Bioinformatics Algorithms Chapter5
Chapter5 HOW DO WE COMPARE DNA SEQUENCES Bioinformatics Algorithms-An_Active Learning Approach htt ...
- 笔记 Bioinformatics Algorithms Chapter7
一.Lloyd算法 算法1 Lloyd Algorithm k_mean clustering * Centers to Clusters: After centers have been selec ...
- 笔记 Bioinformatics Algorithms Chapter2
Chapter2 WHICH DNA PATTERNS PLAY THE ROLE OF MOLECULAR CLOCKS 寻找模序 一. 转录因子会结合基因上游的特定序列,调控基因的转录表达,但是在 ...
- How do I learn machine learning?
https://www.quora.com/How-do-I-learn-machine-learning-1?redirected_qid=6578644 How Can I Learn X? ...
- Protocol Informatics (PI项目)【基于网络轨迹的协议逆向工程文献学习】
Protocol Informatics[基于网络轨迹的协议逆向工程文献学习]by tsy 声明: 1)本报告由博客园bitpeach撰写,版权所有,免费转载,请注明出处,并请勿作商业用途.恕作者著作 ...
- 《Algorithms算法》笔记:元素排序(4)——凸包问题
<Algorithms算法>笔记:元素排序(4)——凸包问题 Algorithms算法笔记元素排序4凸包问题 凸包问题 凸包问题的应用 凸包的几何性质 Graham 扫描算法 代码 凸包问 ...
- 《Algorithms算法》笔记:元素排序(3)——洗牌算法
<Algorithms算法>笔记:元素排序(3)——洗牌算法 Algorithms算法笔记元素排序3洗牌算法 洗牌算法 排序洗牌 Knuth洗牌 Knuth洗牌代码 洗牌算法 洗牌的思想很 ...
- 《深入PHP与jQuery开发》读书笔记——Chapter1
由于去实习过后,发现真正的后台也要懂前端啊,感觉javascript不懂,但是之前用过jQuery感觉不错,很方便,省去了一些内部函数的实现. 看了这一本<深入PHP与jQuery开发>, ...
- 《Algorithms 4th Edition》读书笔记——3.1 符号表(Elementary Symbol Tables)-Ⅳ
3.1.4 无序链表中的顺序查找 符号表中使用的数据结构的一个简单选择是链表,每个结点存储一个键值对,如以下代码所示.get()的实现即为遍历链表,用equals()方法比较需被查找的键和每个节点中的 ...
随机推荐
- tomcat/eclipse提速[z]
在使用Eclipse开发项目过程中,一度使Eclipse陷入瘫痪状态,Tomcat启动项目时也异常缓慢,增加了超时限制并没有用,有时候项目根本运行不起来,简直让人崩溃,可能我电脑内存小(4G),配置低 ...
- 9.12 h5日记
9.12 知识点补充: 属性继承例子,color.font(font-size/style/family/weight) 1.浏览器的默认字体大小是16px,谷歌浏览器的最小字体是10px,其他浏览器 ...
- u-boot之ARM920T的start.S分析
cpu/arm920t/start.S程序步骤大致有以下几个 1.设置中断向量表 2.设置CPU模式为SVC32 mode并且关闭IRQ与FIQ中断 3.关闭看门狗 4.屏蔽所有中断 5.判断程序是否 ...
- 从django的序列化到rest-framework 序列化
1.利用Django的view实现返回json数据 from django.views.generic import View from goods.models import Goods class ...
- (轉)JSON.stringify 语法实例讲解
作用:这个函数的作用主要是为了系列化对象的. 可能有些人对系列化这个词过敏,我的理解很简单.就是说把原来是对象的类型转换成字符串类型(或者更确切的说是json类型的).就这么简单.打个比方说,你有一个 ...
- andorid 对话框
activity_ui2.xml <?xml version="1.0" encoding="utf-8"?> <LinearLayout x ...
- Pandas基本介绍
1.pandas主要的两个数据结构:Series和DataFrame Series的字符串表现形式为:索引在左边,值在右边.由于我们没有为数据指定索引.于是会自动创建一个0到N-1(N为长度)的整数型 ...
- iOS.Objective-C.Dependency.Graphing-v0.1
当Project越来越复杂,模块间的依赖就会很复杂,不合理的依赖就出现:不必要的依赖,双向依赖等等. 在iOS Application Project中可以将依赖定义为:对某个头文件的import. ...
- iOS最全的常用正则表达式大全
很多不太懂正则的朋友,在遇到需要用正则校验数据时,往往是在网上去找很久,结果找来的还是不很符合要求.所以我最近把开发中常用的一些正则表达式整理了一下,包括校验数字.字符.一些特殊的需求等等.给自己留个 ...
- UOJ 67 新年的毒瘤 - Tarjan
Description 给出一个无向图, 要求找出某个点$u$, 去掉$u$和$u$所连的边, 所剩下的节点构成一棵树. Solution 首先, 割点肯定是不可能满足条件的, 因为去掉割点后会构成若 ...