
三张关联表,大表;单次查询耗时400s,有group by order by 如何优化
问题SQL:
select
p.person_id as personId,
p.person_name as personName,
p.native_place as nativePlace,
ci.company_name as companyName,
pp.seal_number as sealNumber,
GROUP_CONCAT(pp.major) as major,
pp.register_name as registerName
from qyt_person p
left join qyt_person_practising pp on p.person_id=pp.person_id
left join qyt_company_info ci on p.company_id=ci.company_id
group by p.person_id,pp.register_name
order by p.create_time desc
limit 1,10
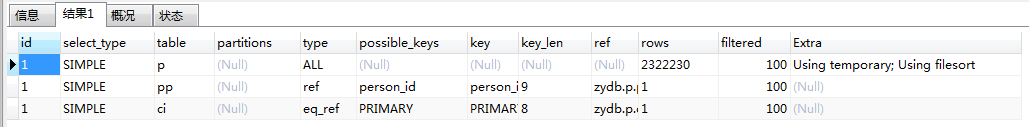
SQL总耗时393秒,通过Explain分析,发现为200万数据的表建立了临时表,且做了一次排序操作
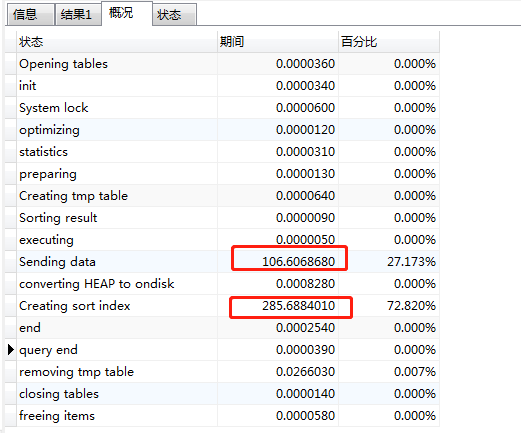
通过查看SQL运行分析,也看出来,构造临时表耗时106秒,排序用了285秒(没索引的排序慢)
解决思路:根据业务需求再次审视如何减少数据量
1、业务需求:最新人员可以先取出来10名
2、取出来后再关联查询他们所在企业,所获证书(有索引,查询快)
3、这种小的临时表排序的耗时就可以接受了
4、SQL语句有子查询功能,可以把200万的表数据缩减为10人的小表
SQL语句如下:
select
p.person_id as personId,
p.person_name as personName,
p.native_place as nativePlace,
p.create_time as createTime,
ci.company_name as companyName,
pp.seal_number as sealNumber,
GROUP_CONCAT(pp.major) as major,
pp.register_name as registerName
from (SELECT person_id, person_name, native_place,company_id ,create_time from qyt_person order by create_time desc limit 0,10) p
left join qyt_person_practising pp on p.person_id=pp.person_id
left join qyt_company_info ci on p.company_id=ci.company_id
group by p.person_id,pp.register_name
ORDER BY p.create_time desc
limit 0,10
结果完美!响应时间为0.017秒
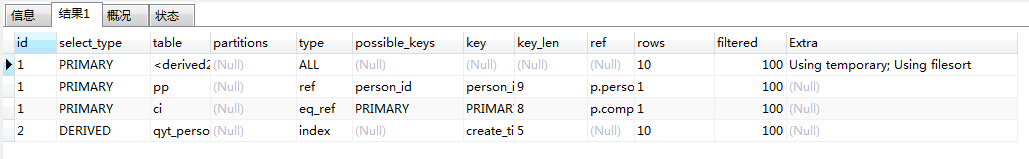
通过Explain分析,临时表就10条记录,所以处理耗时非常少
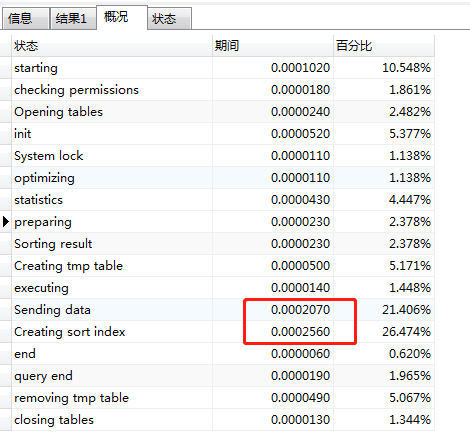
大块的时间还是损耗在构造临时表和排序上,但是这个时间必须得损失
三张关联表,大表;单次查询耗时400s,有group by order by 如何优化的更多相关文章
- mysql结构相同的三张表查询一条记录\将一张表中的数据插入另外一张表
将一张表中的数据插入另外一张表 1.两张表结构相同 insert into 表1名称 select * from 表2名称 2.两张结构不相同的表 insert into 表1名称(列名1,列名2,列 ...
- 如何优化MySQL千万级大表
很好的一篇博客,转载 如何优化MySQL千万级大表 原文链接::https://blog.csdn.net/yangjianrong1985/article/details/102675334 千万级 ...
- 走向DBA[MSSQL篇] 针对大表 设计高效的存储过程【原理篇】 附最差性能sql语句进化过程客串
原文:走向DBA[MSSQL篇] 针对大表 设计高效的存储过程[原理篇] 附最差性能sql语句进化过程客串 测试的结果在此处 本篇详解一下原理 设计背景 由于历史原因,线上库环境数据量及其庞大,很多千 ...
- switch...case...语句分析(大表跟小表何时产生)
一.switch...case...的格式 switch(表达式) { case 常量表达式1: 语句; break; case 常量表达式2: 语句; break; case 常量表达式3: 语句; ...
- Oracle中创建千万级大表归纳
从一月至今,我总共归纳了三种创建千万级大表的方案,它们是: 下面是这三种方案的对比表格: # 名称 地址 主要机制 速度 1 在Oracle中十分钟内创建一张千万级别的表 https://www.cn ...
- MySQL8.0大表秒加字段,是真的吗?
前言: 很早就听说 MySQL8.0 支持快速加列,可以实现大表秒级加字段.笔者自己本地也有8.0环境,但一直未进行测试.本篇文章我们就一起来看下 MySQL8.0 快速加列到底要如何操作. 1.了解 ...
- mysql分表和表分区详解
为什么要分表和分区? 日常开发中我们经常会遇到大表的情况,所谓的大表是指存储了百万级乃至千万级条记录的表.这样的表过于庞大,导致数据库在查询和插入的时候耗时太长,性能低下,如果涉及联合查询的情况,性能 ...
- 【mysql】mysql分表和表分区详解
为什么要分表和分区? 日常开发中我们经常会遇到大表的情况,所谓的大表是指存储了百万级乃至千万级条记录的表.这样的表过于庞大,导致数据库在查询和插入的时候耗时太长,性能低下,如果涉及联合查询的情况,性能 ...
- Django:常用字段、手动自动第三张表单、元信息
一.常用字段和非常用字段 二.手动,自动创建第三张表 三.元信息 四.defer和only 一.常用字段和非常用字段 -常用字段 AutoField int自增列,必须填入参数 primary_key ...
随机推荐
- RF页面断言
title should be(断言title与预期指定的title内容相等): should be equal (断言某个字符串与预期指定的字符串相等) should not be equal ( ...
- Centos7升级Git版本
centos 升级 Git 版本 问题描述 centos7 系统默认的 git 安装版本是 1.8,但是在项目构建中发现 git 版本过低,于是用源码编译的方式进行升级.同时该文章也适用于安装新的 g ...
- 实验吧之【因缺思汀的绕过】(group by with rollup的注入利用)
打开页面,查看源代码,发现存在source.txt(http://ctf5.shiyanbar.com/web/pcat/source.txt),如下: <?php error_reportin ...
- 元素定位之css选择器(2)
理论学习地址:https://www.runoob.com/cssref/css-selectors.html 定位思路: 先在单元素范围内选择查找id或name,定位不到的话往上查扩大范围 使用实例 ...
- [Tarjan系列] Tarjan算法与有向图的SCC
前面的文章介绍了如何用Tarjan算法计算无向图中的e-DCC和v-DCC以及如何缩点. 本篇文章资料参考:李煜东<算法竞赛进阶指南> 这一篇我们讲如何用Tarjan算法求有向图的SCC( ...
- C# leetcode 之 096 不同的二叉搜索树
C# leetcode 之 096 不同的二叉搜索树 题目描述 给定一个整数 n,求以 1 ... n 为节点组成的二叉搜索树有多少种? 二叉搜索树定义 左子树上所有节点的值小于根节点, 右子树上左右 ...
- 我是如何在一周内拿到4份offer的?
前言 大概一个月没写博客了吧,这段时间事情比较多(家里有事,请了一段时间假,正好利用剩余几天时间面了几次试),也没抽出来时间写博客,还好所有的事情已经处理完了,今天闲来无事就整理一下这几次面试过程中遇 ...
- Jquery动态bind绑定已有函数,函数自动执行的问题解决方法
在bind后面的方法,不能带括号,带括号函数就自动执行了... <script> //通过子元素删除某行 function deleteRow() { var flag = confirm ...
- Vue中Form表单验证无法消除验证问题
iView的表单api给出了一个resetFields方法,用于重置整个表单输入的内容并清除验证提示. 但是有时候需要只消除部分的iview的resetFields方法源码是这样的resetField ...
- 【GIT】下载最新库命令
使用技巧:使用这个命令 git clone git仓库地址 --depth=1 这样只下载最新版本仓库,而不是所有历史版本的仓库