
sql基础语法复习(二)-- 分组,连接的使用
一、深入学习 group by
group by ,分组,顾名思义,把数据按什么来分组,每一组都有什么特点。
1、我们先从最简单的开始:
select count(*) from tb1 group by tb1.sex;
查询所有数据的条数,按性别来分组。这样查询到的结果集只有一列count(*)。
2、然后我们来分析一下,这个分组,我们能在select 和 from 之间放一些什么呢?
当数据分组之后,数据的大部分字段都将失去它存在的意义,大家想想,多条数据的同一列,只显示一个值,那到底显示谁的,这个值有用吗?
通过思考,不难发现,只有by的那些列可以放进去,然后就是sql的函数操作了,比如count(),sum()……(包含在by后面作为分组的依据,包含在聚合函数中作为结果)
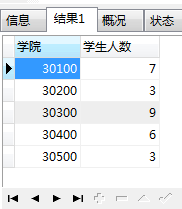
例:查询每个学院的学生有多少人:(学院的值是学院的id)
SELECT a.COLLEGE AS 学院,COUNT(*) AS 学生人数 FROM base_alumni a GROUP BY a.COLLEGE;
3、where,having,和group by联合使用
在最初学习group by的时候,我就陷入了一个误区,那就是group by不能和where一起使用,只能用having……
看书不认真啊,其实它们都是可以一起使用的,只不过是where只能在group by 的前面,having只能在group by 的后面。
where,过滤条件的关键字,但是它只能对group by之前的数据进行过滤筛选;
having,也是过滤条件的关键字作用和where是一样的,但是它过滤的是分组后的数据,就是对分组后得到的结果集进行过滤筛选。
出现having其实我觉得就是为了解决一条语句出现两个where的问题,把它们区分开来
例:
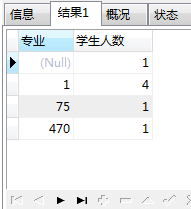
查询 30100学院的每个专业的学生有多少人。
SELECT a.MAJOR AS 专业, COUNT(*) AS 学生人数 FROM base_alumni a WHERE a.COLLEGE = 30100 GROUP BY a.MAJOR;
查询每个学院的学生有多少人,并且只要学生人数大于3的。
SELECT a.COLLEGE AS 学院,COUNT(*) AS 学生人数 FROM base_alumni a GROUP BY a.COLLEGE HAVING COUNT(*)>3;
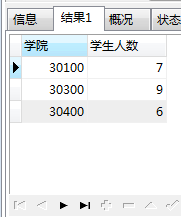
滤清执行顺序:①先对*进行筛选,②对筛选的结果进行分组,③对分组的结果进行筛选
4、Group By All 的使用,哈哈哈哈,经常网上的查阅,我决定淘汰这个语法~
其实就是前面where之后,想要分组的结果显示不符合where的数据,当然,不做运算,运算结果用0或null表示,感觉这语法没啥用,想不出应用场景~
二、深入学习 连接
连接分4种,内连接,全连接,左外连接,右外连接
https://www.cnblogs.com/afirefly/archive/2010/10/08/1845906.html
1、连接出现的地方
①from和where之间,做表和表的连接
②where和having之间,having是对group by的结果集进行筛选,就是把group by的结果集作为一张表,然后可以再和别的表做连接,再进一步筛选
2、连接类型解读
把表看成是一个集合,连接看成是映射,那么它们的结果
内连接:一一映射;全连接:笛卡尔乘积;左外连接:一一映射+左表对应右表的null;右外连接:一一映射+右表对应左表的null。
关键字:
内连接:inner join;全连接:cross join;左外连接:left join;右外连接:right join 。
语法:
表a left join 表b on a.列1 = b.列2
3、连接的使用
之前学习group by的例子中,结果集是存在bug的。
例:查询每个学院的学生有多少人:(学院的值是学院的id),在没有连接的时候,学院人数为0的是显示不出来的,因为当前表中就没有这个学院的信息
那么我们在这里做一下左连接(左外连接):
SELECT c.ID, a.COLLEGE, COUNT(a.COLLEGE) FROM (SELECT ID FROM dic_college) c LEFT JOIN ( SELECT COLLEGE FROM base_alumni ) a ON c.ID = a.COLLEGE GROUP BY c.ID
我这里是一个完整的语句了。我在写出这条语句之前遇到了许多的磕磕碰碰。
解读它:
我们先把学院表和校友信息表(学生表)做左连接
因为我们要的是学院,所以学院作为主表,放left join的前面 c LEFT JOIN a ON ...
然后我们发现有很多字段,于是我们去掉多余的字段,这样既方便我们观察,也提高了sql的执行效率
①把学院表变成只有一个字段(SELECT ID FROM dic_college) c
②把学生表变成只有一个字段( SELECT COLLEGE FROM base_alumni ) a
这时,查询结果是这样的
SELECT * FROM (SELECT ID FROM dic_college) c LEFT JOIN ( SELECT COLLEGE FROM base_alumni ) a ON c.ID = a.COLLEGE
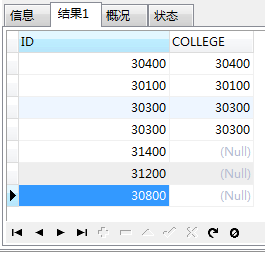
这时候,对这个结果集进行分组:GROUP BY c.ID,并且查询字段要做更改
在上边那个结果集中,c.ID和a.COLLEGE是一一对应的,此时,count(*)的数据是总行数,因为我们的主表是学院表,所以这个数据和count(c.ID)的数据是一样的。
但是a.COLLEGE为空的行的数据中值都是1,这不是我们想要的,所以我们把count(*)改成count(a.COLLEGE),这样数据就出来了。
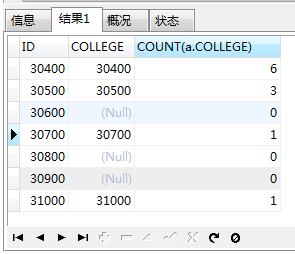
这才是查询所有学院中每个学院的学生人数的正确答案!当然,上边的截图只是数据的前几行,后面还有数据的
4、经过我测试了一下……
左连接和右连接……
SELECT * FROM a LEFT JOIN b ON b.ID = a.FK_ID;
SELECT * FROM b RIGHT JOIN a ON b.ID = a.FK_ID;
这两个语句的结果相同,它两并没有发现别的区别。
全连接就是交叉连接,和不使用连接……
SELECT * FROM c,a WHERE c.ID = a.FK_ID;
SELECT * FROM c CROSS JOIN a ON c.ID = a.FK_ID;
这两个语句也没有区别。
sql基础语法复习(二)-- 分组,连接的使用的更多相关文章
- SQL基础语法(二)
SQL SELECT 语句 本章讲解 SELECT 和 SELECT * 语句. SQL SELECT 语句 SELECT 语句用于从表中选取数据. 结果被存储在一个结果表中(称为结果集). SQL ...
- sql基础语法复习
约定:数据库名:test:表名:tb1,tb2,tb3…: 对象:数据库:database 表:table 列:column 索引:index 视图:view 存储过程:procedure 一.数据结 ...
- sql 基础语法3:分组,聚合函数,having,联合查询,快速备份,内联函数
select * from Classinfo select * from StuInfo select * from CourseInfo select * from ScoreInfo --分组 ...
- ASP.NET实现二维码 ASP.Net上传文件 SQL基础语法 C# 动态创建数据库三(MySQL) Net Core 实现谷歌翻译ApI 免费版 C#发布和调试WebService ajax调用WebService实现数据库操作 C# 实体类转json数据过滤掉字段为null的字段
ASP.NET实现二维码 using System;using System.Collections.Generic;using System.Drawing;using System.Linq;us ...
- SQL基础--查询之二--连接查询
SQL基础--查询之二--连接查询
- JS基础语法(二)
目录 JavaScript基础语法(二) 八. 函数 1. 函数的概念 2. 函数的使用 声明函数 调用函数 3. 函数的封装 4. 函数的参数 函数的参数匹配问题 5. 函数返回值 6. argum ...
- Golang 基础之基础语法梳理 (二)
大家好,今天将梳理出的 Go语言基础语法内容,分享给大家. 请多多指教,谢谢. 本次<Go语言基础语法内容>共分为三个章节,本文为第二章节 Golang 基础之基础语法梳理 (一) Gol ...
- java基础语法(二)--单列模式
java基础语法(二)--单列模式 /** * 功能:单列模式 * @author Administrator * */ public class SingletonTest { public sta ...
- SQL基础语法笔记教程整理
PS:本文适用SQL Server2008语法. 一.关系型数据库和SQL 实际上准确的讲,SQL是一门语言,而不是一个数据库. 什么是SQL呢?简而言之,SQL就是维护和使用关系型数据库中的的数据的 ...
随机推荐
- Covariance and Contravariance (C#)
Covariance and Contravariance (C#) https://docs.microsoft.com/en-us/dotnet/articles/csharp/programmi ...
- SpringBoot项目结构介绍
一项目结构介绍 springboot框架本身对项目结构并没有特别的要求,但是按照最佳的项目结构可以帮助我们减少可能遇到的错误问题.结构如下: (1)应用主类SpringbootApplication应 ...
- emmet常用指令组合
emmet的应用 1.生成html(需要先将文件命名为.html后缀) !+tab,html:5+tab 2.生成meta utf meta:utf+tab 3.生成meta viewpo ...
- python之Memcached 安装及操作
一.Memcached Memcached 是一个高性能的分布式内存对象缓存系统,用于动态Web应用以减轻数据库负载.它通过在内存中缓存数据和对象来减少读取数据库的次数,从而提高动态.数据库驱动网站的 ...
- 【三小时学会Kubernetes!(三) 】Service实践
服务Service Kubernetes 服务资源可以作为一组提供相同服务的 Pod 的入口.这个资源肩负发现服务和平衡 Pod 之间负荷的重任,如图 16 所示. 图16:Kubernetes 服务 ...
- 【程序员笔试面试必会——排序②】Python实现 计数排序、基数排序
一.计数排序 概要: 时间复杂度O(n),空间复杂度O(k),k是输入序列的值的范围(最大值-最小值),是稳定的.计数排序一般用于已知输入值的范围相对较小,比如给公司员工的身高体重信息排序. 思路: ...
- MySQL之长连接、短连接、连接池
当数据库服务器和客户端位于不同的主机时,就需要建立网络连接来进行通信.客户端必须使用数据库连接来发送命令和接收应答.数据.通过提供给客户端数据库的驱动指定连接字符串后,客户端就可以和数据库建立连接了. ...
- maven 引入jar包
问题描述:自己的项目需要引入jar包,已知jar包名字,怎么在maven中添加依赖,使其能自动导入? 第一次使用:本文作为记录! 首先,找到maven仓库的网址!如下: http://mvnrepos ...
- Codeforces Round #424
基本全是水题 第一题水,不过有hack点,先增后不变再减 #include<map> #include<set> #include<cmath> #include& ...
- constructor&object 的联系与对比
构造函数与对象 构造函数是类中的特殊成员函数,用于为对象分配内存.它可用于为数据成员提供值.创建对象时将调用构造函数.它与类具有相同的名称.构造函数不返回任何值. 构造函数是生成对象的模板,一个构造函 ...