
hive join的三种优化方式
原网址:https://blog.csdn.net/liyaohhh/article/details/50697519
hive在实际的应用过程中,大部份分情况都会涉及到不同的表格的连接,
例如在进行两个table的join的时候,利用MR的思想会消耗大量的内存,磁盘的IO,大幅度的影响性能,因为shuffle真的好令人担心啊,总之,就是各种问题都是由他产生的。
下面介绍一下涉及hive在join的时候的优化方式。
第一:在map端产生join
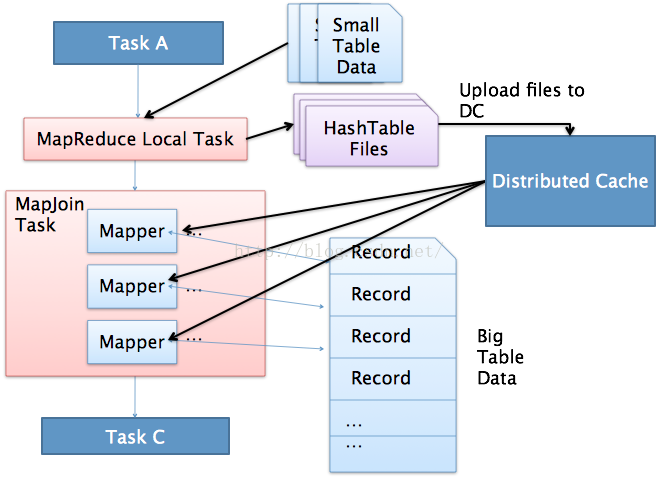
mapJoin的主要意思就是,当链接的两个表是一个比较小的表和一个特别大的表的时候,我们把比较小的table直接放到内存中去,然后再对比较大的表格进行map操作。
join就发生在map操作的时候,每当扫描一个大的table中的数据,就要去去查看小表的数据,哪条与之相符,继而进行连接。
这里的join并不会涉及reduce操作。map端join的优势就是在于没有shuffle,真好。在实际的应用中,我们这样设置:
set hive.auto.convert.join=true;
这样设置,hive就会自动的识别比较小的表,继而用mapJoin来实现两个表的联合。
看看下面的两个表格的连接。这里的dept相对来讲是比较小的。我们看看会发生什么,如图所示:
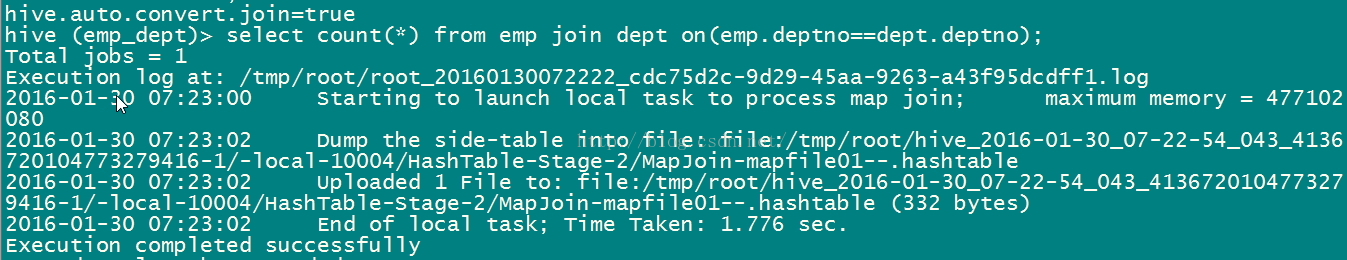
注意看啦,这里的第一句话就是运行本地的map join任务,继而转存文件到XXX.hashtable下面,在给这个文件里面上传一个文件进行map join,之后才运行了MR代码去运行计数任务。
说白了,在本质上map join根本就没有运行MR进程,仅仅是在内存就进行了两个表的联合。具体运行如下图:
第二:common join
common join也叫做shuffle join,reduce join操作。这种情况下生再两个table的大小相当,但是又不是很大的情况下使用的。
具体流程就是在map端进行数据的切分,一个block对应一个map操作,然后进行shuffle操作,把对应的block shuffle到reduce端去,再逐个进行联合,
这里优势会涉及到数据的倾斜,大幅度的影响性能有可能会运行speculation,
这块儿在后续的数据倾斜会讲到。因为平常我们用到的数据量小,所以这里就不具体演示了。
第三:SMBJoin
smb是sort merge bucket操作,首先进行排序,继而合并,然后放到所对应的bucket中去,bucket是hive中和分区表类似的技术,就是按照key进行hash,相同的hash值都放到相同的buck中去。在进行两个表联合的时候。我们首先进行分桶,在join会大幅度的对性能进行优化。也就是说,在进行联合的时候,是table1中的一小部分和table1中的一小部分进行联合,table联合都是等值连接,相同的key都放到了同一个bucket中去了,那么在联合的时候就会大幅度的减小无关项的扫描。
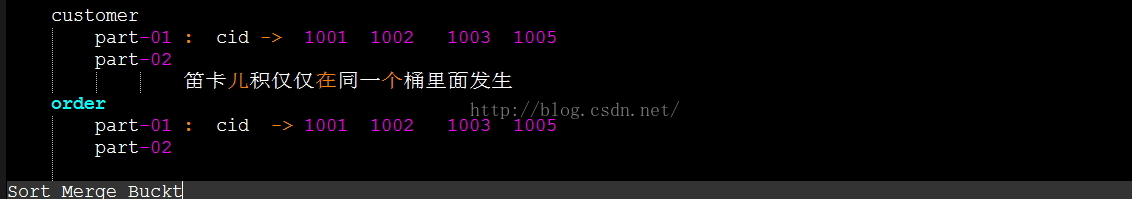
具体的看看一个例子:
set hive.auto.convert.sortmerge.join=true;
set hive.optimize.bucketmapjoin = true;
set hive.optimize.bucketmapjoin.sortedmerge = true;
set hive.auto.convert.sortmerge.join.noconditionaltask=true;
create table emp_info_bucket(ename string,deptno int)
partitioned by (empno string)
clustered by(deptno) into 4 buckets;
insert overwrite table emp_info_bucket
partition (empno=7369)
select ename ,deptno from emp
create table dept_info_bucket(deptno string,dname string,loc string)
clustered by (deptno) into 4 buckets;
insert overwrite table dept_info_bucket
select * from dept;
select * from emp_info_bucket emp join dept_info_bucket dept
on(emp.deptno==dept.deptno);//正常的情况下,应该是启动smbjoin的但是这里的数据量太小啦,还是启动了mapjoin
hive join的三种优化方式的更多相关文章
- oracle Hash Join及三种连接方式
在Oracle中,确定连接操作类型是执行计划生成的重要方面.各种连接操作类型代表着不同的连接操作算法,不同的连接操作类型也适应于不同的数据量和数据分布情况. 无论是Nest Loop Join(嵌套循 ...
- hive命令的三种执行方式
hive命令的3种调用方式 方式1:hive –f /root/shell/hive-script.sql(适合多语句) hive-script.sql类似于script一样,直接写查询命令就行 不 ...
- Spark SQL join的三种实现方式
引言 join是SQL中的常用操作,良好的表结构能够将数据分散到不同的表中,使其符合某种规范(mysql三大范式),可以最大程度的减少数据冗余,更新容错等,而建立表和表之间关系的最佳方式就是join操 ...
- 061 hive中的三种join与数据倾斜
一:hive中的三种join 1.map join 应用场景:小表join大表 一:设置mapjoin的方式: )如果有一张表是小表,小表将自动执行map join. 默认是true. <pro ...
- Hive metastore三种配置方式
http://blog.csdn.net/reesun/article/details/8556078 Hive的meta数据支持以下三种存储方式,其中两种属于本地存储,一种为远端存储.远端存储比较适 ...
- Hive总结(八)Hive数据导出三种方式
今天我们再谈谈Hive中的三种不同的数据导出方式. 依据导出的地方不一样,将这些方式分为三种: (1).导出到本地文件系统. (2).导出到HDFS中: (3).导出到Hive的还有一个表中. 为了避 ...
- Hive中的三种不同的数据导出方式介绍
问题导读:1.导出本地文件系统和hdfs文件系统区别是什么?2.带有local命令是指导出本地还是hdfs文件系统?3.hive中,使用的insert与传统数据库insert的区别是什么?4.导出数据 ...
- hive 数据导出三种方式
今天我们再谈谈Hive中的三种不同的数据导出方式.根据导出的地方不一样,将这些方式分为三种:(1).导出到本地文件系统:(2).导出到HDFS中:(3).导出到Hive的另一个表中.为了避免单纯的文字 ...
- Sort merge join、Nested loops、Hash join(三种连接类型)
目前为止,典型的连接类型有3种: Sort merge join(SMJ排序-合并连接):首先生产driving table需要的数据,然后对这些数据按照连接操作关联列进行排序:然后生产probed ...
随机推荐
- 为什么要用Android Studio?
为什么要用Android Studio 本书节选自<Android Studio实用指南> 作者: 毕小朋 目前本书已上传到百度阅读,在百度中搜索[Anroid Studio实用指南]便可 ...
- fastdfs 清晰简介 有用
是什么? FastDFS是一个轻量级分布式文件系统. 能干嘛? 对文件进行管理,功能包括:文件存储.文件同步.文件访问(文件上传.文件下载)等. 在Linux上的安装连 ...
- Python爬虫实战七之计算大学本学期绩点
大家好,本次为大家带来的项目是计算大学本学期绩点.首先说明的是,博主来自山东大学,有属于个人的学生成绩管理系统,需要学号密码才可以登录,不过可能广大读者没有这个学号密码,不能实际进行操作,所以最主要的 ...
- Mybatis:传入参数方式以及#{}与${}的区别
一.在MyBatis的select.insert.update.delete这些元素中都提到了parameterType这个属性.MyBatis现在可以使用的parameterType有基本数据类型和 ...
- 实践作业4:Web测试----细化分工DAY1.
会议时间:2017年12月23日 会议地点:东九教学楼教师休息室 主持人:吴辉 参会人员:吴辉.刘思佳.郜昌磊.王俊杰.吴慧杰 记录人:刘思佳 会议议题:本次作业的分工以及初期安排 工具选择 软件测试 ...
- Qcreator3.1.2调试器(windows)版本
环境:visual studio 2012 qt:5.3.1 默认的ms版本qtcreator只能使用visual studio的编译器,不能使用调试工具.需要gdb或者cdb进行调试,这里介绍使用的 ...
- (转)TinyHttp源码剖析
tinyhttpd 是一个不到 500 行的超轻量型 Http Server,用来学习非常不错,可以帮助我们真正理解服务器程序的本质. 看完所有源码,真的感觉有很大收获,无论是 unix 的编程,还是 ...
- idea 提示Resource registered by this uri is not recognized (Settings | Languages & Frameworks | Schemas and DTDs)
idea出现如上图所示的错误提示时,可以用如下方式解决 点击红色代码部分,鼠标悬停后出现红色灯泡,如下图所示 点击灯泡后,选择第一个选项就可以解决了
- 代码审查清单 Code Review
代码审查清单 常规项 代码能够工作么?它有没有实现预期的功能,逻辑是否正确等. 所有的代码是否简单易懂? 代码符合你所遵循的编程规范么?这通常包括大括号的位置,变量名和函数名,行的长度,缩进,格式和注 ...
- Tango Java API常数
Tango Java API Constants常数 Constant Field Values常数字段值 Contents com.google.* com.google.* com.google. ...