
RDD缓存学习
首先实现rdd缓存
准备了500M的数据 10份,每份 100万条,存在hdfs 中通过sc.textFile方法读取
val rdd1 = sc.textFile("hdfs://mini1:9000/spark/input/visitlog").cache
在启动spark集群模式时分配内存2g,第一次分配1g 只缓存了40% 当数据需要的内存大于实际的内存时spark会尽力的缓存
然后调用cache方法
rdd1.count
第二次调用rdd的count方法就显示出差距了
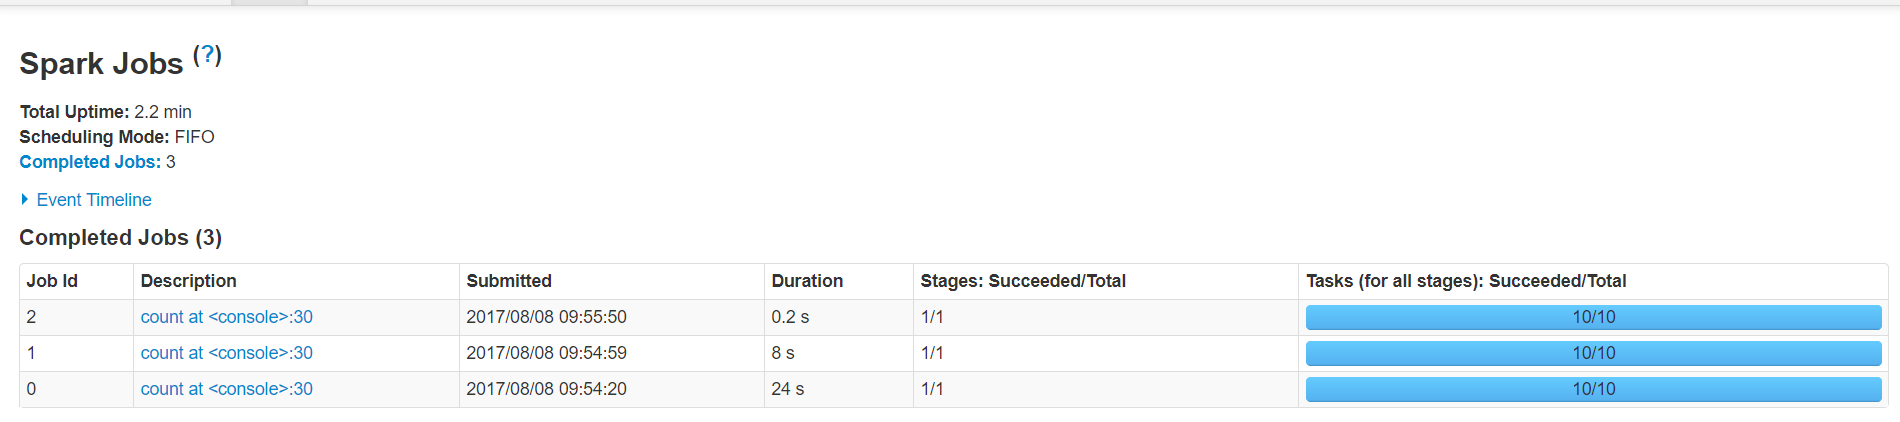
默认缓存策略是memory_only
  /** Persist this RDD with the default storage level (`MEMORY_ONLY`). */

  def persist(): this.type = persist(StorageLevel.MEMORY_ONLY)
其他的缓存策略
object StorageLevel {

//不缓存

  val NONE = new StorageLevel(false, false, false, false)

  //只往磁盘中缓存

  val DISK_ONLY = new StorageLevel(true, false, false, false)

  //磁盘中缓存两份

  val DISK_ONLY_2 = new StorageLevel(true, false, false, false, )

  //放在内存中

  val MEMORY_ONLY = new StorageLevel(false, true, false, true)

  //内存中保存两份,多个机器报存

  val MEMORY_ONLY_2 = new StorageLevel(false, true, false, true, )

  //报存一份到内存,并且把数据序列化,序列化之后数据占用内存变小,

  //但是序列化时需要消耗时间,时间换空间

  val MEMORY_ONLY_SER = new StorageLevel(false, true, false, false)

  //

  val MEMORY_ONLY_SER_2 = new StorageLevel(false, true, false, false, )

  //内存和磁盘都保存

  val MEMORY_AND_DISK = new StorageLevel(true, true, false, true)

  val MEMORY_AND_DISK_2 = new StorageLevel(true, true, false, true, )

  val MEMORY_AND_DISK_SER = new StorageLevel(true, true, false, false)

  //内存和磁盘都保存 序列化两份

  val MEMORY_AND_DISK_SER_2 = new StorageLevel(true, true, false, false, )

  val OFF_HEAP = new StorageLevel(false, false, true, false)
RDD缓存学习的更多相关文章
- spring boot guava cache 缓存学习
http://blog.csdn.net/hy245120020/article/details/78065676 ****************************************** ...
- TimesTen 应用层数据库缓存学习:4. 仅仅读缓存
在运行本文样例前.首先先运行TimesTen 应用层数据库缓存学习:2. 环境准备中的操作. Read-only Cache Group的概念 仅仅读缓存组例如以下图: 仅仅读缓存组(Read-Onl ...
- RDD缓存
RDD的缓存 Spark速度非常快的原因之一,就是在不同操作中可以在内存中持久化或缓存数据集.当持久化某个RDD后,每一个节点都将把计算的分片结果保存在内存中,并在对此RDD或衍生出的RDD进行的其他 ...
- Spark RDD设计学习笔记
本文档是学习RDD经典论文<Resilient Distributed Datasets: A Fault-Tolerant Abstraction for In-Memory Cluster ...
- Android缓存学习入门
本文主要包括以下内容 利用LruCache实现内存缓存 利用DiskLruCache实现磁盘缓存 LruCache与DiskLruCache结合实例 利用了缓存机制的瀑布流实例 内存缓存的实现 pub ...
- memcache/redis 缓存学习笔记
0.redis和memcache的区别 a.redis可以存储除了string之外的对象,如list,hash等 b.服务器宕机以后,redis会把内存的数据持久化到磁盘上,而memcache则不会 ...
- RDD缓存策略
Spark支持将数据集放置在集群的缓存中,以便于数据重用. Spark缓存策略对应的类: class StorageLevel private( private var useDisk_ : Bool ...
- C# 缓存学习第一天
缓存应用目的:缓存主要是为了提高数据的读取速度.因为服务器和应用客户端之间存在着流量的瓶颈,所以读取大容量数据时,使用缓存来直接为客户端服务,可以减少客户端与服务器端的数据交互,从而大大提高程序的性能 ...
- CPU缓存学习及C6678缓存使用总结(知识归纳)
作者注: 1.本篇博客内容是本人在学习cpu缓存原理时进行的学习总结,参考了多处相关资源(书籍,视频,知乎回答等),参考出处标注在内容最后. 2.由于本篇内容的编辑工作在印象笔记完成,输出的PDF文件 ...
随机推荐
- mysql的安全性机制
MySQL中主要包括两种用户:root用户和普通用户,其中前者为超级管理员,拥有MySQL提供的一切权限:而普通用户则只能拥有创建用户时赋予它的权限. MySQL的安全性机制主要包括权限机制,用户机制 ...
- 【转】js-ES6学习笔记-Symbol
原文:https://www.cnblogs.com/zczhangcui/p/6435652.html https://blog.mgechev.com/2017/09/16/developing- ...
- sql分页性能测试结果
--方案一: declare @d datetime set @d = getdate() ID from Info order by ID) order by ID select [not in方法 ...
- git fatal: https://github.com/TeaCodie/TeaCodie-Website.git/info/refs not found: did you run git update-server-info on the server 错误
错误: fatal: https://github.com/TeaCodie/TeaCodie-Website.git/info/refs not found: did you run git upd ...
- 算法笔记_023:拓扑排序(Java)
目录 1 问题描述 2 解决方案 2.1 基于减治法实现 2.2 基于深度优先查找实现 1 问题描述 给定一个有向图,求取此图的拓扑排序序列. 那么,何为拓扑排序? 定义:将有向图中的顶点以线性方式进 ...
- VmProtect v2.12.3 安装注冊
执行vmprotect.exe開始安装: 1.选择语言.默觉得"English": 2.欢迎页,点"Next"到下一步: 3.授权信息,选"I acc ...
- 动画曲线demo
<!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Strict//EN" "http://www.w3.org/TR/xht ...
- linux下安装oracle中遇到的一些问题
1.出现了:Environment variable ORACLE_UNQNAME not defined. Please set ORACLE_UNQNAME to da tabase unique ...
- How to authenticate a user by uid and password?
原文地址:Authentication options | Basic authorization If you want to use simple binds with user DN and p ...
- Android 打造完美的侧滑菜单/侧滑View控件
概述 Android 打造完美的侧滑菜单/侧滑View控件,完全自定义实现,支持左右两个方向弹出,代码高度简洁流畅,兼容性高,控件实用方便. 详细 代码下载:http://www.demodashi. ...