
【转】利用python的KMeans和PCA包实现聚类算法
转自:https://www.cnblogs.com/yjd_hycf_space/p/7094005.html
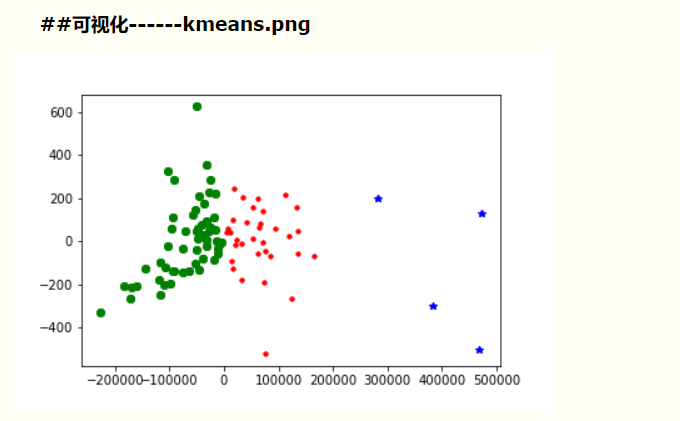
题目: 通过给出的驾驶员行为数据(trip.csv),对驾驶员不同时段的驾驶类型进行聚类,聚成普通驾驶类型,激进类型和超冷静型3类 。 利用Python的scikit-learn包中的Kmeans算法进行聚类算法的应用练习。并利用scikit-learn包中的PCA算法来对聚类后的数据进行降维,然后画图展示出聚类效果。通过调节聚类算法的参数,来观察聚类效果的变化,练习调参。
数据介绍: 选取某一个驾驶员的经过处理的数据集trip.csv,将该驾驶人的各个时间段的特征进行聚类。(注:其中的driver 和trip_no 不参与聚类)
字段介绍: driver :驾驶员编号;trip_no:trip编号;v_avg:平均速度;v_var:速度的方差;a_avg:平均加速度;a_var:加速度的方差;r_avg:平均转速;r_var:转速的方差; v_a:速度level为a时的时间占比(同理v_b , v_c , v_d ); a_a:加速度level为a时的时间占比(同理a_b, a_c); r_a:转速level为a时的时间占比( r_b, r_c)
聚类算法要求:
(1)统计各个类别的数目
(2)找出聚类中心
(3)将每条数据聚成的类别(该列命名为jllable )和原始数据集进行合并,形成新的dataframe,命名为new_df ,并输出到本地,命名为new_df.csv。
降维算法要求:
(1)将用于聚类的数据的特征的维度降至2维,并输出降维后的数据,形成一个dataframe名字new_pca
(2)画图来展示聚类效果(可用如下代码):
import matplotlib.pyplot asplt
d = new_pca[new_df['jllable'] == 0]
plt.plot(d[0], d[1], 'r.')
d = new_pca[new_df['jllable'] == 1]
plt.plot(d[0], d[1], 'go')
d = new_pca[new_df['jllable'] == 2]
plt.plot(d[0], d[1], 'b*')
plt.gcf().savefig('D:/workspace/python/Practice/ddsx/kmeans.png')
plt.show()
python实现代码如下:
from sklearn.cluster import KMeans

from sklearn.decomposition import PCA

import pandas as pd

import numpy as np

import matplotlib.pyplot as plt

df=pd.read_csv('trip.csv', header=0, encoding='utf-8')

df1=df.ix[:,2:]

kmeans = KMeans(n_clusters=3, random_state=10).fit(df1)

df1['jllable']=kmeans.labels_

df_count_type=df1.groupby('jllable').apply(np.size)

##各个类别的数目

df_count_type

##聚类中心

kmeans.cluster_centers_

##新的dataframe,命名为new_df ,并输出到本地,命名为new_df.csv。

new_df=df1[:]

new_df

new_df.to_csv('new_df.csv')

##将用于聚类的数据的特征的维度降至2维,并输出降维后的数据,形成一个dataframe名字new_pca

pca = PCA(n_components=2)

new_pca = pd.DataFrame(pca.fit_transform(new_df))

##可视化

d = new_pca[new_df['jllable'] == 0]

plt.plot(d[0], d[1], 'r.')

d = new_pca[new_df['jllable'] == 1]

plt.plot(d[0], d[1], 'go')

d = new_pca[new_df['jllable'] == 2]

plt.plot(d[0], d[1], 'b*')

plt.gcf().savefig('kmeans.png')

plt.show()


【转】利用python的KMeans和PCA包实现聚类算法的更多相关文章
- 利用python的KMeans和PCA包实现聚类算法
题目: 通过给出的驾驶员行为数据(trip.csv),对驾驶员不同时段的驾驶类型进行聚类,聚成普通驾驶类型,激进类型和超冷静型3类 . 利用Python的scikit-learn包中的Kmeans算法 ...
- 机器学习实战之 第10章 K-Means(K-均值)聚类算法
第 10 章 K-Means(K-均值)聚类算法 K-Means 算法 聚类是一种无监督的学习, 它将相似的对象归到一个簇中, 将不相似对象归到不同簇中.相似这一概念取决于所选择的相似度计算方法.K- ...
- 【机器学习实战】第 10 章 K-Means(K-均值)聚类算法
第 10 章 K-Means(K-均值)聚类算法 K-Means 算法 聚类是一种无监督的学习, 它将相似的对象归到一个簇中, 将不相似对象归到不同簇中.相似这一概念取决于所选择的相似度计算方法.K- ...
- 【机器学习实战】第10章 K-Means(K-均值)聚类算法
第 十 章 K-Means(K-均值)聚类算法 K-Means 算法 聚类是一种无监督的学习, 它将相似的对象归到一个簇中, 将不相似对象归到不同簇中.相似这一概念取决于所选择的相似度计算方法.K-M ...
- K-Means聚类算法原理
K-Means算法是无监督的聚类算法,它实现起来比较简单,聚类效果也不错,因此应用很广泛.K-Means算法有大量的变体,本文就从最传统的K-Means算法讲起,在其基础上讲述K-Means的优化变体 ...
- 一步步教你轻松学K-means聚类算法
一步步教你轻松学K-means聚类算法(白宁超 2018年9月13日09:10:33) 导读:k-均值算法(英文:k-means clustering),属于比较常用的算法之一,文本首先介绍聚类的理 ...
- 利用Python进行数据分析(7) pandas基础: Series和DataFrame的简单介绍
一.pandas 是什么 pandas 是基于 NumPy 的一个 Python 数据分析包,主要目的是为了数据分析.它提供了大量高级的数据结构和对数据处理的方法. pandas 有两个主要的数据结构 ...
- 利用Python进行数据分析(4) NumPy基础: ndarray简单介绍
一.NumPy 是什么 NumPy 是 Python 科学计算的基础包,它专为进行严格的数字处理而产生.在之前的随笔里已有更加详细的介绍,这里不再赘述. 利用 Python 进行数据分析(一)简单介绍 ...
- 利用Python进行数据分析(1) 简单介绍
一.处理数据的基本内容 数据分析 是指对数据进行控制.处理.整理.分析的过程. 在这里,“数据”是指结构化的数据,例如:记录.多维数组.Excel 里的数据.关系型数据库中的数据.数据表等. 二.说说 ...
随机推荐
- IdentityServer4-Resource定义-翻译
资源定义(Defining Resource) 通常,第一件事是定义那些你想保护的资源.这些资源可能是你的用户信息,比如个人数据,电子邮件或者对Api的访问. Note: 你可以用C#实体类来定义资源 ...
- 使用Nexus2.x为Maven3.x搭建私服构件仓库
前言 在笔者的前一篇博文<Use Maven3.x>中,笔者详细的讲解了如何通过使用Maven3.x来构建及管理你的项目.其中笔者提到过些关于私服的概念,但却没有明确的对私服做出详细的阐述 ...
- 阿里CentOS 7 卸载mysql5.6
查看当前安装mysql情况 rpm -qa|grep -i mysql 执行 yum remove mysql rpm -e mysql-community-release-el7-5.noarch ...
- 配置Tree Shaking来减少JavaScript的打包体积
译者按: 用Tree Shaking技术来减少JavaScript的Payload大小 原文: Reduce JavaScript Payloads with Tree Shaking 译者: Fun ...
- 本地navicate for mysql怎么修改密码?
1.以前在本地设置sql库密码,就是在本地新建数据库的时候就输入,怎么也链接不上,原来是新建数据库的时候不能输入密码,需要在内部修改. 2. 打开mysql user表 3. 打开mysql user ...
- Mysql数据库多表查询
一.介绍 首先说一下,我们写项目一般都会建一个数据库,那数据库里面是不是存了好多张表啊,不可能把所有的数据都放到一张表里面,肯定要分表来存数据,这样节省空间,数据的组织结构更清晰,解耦和程度更高,但是 ...
- maven 技巧
M2Eclipse Releases maven eclipse插件最新安装地址 Full Version Tag 1.0 2011-06-22 http://download.eclipse.org ...
- TortoiseSVN 1.9.5安装 与 Eclipse4.4.2及以上版本中安装SVN插件
引自: http://blog.csdn.net/chenchunlin526/article/details/54631458 TortoiseSVN 1.9.5安装 与 Eclipse4.4.2及 ...
- Salesforce的报表和仪表板
报表是现代企业中最常用到的功能之一.Salesforce中提供了强大的报表和仪表板功能. 报表和仪表板简介 报表是一组数据展示,用户可以自定义规则,只有符合相应规则的数据才会显示出来. Salesfo ...
- [Spark] Spark 安装配置
原文地址:https://www.cnblogs.com/memento/p/9148732.html Windows 上的单机版安装 下载地址:http://spark.apache.org/dow ...