
sparkthriftserver启动及调优
Sparkthriftserver启用及优化
1、 概述
sparkthriftserver用于提供远程odbc调用,在远端执行hive sql查询。默认监听10000端口,Hiveserver2默认也是监听10000端口,为了避免冲突,需要修改sparkthriftserver的端口。启用sparkthriftserver需要将hive-site.xml文件copy到spakr的conf目录下,元数据存储在mysql中,所以还需要mysql-connector-java-5.1.43-bin.jar,用于连接mysql。
2、 配置
1)hive-site.xml配置文明如下:
# cat hive-site.xml
<configuration>
<property>
<name>hive.server2.thrift.bind.host</name>
<value>0.0.0.0</value>
<description>metadata is stored in a MySQL server</description>
</property>
<property>
<name>javax.jdo.option.ConnectionURL</name>
<value>jdbc:mysql://localhost:3306/metastore?createDatabaseIfNotExist=true</value>
<description>metadata is stored in a MySQL server</description>
</property>
<property>
<name>javax.jdo.option.ConnectionDriverName</name>
<value>com.mysql.jdbc.Driver</value>
<description>MySQL JDBC driver class</description>
</property>
<property>
<name>javax.jdo.option.ConnectionUserName</name>
<value>root</value>
<description>user name for connecting to mysql server</description>
</property>
<property>
<name>javax.jdo.option.ConnectionPassword</name>
<value>1qaz*@WSX</value>
<description>password for connecting to mysql server</description>
</property>
<property>
<name>hive.metastore.warehouse.dir</name>
<value>/data/metastore/</value>
<description>location of default database for the warehouse</description>
</property>
<property>
<name>bson.output.build_splits</name>
<value>false</value>
</property>
<property>
<name>bson.split.write_splits</name>
<value>false</value>
</property>
<property>
<name>bson.split.read_splits</name>
<value>false</value>
</property>
<property>
<name>hive.cli.print.header</name>
<value>true</value>
</property>
<property>
<name>mapred.reduce.child.java.opts</name>
<value>-Xmx2g</value>
</property>
</configuration>
2)首先将下载好的mysql-connector-java-5.1.43-bin.jar复制到spark的jars目录下
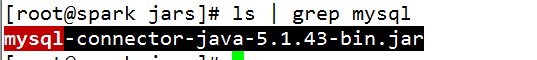
重新启动spark服务,会将jar加载进去。本文用的是将metastore存储到mysql,通过如下配置实现:
<property>
<name>javax.jdo.option.ConnectionURL</name>
<value>jdbc:mysql://localhost:3306/metastore?createDatabaseIfNotExist=true</value>
<description>metadata is stored in a MySQL server</description>
</property>
<property>
<name>javax.jdo.option.ConnectionDriverName</name>
<value>com.mysql.jdbc.Driver</value>
<description>MySQL JDBC driver class</description>
</property>
<property>
<name>javax.jdo.option.ConnectionUserName</name>
<value>root</value>
<description>user name for connecting to mysql server</description>
</property>
<property>
<name>javax.jdo.option.ConnectionPassword</name>
<value>1qaz*@WSX</value>
<description>password for connecting to mysql server</description>
</property>
配置完成后,需要到mysql里面进行授权,例如本例:
>grant metastore.* to root@localhost identified by ‘1qaz*@WSX’;
>flush privileges;
3、 启动
启动sparkthriftserver很简单,只需要到spark的sbin目录下,有个start-thriftserver.sh,直接执行这个脚本就可以成功启动了。如果内网有防火墙只需要开放端口或做端口映射就可以了,这里不做详尽的介绍。
#cd /data/spark-2.2.0-bin-hadoop2.7/sbin
#./start-thriftserver.sh
这样一个默认配置的服务就启动好了,可以通过远端下载相应的ODBC工具进行连接,我们需要tableau使用,所以下载Simba Spark 1.2 64-bit。具体安装配置见另外一篇文章:。
这样测试环境可以使用,但是线上用这样的配置就会经常发生服务蹦掉现象,所以需要进行优化。
4、 优化
优化主要在两个方面入手:1是spark;2是thriftserver
Spark优化,见spark的文章。此处只对2进行介绍:
启动的时候指定executor-memory、total-executor-cores:
启动方式如下:
./start-thriftserver.sh --hiveconf hive.server2.thrift.port=10000 --master spark://spark:7077 --driver-class-path /data/spark-2.2.0-bin-hadoop2.7/jars/mysql-connector-java-5.1.43-bin.jar --executor-memory 5g --total-executor-cores 5
--hiveconf 指定启动的端口,也可以写在hive-site.xml里面;--master指定spark的地址 spark://spark:7077 第二个spark是spark所在服务器的主机名,需要在hosts文件里面做一下解析,添加一条记录。
--executor-memory 5g 指定每个executor占用的内存大小,我这里设置了5g这个需要根据自己的环境和数据量的大小来确定;--total-executor-cores 5指定占用的cpu核数,这个值需要根据当前服务器的总的cpu核数以及其他服务使用cpu的情况来确定。此处指定的内存和cpu的core是永久占用的。可以在spark UI来查看。
5、为了方便启动和重启,制作了一个启动脚本
#cat /etc/init.d/spark-thriftserver.sh
#!/bin/bash
# chkconfig: 90 79 80
# descriptions: This script is using to satrt|stop spark-thriftserver
pid=`netstat -tunlp | grep 10000| awk '{print $NF}'|awk -F "/" '{print $1}'`
case $1 in
start)
cd /data/spark-2.2.0-bin-hadoop2.7/sbin/
./start-thriftserver.sh --hiveconf hive.server2.thrift.port=10000 --master spark://spark:7077 --driver-class-path /data/spark-2.2.0-bin-hadoop2.7/jars/mysql-connector-java-5.1.43-bin.jar --executor-memory 5g --total-executor-cores 5
;;
stop)
kill -9 $pid
;;
*)
echo "Usage: $0 satrt|stop"
esac
sparkthriftserver启动及调优的更多相关文章
- jvm启动参数调优
1.背景 eclipse启动了一个项目,用了15分钟,我佛了,在家办公也懒得弄一直没管,好嘛,越用越气,越来越慢,现在启动一次要半小时了,气不气,然后下定决心调优一下. 2.知识库(自认为调优重要的几 ...
- Intellj IDEA 启动参数调优
(修改前记得备份) 修改IntellJ/bin/idea.exe.vmoptions修改成 -Xms512m -Xmx512m -Xmn164m -XX:MaxPermSize=250m -XX:Re ...
- 技能篇:linux服务性能问题排查及jvm调优思路
只要业务逻辑代码写正确,处理好业务状态在多线程的并发问题,很少会有调优方面的需求.最多就是在性能监控平台发现某些接口的调用耗时偏高,然后再发现某一SQL或第三方接口执行超时之类的.如果你是负责中间件或 ...
- [hadoop] 集群启动和内存调优
1.启动Hadoop集群 #首先查看下zoo.cfg里面配置的server.id和集群主机的id是否一致 #如果不一致会造成yarn控制不了从节点的启动 cat /home/hadoop/zookee ...
- Eclipse的设置、调优、使用(解决启动卡顿等问题)----转
eclipse调优 一般在不对eclipse进行相关设置的时候,使用eclipse总是会觉得启动好慢,用起来好卡,其实只要对eclipse的相关参数进行一些配置,就会有很大的改善. 加快启动速度 1. ...
- Tomcat性能调优后, 启动出现警告问题 [did not find a matching property.]
http://blog.csdn.net/dracotianlong/article/details/8963594 Tomcat性能调优后, 启动出现警告问题 [did not find a mat ...
- eclipse定制化配置调优、初始化配置指南、可以解决启动慢等问题
配置eclipse的jvm参数 打开eclipse根目录下的eclipse.ini在最后面加上如下的jvm参数 -Xms400m -Xmx1400m -XX:NewSize=128m -XX:MaxN ...
- Java启动参数及调优
java启动参数共分为三类: 其一是标准参数(-),所有的JVM实现都必须实现这些参数的功能,而且向后兼容:其二是非标准参数(-X),默认jvm实现这些参数的功能,但是并不保证所有jvm实现都满足,且 ...
- 阿里云下 centos7下启动程序总是被killed ,看内存占用情况以检查哪些服务存在问题并调整参数作调优
很久不搭理自己的网站了,几天突然发现启动程序总是被killed, 于是查看了系统日志 vi /var/log/messages 发现出现 kernel: Out of memory: Kill pro ...
随机推荐
- Android-Thread线程的状态
介绍Thread线程的状态之前,必须要讲解CPU执行线程的随机性: 例如:有五个线程,CPU中央处理器,在执行这五个线程的时候,有可能先执行Thread-0,有可能先执行Thread-3,等等,都有可 ...
- Leader Election 选举算法
今天讲一讲分布式系统中必不可少的选举算法. leader 就是一堆服务器中的协调者,某一个时刻只能有一个leader且所有服务器都承认这个leader. leader election就是在一组进程中 ...
- HTTP的瓶颈
http协议,1.0或1.1版本,一个连接智能发送一个请求,通信都是基于请求/响应方式的,请求只能从客户端发起(半双工),发送冗长的首部. 在交互比较频繁的社交网站等,一直轮训带来的网络及服务器压力是 ...
- vs2017 xamarin新建单独UWP类库提示不兼容
One or more projects are incompatible with UAP,Version=v10.0 (win10-arm). One or more projects are i ...
- Cordova - XCode10编译热更新插件错误解决方法!
操作系统:OSX10.14 XCode:10.1 热更新插件:https://github.com/nordnet/cordova-hot-code-push 这个热更新插件,在安卓下编译,没有问题, ...
- Mybatis的cache
相关类:org.apache.ibatis.executor.CachingExecutor 相关代码: public <E> List<E> query(MappedStat ...
- poj2488 A Knight's Journey
http://poj.org/problem?id=2488 题目大意:骑士厌倦了一遍又一遍地看到同样的黑白方块,于是决定去旅行. 世界各地.当一个骑士移动时,他走的是“日”字.骑士的世界是他赖以生存 ...
- PHP之旅4 php 超全局变量
预定义数组: 自动全局变量---超全局数组 1.包含了来自web服务器,客户端,运行环境和用户输入的数据 2.这些数组比较特别 3.全局范围内自动生效,都可以直接使用这些数组 4.用户不能自定义这些数 ...
- android应用程序的混淆打包
android应用程序的混淆打包 1 . 在工程文件project.properties中加入下proguard.config=proguard.cfg , 如下所示: target=android- ...
- git连接通过ssh连接github
解决 git连接通过ssh连接github 1. 首先产生一个rsa的私钥和公钥 ssh-keygen -t rsa -C "15950093214@163.com" //你的g ...