
Atlas2.2.0编译、安装及使用(集成ElasticSearch,导入Hive数据)
1、编译阶段
组件信息:
| 组件名称 | 版本 |
|---|---|
| Atals | 2.2.0 |
| HBase | 2.2.6 |
| Hive | 3.1.2 |
| Hadoop | 3.1.1 |
| Kafka | 2.11_2.4.1 |
| Zookeeper | 3.6.2 |
| ElasticSearch | 7.12.1 |
架构: x86 (已知arm编译时会报node-sass缺少的问题,git上没有对应arm架构的包)
操作系统:CentOS 7.6
说明:
1、编译不包括其内嵌的HBase和Solr,只编译Atlas本身
2、下面的步骤中有些并非编译过程报错,而是具体使用中或导入hive元数据时报的错,提前修改
步骤:
step1:官网下载Atlas-2.2.0源码,解压
step2:配个国内源。可以在maven的conf目录下settings.xml里配置,也可以在项目的pom.xml里配置,这里贴阿里源做参考
step3:提前从Here下一个nodejs的包放到maven仓库下,目录参考
$MAVEN_REPOSITORY/com/github/eirslett/node/12.16.0/node-12.16.0-linux-x64.tar.gz
注意下下来的包名字叫node-v12.16.0-linux-x64.tar.gz,放在maven仓库里的时候要把里面的v去掉。如果不提前下,编译时候自己下载的速度很慢
step4:主pom.xml里添加下面两个依赖
                        <dependency>

                <groupId>org.restlet.jee</groupId>

                <artifactId>org.restlet</artifactId>

                <version>2.4.0</version>

            </dependency>


            <dependency>

                <groupId>org.restlet.jee</groupId>

                <artifactId>org.restlet.ext.servlet</artifactId>

                <version>2.4.0</version>

            </dependency>
step5:修改./intg/src/main/java/org/apache/atlas/ApplicationProperties.java
注释掉line 365 LOG.info("Setting " + SOLR_WAIT_SEARCHER_CONF + " = " + getBoolean(SOLR_WAIT_SEARCHER_CONF));
这步是因为我们采用es作为查询引擎,solr的相关配置都会注释掉,而这行调用会在导入hive元数据的时候报错
step6:把项目里的jsr311-api改成javax.ws.rs-api (6处,可以直接在项目目录下grep -rn搜), 并修改主pom.xml中jsr.version为2.0.1
这步主要影响六个支持的组件的数据导入及后续,包括
hbase、hive、sqoop、impala、falcon、storm
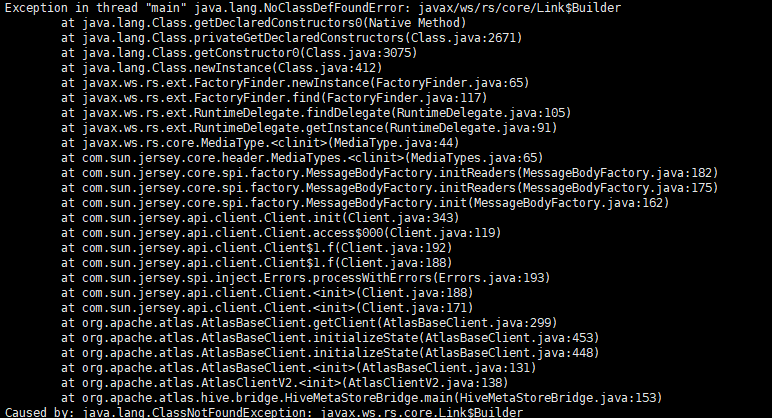
主要原因:jsr311-api包中javax.ws.rs.core包中没有Link类,而Atlas以HBase作为元数据存储,HBase本身使用的为javax.ws.rs-api包中的core包,其中有Link类,所以调用脚本导入数据时会报以下错误
step7:执行编译命令mvn clean package -DskipTests -Drat.skip=true -Pdist
编译后的包在./distro/target目下,server包即为Atlas部署包,bin包为集成了常用hook(如hbase-hook)的部署包
2、部署阶段
前置条件:
集群内有正常运行且可用的hadoop、hive、hbase、kafka、zk、es,且atlas所在节点必须有hbase及hive的配置文件目录
步骤:
step1:解压atlas-bin包(这里以/data/apps为例,顺便改个名
tar -zxvf apache-atlas-2.2.0-bin.tar.gz -C /data/apps

mv apache-atlas-2.2.0 atlas-2.2.0
step2:解压hook包(这里以hive-hook为例),并拷贝内容到atlas安装目录下
tar -zxvf apache-atlas-2.2.0-hive-hook.tar.gz -C /data/apps/

/usr/bin/cp /data/apps/apache-atlas-hive-hook-2.2.0/* /data/apps/atlas-2.2.0/
step3:修改atlas配置文件(有的配置是已有的,修改即可;有的配置没有,需要加)
atlas-application.properties:
     #atlas server config

             atlas.rest.address=http://atlas-ip:21000

        atlas.server.run.setup.on.start=false

     #hbase config

        atlas.audit.hbase.tablename=apache_atlas_entiry_audit

        atuls.audit.zookeeper.session.timeout.ms=1000

        atlas.audit.hbase.zookeeper.quorum=zk地址

             atlas.graph.storage.hostname=zk地址

     #solr config

      #注释掉所有和solr相关的配置项

     #es config

              atlas.graph.index.search.backend=elasticsearch

        atlas.graph.index.search.hostname=es-ip:9200

        atlas.graph.index.search.elasticsearch.client-only=true

        atlas.graph.index.search.elasticsearch.http.auth.type=basic

        atlas.graph.index.search.elasticsearch.http.auth.basic.username=elastic

        atlas.graph.index.search.elasticsearch.http.auth.basic.password=Cestc!666

    #kafka config

             atlas.nofification.embedded=false

        atlas.kafka.data=/data/log/kafka

        atlas.kafka.zookeeper.connect=zk地址/kafkaCluster

        atlas.kafka.bootstrap.servers=kafka地址

    #hive config

             atlas.hook.hive.numRetries=3

        atlas.hook.hive.queueSize=10000

        atlas.cluster.name=primary
atlas-env.sh:
export HBASE_CONF_DIR=/data/apps/hbase-2.2.6/conf
atlas-log4j.xml:
#去掉org.apache.log4j.DailyRollingFileAppender一块的注释来暴露性能指标
step4:将atlas-application.properties分发到所有hive所在节点的hive/conf目录下
step5:分发hive-hook目录到hive节点下,并修改hive配置文件
ssh hive-node "mkdir -p /data/apps/atlas-2.2.0/hook"

scp -r /data/apps/atlas-2.2.0/hook/hive hive-node:$PWD
hive-site.xml
           <property>

            <name>hive.exec.post.hooks</name>

            <value>org.apache.atlas.hive.hook.HiveHook</value>

        </property>
hive-env.sh
export HIVE_AUX_JARS_PATH=/data/apps/atlas-2.2.0/hook/hive
step6:重启Hive
step7:调用atlas启动脚本启动服务
$ATLAS_HONE/bin/atlas_start.py
启动过程如下图所示

该过程会耗时较久,包含index创建、数据的初始化等操作
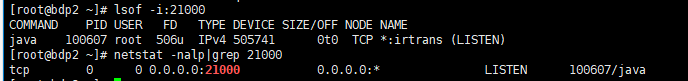
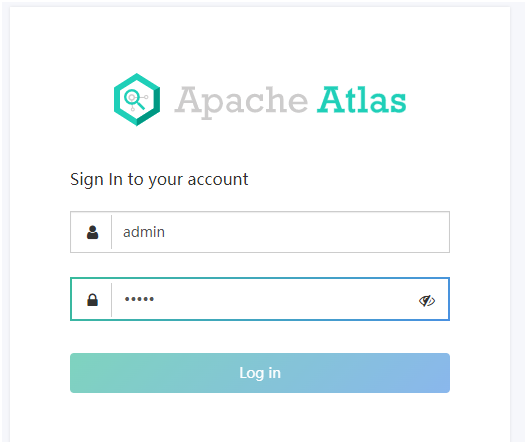
此时可以跟一下atlas的启动日志,直到日志不再刷新,再lsof或netstat查一下21000是否已经监听了,如已存在,则打开浏览器输入ip:21000登录atlas页面
千万不要相信他提示的Apache Atlas Server started!!!和jps显示的Atlas进程,因为启动脚本超过一定时间后一定会报成功,但此时21000端口还未被监听,服务是不可用的,真正可用还是以21000被成功监听,可以进到Atlas登录页面为准
3、使用阶段
说明:
此处我们以Hive的元数据导入及使用为例,其它数据源使用类似
步骤:
step1:进入atlas安装目录下,执行hook-bin中的import-hive.sh脚本
$ATLAS_HOME/hook-bin/import-hive.sh
执行后如下图
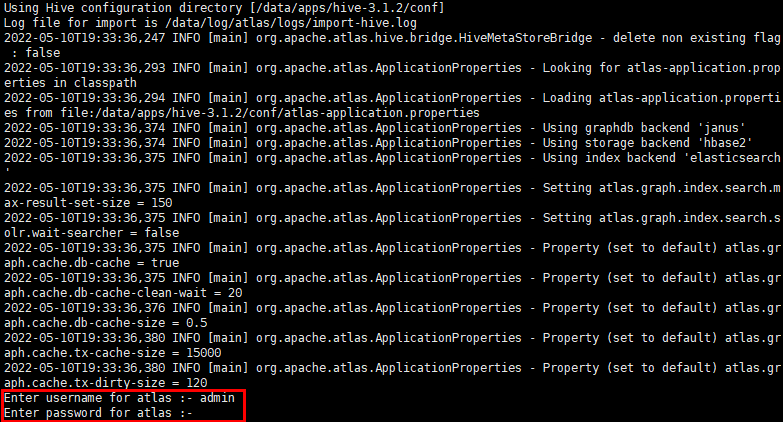
过程中会提示输入atlas用户名和密码,都输入admin即可
成功后会提示

该过程时间视hive现有数据量大小而定
step2:登录Atlas Web页面
打开浏览器输入ip:21000登录atlas页面
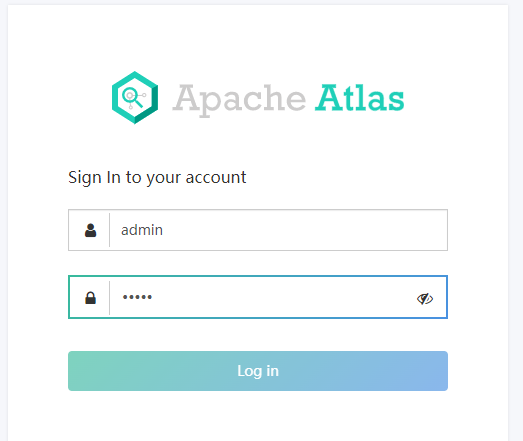
登录后如下图
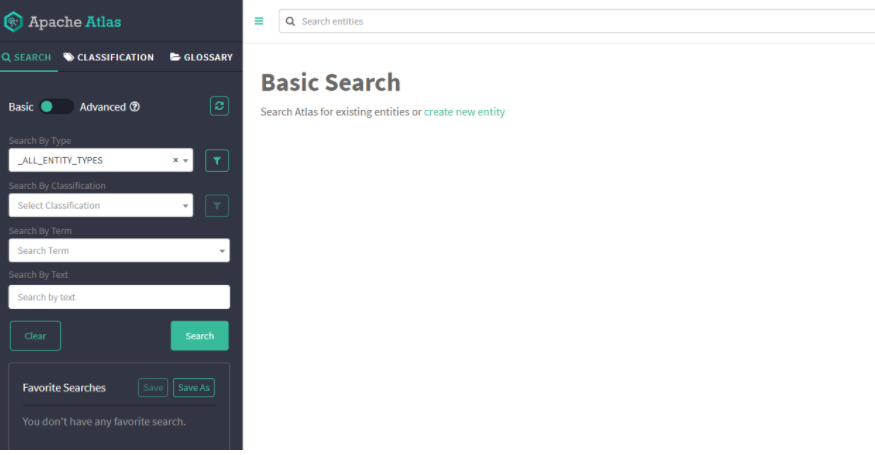
此时可以点击右上角小图标
查看总体数据情况

查看所有hive表
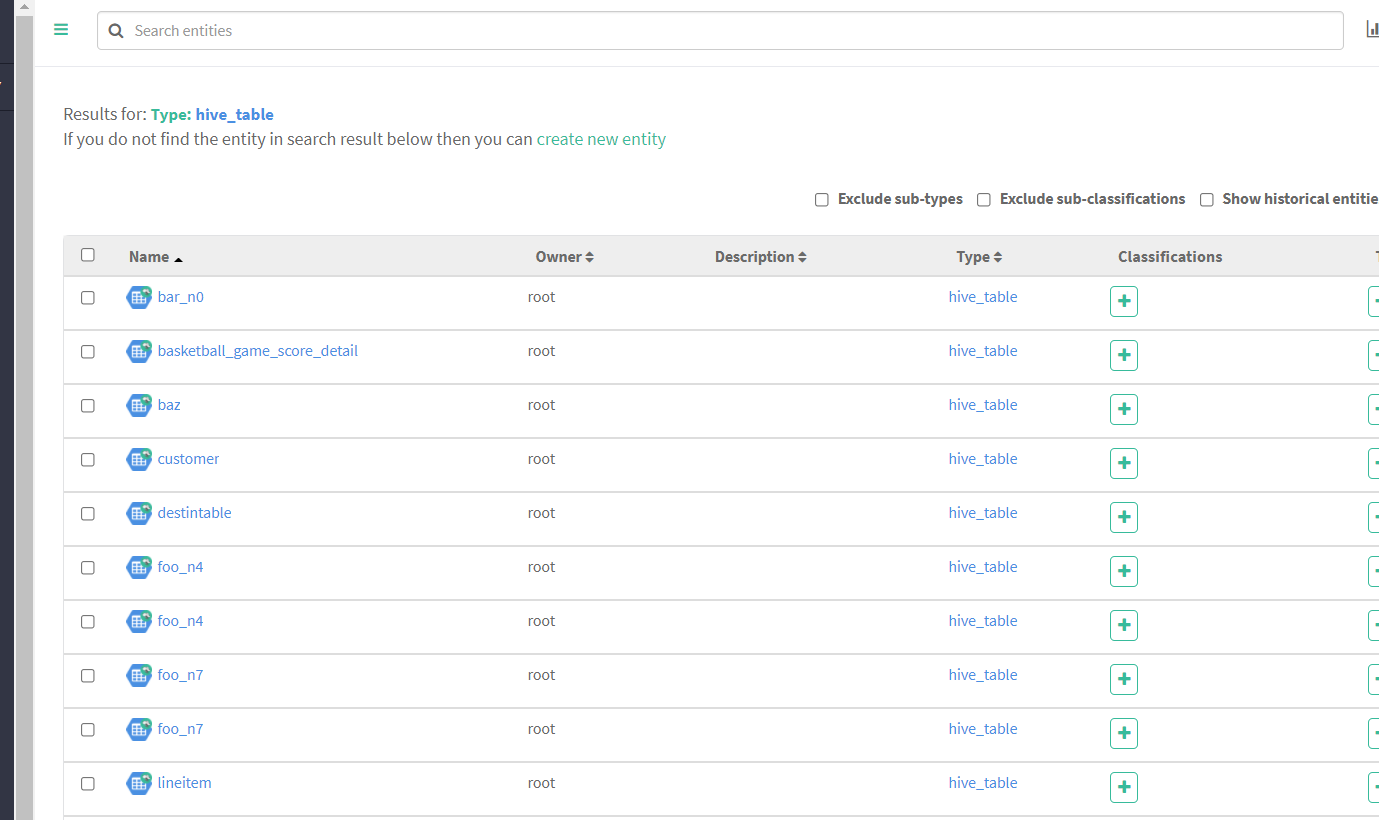
随便点击一个表查看详情
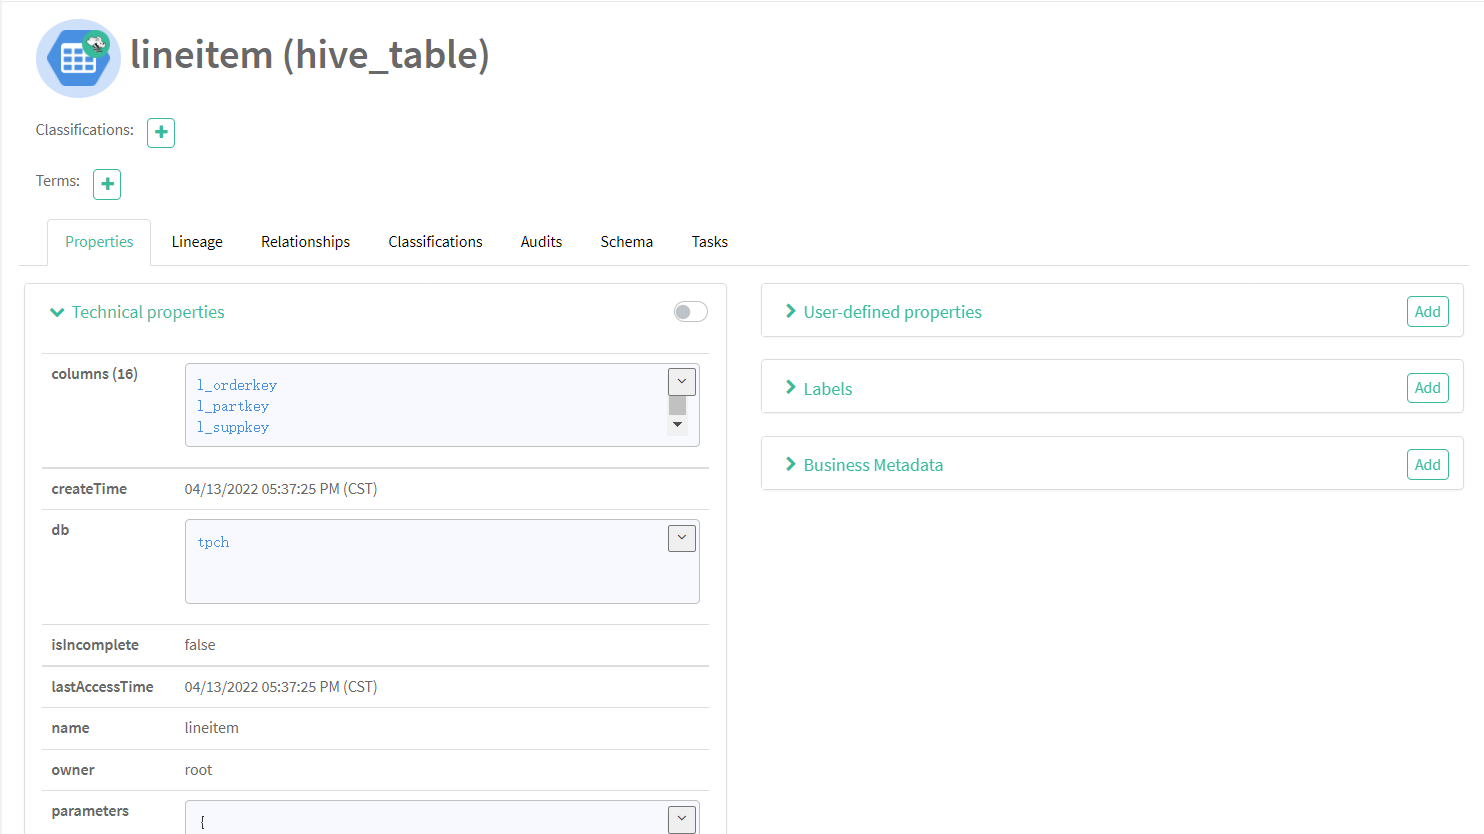
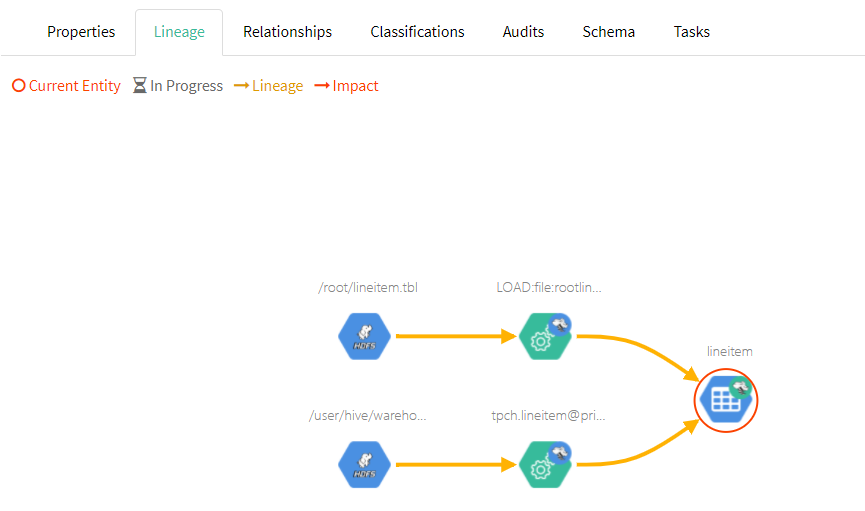
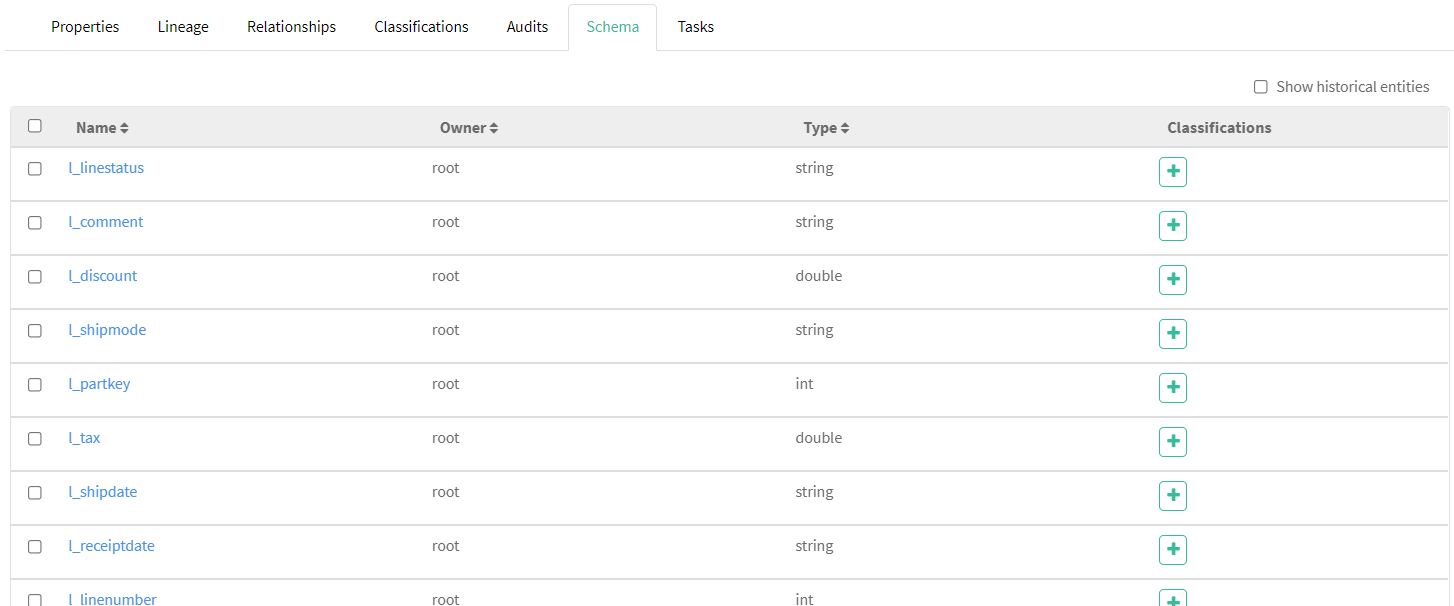
可以清楚地看到这个表的各项信息、字段及血缘图等
我们也可以通过左侧搜索栏检索过滤想要查找的项

以上就是我在生产环境中部署Atlas-2.2.0并集成es、hive的过程,使用时可以点击页面操作,也可通过调用Rest API集成到自己系统里用
本文首发于博客园,作者榆天紫夏,希望对大家有所帮助。原文地址https://www.cnblogs.com/yutianzixia/p/16257916.html。如有遗漏或问题欢迎补充指正
Atlas2.2.0编译、安装及使用(集成ElasticSearch,导入Hive数据)的更多相关文章
- CentOS 7.0编译安装Nginx1.6.0+MySQL5.6.19+PHP5.5.14
准备篇: CentOS 7.0系统安装配置图解教程 http://www.osyunwei.com/archives/7829.html 一.配置防火墙,开启80端口.3306端口 CentOS 7. ...
- centos 7.0 编译安装php 7.0.3
php下载页面 http://cn2.php.net/downloads.php 7.0.3多地区下载页面 http://cn2.php.net/get/php-7.0.3.tar.gz/from/a ...
- Valgrind 3.11.0编译安装
Valgrind 3.11.0编译安装 Valgrind是一款用于内存调试.内存泄漏检测以及性能分析的软件开发工具. Valgrind遵守GNU通用公共许可证条款,是一款自由软件. 到3.3.0版本为 ...
- CentOS 7.0编译安装Nginx1.6.0+MySQL5.6.19+PHP5.5.14方法分享
一.配置防火墙,开启80端口.3306端口 CentOS 7.0默认使用的是firewall作为防火墙,这里改为iptables防火墙. 1.关闭firewall: systemctl stop fi ...
- Redis 3.0 编译安装
Redis 3.0 编译安装 http://www.xuchanggang.cn/archives/991.html
- centos 7.0 编译安装php 5.6.7
编译安装php参考资料 MySQL PHP API http://dev.mysql.com/doc/apis-php/en/index.html nginx + php +mysql 最简单安装 官 ...
- centos 7.0 编译安装mysql 5.6.22 再次总结 成功编译安装~ 越来越熟练了~
查找php.ini文件所在位置 [root@localhost /]# find -name php.ini ./usr/etc/php/etc/php.ini mysql官网的安装说明http:// ...
- hadoop2.1.0编译安装教程
由于现在hadoop2.0还处于beta版本,在apache官方网站上发布的beta版本中只有编译好的32bit可用,如果你直接下载安装在64bit的linux系统的机器上,运行会报一个INFO ut ...
- hadoop2.1.0和hadoop2.2.0编译安装教程
由于现在hadoop2.0还处于beta版本,在apache官方网站上发布的beta版本中只有编译好的32bit可用,如果你直接下载安装在64bit的linux系统的机器上,运行会报一个INFO ut ...
随机推荐
- IOC 初始化源代码阅读之我见
由于本人的能力有限,只能说出自己的见解,如有错漏什么的,请大家批评指出.由于代码封装太多,这里只列出了我认为的部分最重要的代码,一些简单的封装代码,不在下面列出.由于代码太过于复杂,在本次博客中,只列 ...
- WSGI是个啥?大白话告诉你wsgi做了什么!
定义: 官方定义:wsgi是Web服务器网关接口(Python Web Server Gateway Interface,缩写为WSGI)是为Python语言定义的Web服务器和Web应用程序或框架之 ...
- css预编译--sass进阶篇
基础篇中主要介绍了一些sass的基本特性,进阶篇中,主要是写一些我们常用的sass控制命令,函数和规则. 控制命令 可能看过基础篇的朋友会发现在有些代码中出现@if @else @each等,熟悉JS ...
- css3 弹性布局和多列布局
弹性盒子基础 弹性盒子(Flexible Box)是css3中盒子模型的弹性布局,在传统的布局方式上增加了很多灵活性. 定义一个弹性盒子 在父盒子上定义display属性: #box{ display ...
- 使用Webpack+Gulp开发运行于Dcloud平台HTML5+引擎的混合APP项目经验分享
什么是5+Runtime? 首先简单介绍一下5+Runtime: HTML5 Plus Runtime(5+Rumtime)是由Dcloud开发的一套"增强版的手机浏览器引擎",与 ...
- Hadoop伪分布式集群实现SSH免密登录
在启动Hadoop时候报了这样一个错误: Starting namenodes on [hadoop] hadoop: (Permission denied (publickey,gssapi-key ...
- potoshop cs6安装配置16错误解决办法(win10系统)
问题截图如下: 解决方法: 右击图标选择属性:选择兼容性-->兼容模式-->以管理员身份运行-->应用 然后就可以打开了!
- Element instanceof Node
今天看到一个问题,问 Element instance Node 为什么是 false. 首先,我们知道 Element 是 Node 的子类,那么为什么 Element instanceof Nod ...
- Java学习——数组的基础知识
数组的特点.分类:一维.二维数组的使用:数组的声明和初始化.调用数组的指定位置的元素.获取数组的长度.遍历数组.数组元素的默认初始化值
- jni有关知识点总结
一.c/c++语言: 1.关于动态链接库的搜索问题: LIBRARY_PATH is used by gcc before compilation to search for directories ...