
pyspark 中的rdd api 编码练习
1,使用pyspark 的rdd api 进行了数据文件的处理,包括构建RDD, 统计分析RDD ,从文件中读取数据RDD,从文件中构建 rdd的模式shema.
然后通过模式,从rdd中生成dataframe。
2,代码
'''

构建sparkSession 和练习数据(RDD 和 KV rdd)

'''

spark = SparkSession.builder.appName("rdd_api_test") \

    .master("local[2]") \

    .getOrCreate()

sc = spark.sparkContext

rdd1 = sc.parallelize([1, 5, 60, 'a', 9, 'c', 4, 'z', 'f'])

rdd2 = sc.parallelize([('a', 6),

                       ('a', 1),

                       ('b', 2),

                       ('c', 5),

                       ('c', 8),

                       ('c', 11)])

'''

查看rdd元素 , 元素个数, KV对RDD中key的出现次数, 分区个数等常用api

'''

print(rdd2.collect())

print (rdd2.take(2))

print('amount of elements:', rdd2.count())

print('RDD count of key:', rdd2.countByKey())

print('RDD output as map:', rdd2.collectAsMap())

print('RDD number of partitions:', rdd2.getNumPartitions())

'''

数值型rdd ,常用统计函数, 最小,最大 ,平均 , 标准差,方差

'''

rdd5 = sc.parallelize(range(100))

print('RDD Min:', rdd5.min())  # rdd 最小值

print('RDD Max:', rdd5.max())

print('RDD Mean:', rdd5.mean())

print('RDD Standard deviation:', rdd5.stdev())

print('RDD Variance:', rdd5.variance())

'''

从文件读取数据,并且去掉第一行列名,进行显示

数据源:nba.csv

'''

full_csv = sc.textFile('nba.csv')

header = full_csv.first()

print(full_csv.filter(lambda line: line != header).take(4))  # 去掉头行后,看效果

'''

从文档中读出文件头部,设置rdd模式,然后把RDD转化为df

数据源:本地文件:customerheaders.txt

数据样例:

id:string

full_name:string

    ...

'''

from pyspark.sql.types import IntegerType, DoubleType, StringType, StructType, StructField

header_list = sc.textFile('customerheaders.txt') \

    .map(lambda line: line.split(":")).collect()  # 返回数组,元素为[id string]...

def strToType(str):  # string 映射到 DataType

    if str == 'int':

        return IntegerType()

    elif str == 'double':

        return DoubleType()

    else:

        return StringType()

schema = StructType([StructField(t[0], strToType(t[1]), True) for t in header_list])  # 列表构造器 构造 StructType

for item in schema:

    print(item)

'''

对原始文件rdd中每一行进行规范化处理

数据举例:

7,Mohandas MacRierie,mmacrierie0@xrea.com,11/24/1990,Fliptune,-7.1309871,111.591546,

254,Rita Slany,rslany1@ucla.edu,8/7/1961,Yodoo,48.7068855,2.3371075,

'''

customers_rdd = sc.textFile('customers.txt')

'''

一行字符串的解析函数

逻辑:

    1,取出

'''

def parseLine(line):

    tokens = zip(line.split(","), header_list)  # 打包为元组的列表, [(7, [id string]),(Mohandas, [name string]), ... ]

    parsed_tokens = []

    for token in tokens:

        token_type = token[1][1]  # 取到数据的类型,然后转化该类型,并放入parsed_tokens

        print('token_type = ', token_type)

        if token_type == 'double':

            parsed_tokens.append(float(token[0]))

        elif token_type == 'int':

            parsed_tokens.append(int(token[0]))

        else:

            parsed_tokens.append(token[0])

    return parsed_tokens

records = customers_rdd.map(parseLine)  # 把文本字符串根据模式中对应的类型,转化为对象

for item in records.take(4):

    print(item)

df = spark.createDataFrame(records, schema)  # rdd --> df

print (df)

'''

其他一些API介绍:

rdd.foreach([FUNCTION]): 对每个元素执行函数

rdd.groupBy([CRITERA]):  分组聚合 like: ('a', 1) ('b',2) ('a', 3) --> ('a',Iterable(1,3)) ('b', 2)

rdd.subtract(rdd2):  做差集计算,元素在rdd中出现,没有在rdd2中出现

rdd.subtractByKey(rdd2): 同上,适用于KV rdd

rdd.sortBy([FUNCTION]): 自定义RDD元素排序

rdd.sortByKey():  按照key 进行排序,其中key的类型必须实现了排序逻辑

rdd.join(rdd2):   like : ('a', 1) ('b',2) ('a', 3) --> ('a',(1,3)) ('b', 2)

'''
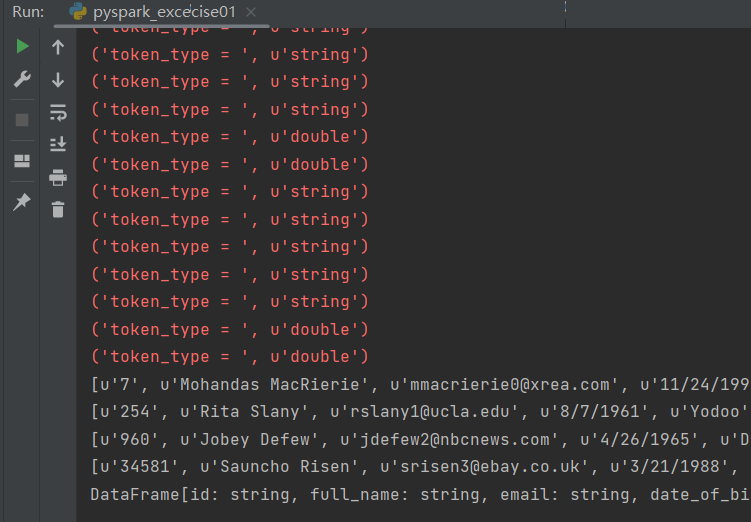
运行结果:
pyspark 中的rdd api 编码练习的更多相关文章
- spark 中的RDD编程 -以下基于Java api
1.RDD介绍: RDD,弹性分布式数据集,即分布式的元素集合.在spark中,对所有数据的操作不外乎是创建RDD.转化已有的RDD以及调用RDD操作进行求值.在这一切的背后,Spark会自动 ...
- Entity Framework 实体框架的形成之旅--Code First模式中使用 Fluent API 配置(6)
在前面的随笔<Entity Framework 实体框架的形成之旅--Code First的框架设计(5)>里介绍了基于Code First模式的实体框架的经验,这种方式自动处理出来的模式 ...
- ASP.NET MVC4中调用WEB API的四个方法
http://tech.it168.com/a2012/0606/1357/000001357231_all.shtml [IT168技术]当今的软件开发中,设计软件的服务并将其通过网络对外发布,让各 ...
- 【Socket编程】Java中网络相关API的应用
Java中网络相关API的应用 一.InetAddress类 InetAddress类用于标识网络上的硬件资源,表示互联网协议(IP)地址. InetAddress类没有构造方法,所以不能直接new出 ...
- [Spark][Python][DataFrame][RDD]DataFrame中抽取RDD例子
[Spark][Python][DataFrame][RDD]DataFrame中抽取RDD例子 sqlContext = HiveContext(sc) peopleDF = sqlContext. ...
- Spark RDD API扩展开发
原文链接: Spark RDD API扩展开发(1) Spark RDD API扩展开发(2):自定义RDD 我们都知道,Apache Spark内置了很多操作数据的API.但是很多时候,当我们在现实 ...
- Spark RDD API详解之:Map和Reduce
RDD是什么? RDD是Spark中的抽象数据结构类型,任何数据在Spark中都被表示为RDD.从编程的角度来看, RDD可以简单看成是一个数组.和普通数组的区别是,RDD中的数据是分区存储的,这样不 ...
- 【Java8新特性】面试官:谈谈Java8中的Stream API有哪些终止操作?
写在前面 如果你出去面试,面试官问了你关于Java8 Stream API的一些问题,比如:Java8中创建Stream流有哪几种方式?(可以参见:<[Java8新特性]面试官问我:Java8中 ...
- 记一次Hvv中遇到的API接口泄露而引起的一系列漏洞
引言 最近朋友跟我一起把之前废弃的公众号做起来了,更名为鹿鸣安全团队,后面陆续会更新个人笔记,有趣的渗透经历,内网渗透相关话题等,欢迎大家关注 前言 Hvv中的一个很有趣的漏洞挖掘过程,从一个简单的A ...
- WEB开发中的字符集和编码
html,body,div,span,applet,object,iframe,h1,h2,h3,h4,h5,h6,p,blockquote,pre,a,abbr,acronym,address,bi ...
随机推荐
- C语言中的快排函数——qsort
函数名 qsort(); 头文件 include<stdlib,h> 功能 对数组内的元素进行默认升序的快速排序 函数声明 void qsort( void *buf, size_t nu ...
- MongoDB数据库记录
启动 MongoDB 服务 标准 URI 连接语法: mongodb://[username:password@]host1[:port1][,host2[:port2],...[,hostN[:po ...
- el-table 在第一行添加合计行和操作按钮
1.预计效果如下 2.前端及样式部分 1)el-table <el-table size="small" stripe style="width: 100%&quo ...
- SRS视频服务器CallBack的Demo
1.安装环境(很麻烦,可以选择编译启动) 官方文档快速开始docker配置: docker run --rm -it -p 1935:1935 -p 1985:1985 -p 8080:8080 -d ...
- C++梳理
1.基础篇 1.C++ 中的四种智能指针 为什么要使⽤智能指针:智能指针其作⽤是管理⼀个指针,避免程序员申请的空间在函数结束时忘记释放,造成内存泄漏这种情况的发⽣.使⽤智能指针可以很⼤程度上的避免这个 ...
- brew基本操作指南
brew安装: /bin/zsh -c "$(curl -fsSL https://gitee.com/cunkai/HomebrewCN/raw/master/Homebrew.sh)&q ...
- .NET周报 【2月第4期 2023-02-25】
国内文章 .NET微服务系统迁移至.NET6.0的故事 https://www.cnblogs.com/InCerry/p/microservice-migration-net-6.html 本次迁移 ...
- 数据结构和算法day1(Java)
1.什么是数据结构? 数据结构就是把数据元素按照一定的关系组织起来的集合,用来组织和存储数据. 1.2.数据结构的分类: 逻辑结构 和物理结构 逻辑结构: 集合结构(无关系).线性结构(一对一).树形 ...
- 自定义顺序表ArrayList
1.简介 顺序表是在计算机内存中以数组的形式保存的线性表,线性表的顺序存储是指用一组地址连续的存储单元依次存储线性表中的各个元素.使得线性表中在逻辑结构上相邻的数据元素存储在相邻的物理存储单元中,即通 ...
- Ubuntu 安装 PHP
Ubuntu版本:20.04.1 LTS PHP版本:8.2.3 下载地址: https://www.php.net/downloads 官方文档:https://www.php.net/manual ...