
Hadoop学习
Hadoop: 大数据里面的公认的解决方案标准
链接推荐:http://www.powerxing.com/install-hadoop/
第一天 Hadoop的基本概念 伪分布式集群安装 hdfs mapreduce 演示
第二天 hdfs原理和使用操作
第三天 mapreduce 的原理和编程
第四天 常见mr算法实现和shuffle的机制
第五天 Hadoop2.x种HA机制的原理和全分布式集群安装部署及维护
第六天 hbase hive
第七天 strom+kafka
第八天 实战项目
What is Apache Hadoop?
The Apache Hadoop project develops open-source software for reliable, scalable, distributed computing.
Hadoop 来源
解决问题:
1.海量数据的存储 HDFS
2.海量数据的分析MapReduce
3.资源管理调度 YARN
作者:Doug Cutting
受Google三篇论文的启发(GFS、MapReduce、BigTable)
处理海量数据
面临着公共问题:任务调度、节点存活精度、数据共享、中间节点传递。。。
需要框架的出现,减少开发的工作量
标准框架Hadoop
1.解决特定领域的公共问题:海量集数据的处理
2.Hadoop不是数据库、是有好多框架组成的生态系统。
3.导出文本文件,不是放到数据库中。几十个T放不到MySQL中
4.根本就不是数据库的搞法,但是Hadoop包含有数据库NoSQl
5.直接对文本文件进行处理(写逻辑使用Java或者C++编程),然后分发到集群上进行运行,这就是MapReduce
6.几十个T的文件存储方式:使用HDFS存储,分布式集群,不是存储在一台机器上面,存储在很多的机器上。
7.海量数据的存储以及海量数据的分析 组成狭义的Hadoop
Hadoop 0.20~2.5.x发展:
从1.x到2.x多了YARN这部分。
将jar包分发到各个机器上,然后分配一定的资源以及进程资源。这些工作和自己所写的代码的逻辑没有关系。因此这部分的逻辑处理封装为YARN (资源管理调度),MapReduce只管逻辑不管资源分配了。
实时的逻辑计算。。。
Lucene 建立索引

把运算分布到分布的机器上进行运行
作者 Doug Cutting
GFS 存储数据
MapReduce
BigTable 就是一个数据库

解决存储的问题!!!
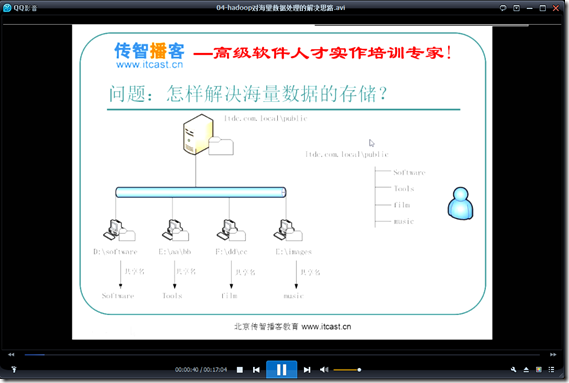
某些机器负载就会特别大,而其他的机器负载很小!!!
某些机器坏了,这样就会导致文件的丢失!!!
更加可靠更加复杂
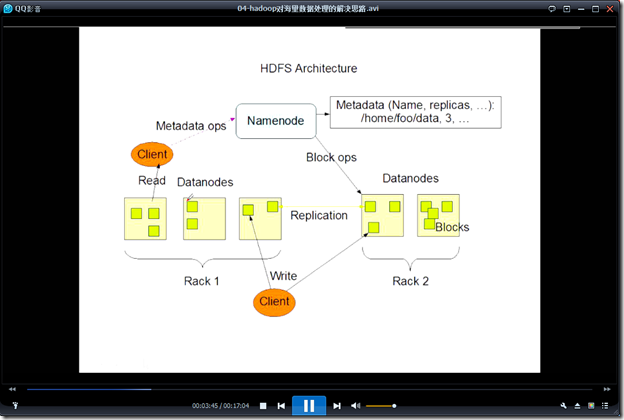
存储多个副本 即使宕机也没有关系,没有性能下降
文件所在的路径以及存储文件的路径应当有一个对应的关系,这个关系使用NameNode进行映射存储。

多个整数数字进行排序。!!!
能够并发运行的分开,分组并发
写两个程序:Map程序 在每个节点并发进行
Reduce程序 选择几个节点进行运行

安装-部署-开发-维护
2.4.1
2.5最新版本

最多解出的Cloudera CDH5 和Hadoop的版本号不是一致的
Aparche原生原汁原味
2.4.1
CenOS

搭建Hadoop
测试Hadoop
主机名zpfbuaa
端口219.142.245.200
修改hosts文件
# 219.142.245.200 zpfbuaa
219.142.245.200 zpfbuaa
向hadoop中put数据
1.hadoop fs -put 文件名 hdfs://zpfbuaa:9000/
在hadoop中创建文件夹
1.hadoop fs -mkdir /wordcount/
测试hadoop自带的jar包
1.在share文件夹下
进入hadoop
进入mapreduce
hadoop-mapreduce-examples-2.4.1.jar 包含示例程序
2.运行示例程序
a.hadoop jar hadoop-mapreduce-examples-2.4.1.jar pi 5 5
其中pi表示该程序用来计算pi的值 后面的5 5越大计算的pi的结果越精确
b.hadoop jar hadoop-mapreduce-examples-2.4.1.jar wordcount 文件所在目录 输出结果保存目录
可以先建立输出结果的保存目录,然后运行wordcount(计数程序)
配置文件
1.core-site-xml
修改
<property>

<name>fs.defaultFS</name>

<value>hdfs://zpfbuaa:9000/</value>

</property>

<property>

<name>hadoop.tmp.dir</name>

<value>/home/hadoop/app/hadoop-2.4.1/data/</value>

</property>
2.hdfs-site.xml
<property>

<name>dfs.replication</name>

<value>1</value>

</property>
3.mapred-site.xml
<property>

<name>mapreduce.framework.name</name>

<value>yarn</value>

</property>
4. yarn-site.xml
<property>

<name>yarn.resourcemanager.hostname</name>

<value>zpfbuaa</value>

</property>

<property>

<name>yarn.nodemanager.aux-services</name>

<value>mapreduce_shuffle</value>

</property>
5.slaves
修改为zpfbuaa
测试网络是否连通
使用指令 ping zpfbuaa
查看网页 zpfbuaa:8088

查看网页 zpfbuaa:50070

关闭linux防火墙
指令 service iptables stop
Hadoop学习的更多相关文章
- Hadoop学习之旅二:HDFS
本文基于Hadoop1.X 概述 分布式文件系统主要用来解决如下几个问题: 读写大文件 加速运算 对于某些体积巨大的文件,比如其大小超过了计算机文件系统所能存放的最大限制或者是其大小甚至超过了计算机整 ...
- Hadoop学习笔记—22.Hadoop2.x环境搭建与配置
自从2015年花了2个多月时间把Hadoop1.x的学习教程学习了一遍,对Hadoop这个神奇的小象有了一个初步的了解,还对每次学习的内容进行了总结,也形成了我的一个博文系列<Hadoop学习笔 ...
- Hadoop学习之旅三:MapReduce
MapReduce编程模型 在Google的一篇重要的论文MapReduce: Simplified Data Processing on Large Clusters中提到,Google公司有大量的 ...
- [Hadoop] Hadoop学习历程 [持续更新中…]
1. Hadoop FS Shell Hadoop之所以可以实现分布式计算,主要的原因之一是因为其背后的分布式文件系统(HDFS).所以,对于Hadoop的文件操作需要有一套全新的shell指令来完成 ...
- Hadoop学习笔记—2.不怕故障的海量存储:HDFS基础入门
一.HDFS出现的背景 随着社会的进步,需要处理数据量越来越多,在一个操作系统管辖的范围存不下了,那么就分配到更多的操作系统管理的磁盘中,但是却不方便管理和维护—>因此,迫切需要一种系统来管理多 ...
- Hadoop学习路线图
Hadoop家族产品,常用的项目包括Hadoop, Hive, Pig, HBase, Sqoop, Mahout, Zookeeper, Avro, Ambari, Chukwa,新增加的项目包括, ...
- Hadoop学习(5)-- Hadoop2
在Hadoop1(版本<=0.22)中,由于NameNode和JobTracker存在单点中,这制约了hadoop的发展,当集群规模超过2000台时,NameNode和JobTracker已经不 ...
- Hadoop学习总结之五:Hadoop的运行痕迹
Hadoop学习总结之五:Hadoop的运行痕迹 Hadoop 学习总结之一:HDFS简介 Hadoop学习总结之二:HDFS读写过程解析 Hadoop学习总结之三:Map-Reduce入门 Ha ...
- Hadoop学习笔记(7) ——高级编程
Hadoop学习笔记(7) ——高级编程 从前面的学习中,我们了解到了MapReduce整个过程需要经过以下几个步骤: 1.输入(input):将输入数据分成一个个split,并将split进一步拆成 ...
- Hadoop学习笔记(6) ——重新认识Hadoop
Hadoop学习笔记(6) ——重新认识Hadoop 之前,我们把hadoop从下载包部署到编写了helloworld,看到了结果.现是得开始稍微更深入地了解hadoop了. Hadoop包含了两大功 ...
随机推荐
- 使用maven来管理java项目
初学maven,简单总结一下学习心得,若有不对的地方,欢迎各位大神给我指正~ 总结分为6个部分 maven概述 maven安装 maven项目结构和创建方法 maven配置文件settings.xml ...
- Objective-C中的深拷贝和浅拷贝
在Objective-C中对象之间的拷贝分为浅拷贝和深拷贝.说白了,对非容器类的浅拷贝就是拷贝对象的地址,对象里面存的内容仍然是一份,没有新的内存被分配.对非容器类的深拷贝就是重写分配一块内存,然后把 ...
- 【JVM】JVM系列之JVM体系(一)
一.前言 为什么要学习了解Java虚拟机 1.我们需要更加清楚的了解Java底层是如何运作的,有利于我们更深刻的学习好Java. 2.对我们调试错误提供很宝贵的经验. 3.这是合格的Java程序必须要 ...
- 关于replace()方法中第二个参数的转义问题
如果你想通过Javascript代码在网页中呈现 \ 字符,则在JS代码中你必须输入两个反斜杠 \\,否则会报错.比如: var a = "\"; alert(a); //chro ...
- 小白Linux入门 四
http://edu.51cto.com/lesson/id-11372.html 28了 文件管理类命令 目录: mkdir mkdir /tmp/x mkdir -p /tmp/a/b -pv b ...
- jQuery-1.9.1源码分析系列(六) 延时对象
首先我们需要明白延时对象有什么用? 第一个作用,解决时序以及动态添加执行函数的问题. function a(){alert(1)}; function b(){alert(2)}; function ...
- 推荐13款优秀的Twitter Bootstrap JavaScript插件
Bootstrap是基于HTML,CSS和JavaScript的简洁灵活的流行前端框架及交互组件集,由微博先驱Twitter在2011年8月开源的整套前端解决解决方案,拥有非常完备和详尽的开发文档,有 ...
- 2.简单的Code First例子(EF Code-First系列)
现在假想,我们想要为讴歌学校创建一个应用程序,这个程序需要能够来添加或者更新学生,分数,教师还有课程信息. 代替之前我们的做法:先是创建数据库,现在我们不这么做,我们先来创建领域类,首先我来创建两个简 ...
- 解决Android工程里的xml文件自动提示问题
昨天晚上看某培训机构的Android的 视频教程,看到他在写布局的XML文件时,有很方便的自动提示功能.我就在自己的Eclipse里试了一下,可是我的没实现.就到网上查,很多都说:在 Window-& ...
- linq lambda left join
//var list = table1.Join(table2, ee => ee.Id, ff => ff.table1_Id, (ee, ff) => new { ee, ff ...