
Spark学习笔记2:RDD编程
通过一个简单的单词计数的例子来开始介绍RDD编程。
import org.apache.spark.{SparkConf, SparkContext}

object word {

  def main(args: Array[String]): Unit = {

    val conf = new SparkConf().setMaster("local").setAppName("word")

    val sc = new SparkContext(conf)

    val input = sc.parallelize(List("spark core scala python java spark scala"))

    val words = input.flatMap(line => line.split(" "))

    val counts = words.map(word => (word,1)).reduceByKey{case (x,y) => x + y}

    counts.foreach(println)

  }

}
使用Scala语言,IDE使用IntelliJ IDEA 。在IDEA上运行Spark应用需要添加Maven依赖。
<dependency>

            <groupId>org.apache.spark</groupId>

            <artifactId>spark-core_2.10</artifactId>

            <version>1.6.3</version>

</dependency>
运行结果:
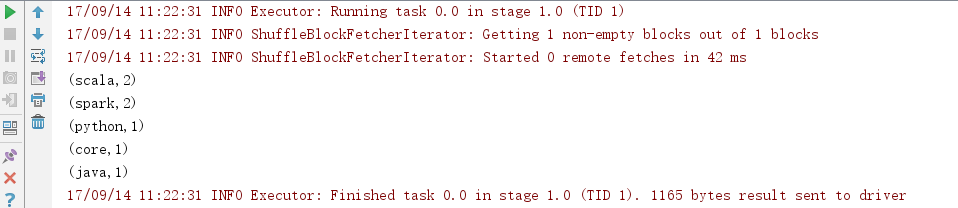
运行Spark应用,首先需要导入Spark包,这里使用Maven来连接公共仓库中的Spark包。
接下来创建一个SparkConf来配置应用,这里使用local即本地模式,方便调试代码。
然后基于这个SparkConf创建一个SparkContext对象。
有了SparkContext以后,就可以来访问Spark,创建RDD。sc.parallelize创建了一个Seq对象 RDD,可以对这个RDD进行操作。flatmap和map就是对这个RDD进行的一些操作完成单词计数,这些操作接下来将进行解释,最后将结果在后台显示出来。这样一个简单的Spark应用就完成了。
RDD编程
前一章介绍过 RDD即弹性分布式数据集,是Spark对数据的核心抽象,RDD就是分布式的元素集合。
Spark对数据的操作无外乎创建RDD,转化已有RDD以及调用RDD操作进行求值。Spark会自动将RDD中的数据分发到集群上,并将操作并行化执行。
- 创建RDD
可以使用两种方法创建RDD:读取一个外部数据集,或在驱动器程序里分发驱动器程序中的对象集合。
例如:SparkContext.textFile()用来读取文本文件作为一个字符串RDD。
lines = sc.textFile("input.txt")
还可以把程序中一个已有的集合传给SparkContext的parallelize()方法 如我们上面单词计数例子里的那样。
- RDD操作
RDD创建出来后,可以进行两种类型的操作:转化操作和行动操作。
a、转化操作
RDD的转化操作是返回新的RDD的操作,转化出来的RDD是惰性求值的,只有在行动操作中用到这些RDD时才会被计算。
常见转化操作有:
- map()操作用于接收一个函数,把这个函数用于RDD中的每个元素,将函数的返回结果作为结果RDD中对应元素的值。如 val counts = words.map(word =>(word,1)) 将每一个单词单词映射成键值对。
- filter()接受函数,将RDD中满足该函数的元素放入新的RDD中返回。
- flatMap()被分别应用到输入RDD的每个元素上,返回的是一个包含各个迭代器可访问的所有元素的RDD。可以用于将输入的字符串切分成单词。
- 集合操作:distinct() 生成只包含不同元素的新RDD, union(other)返回一个包含两个RDD中所有元素的RDD , intersection(other)只返回两个RDD中都有的元素,subtract(other)返回只存在于第一个RDD而不存在于第二个RDD中的元素,cartesian(other)笛卡儿积,返回所有可能的(a,b)对,a,b分别来自两个不同的RDD。
b、行动操作
行动操作把最终求得的结果返回到驱动器程序或者写入外部存储系统中。
常见的行动操作有:
- count()用来返回计数结果
- take(n)用来收集RDD中的n个元素
- collect()用来获取整个RDD中的元素
- reduce()用来接收一个函数作为参数,这个函数要操作两个相同元素类型的RDD数据并返回一个同样类型的新元素。 如 val sum = rdd.reduce( (x,y) => x+ y ) 用于计算输入集合中元素的和。
- fold() 和reduce()的区别是需要指定一个初始值作为每个分区第一次调用的结果。如 val sum = rdd.fold(1)(_ + _)
- aggregate()函数不同于fold()和reduce(),不要求返回值类型必须与所操作的RDD类型相同,使用aggregate()时需要提供返回类型的初始值。使用aggregate()计算RDD平均值如下:
val input = sc.parallelize(List(1,2,3,4,5,6,7,8,9,10))
val result = input.aggregate((0,0))(
(acc , value) => (acc._1 + value , acc._2 + 1)
(part1 , part2) => (part1._1 + part2._1 , part1._2 + part2._2))
val avg = result._1 / result._2.toDouble
aggregate()函数计算过程:
value是input中的值 , 即 1 到 10
在分布式计算中,将input分成多个分区,假设3个分区 ,分别计算 (1,2,3) (4,5,6) (7,8,9,10)
第一个分区用(acc , value) => (acc._1 + value , acc._2 + 1) 计算过程,初始值为0:
0 + 1 , 0 + 1
1 + 2 , 1 + 1
2 + 3 , 2 + 1
最终这个分区得到 (6,3) 即表示和为6,有3个元素。同样,另外两个分区得到(15,3) (34,4)
接着调用(part1 , part2) => (part1._1 + part2._1 , part1._2 + part2._2)) 这一步
将三个分区的和以及元素个数加起来得到(55,10)
- 持久化缓存
Spark在每次调用行动操作时都会重算RDD以及它的所有依赖,为了避免多次计算同一个RDD,可以让Spark对数据进行持久化。
持久化数据所在的节点发生故障时,Spark会在需要用到缓存的数据时重算丢失的数据分区。最好的做法是将数据备份到多个节点上。
使用persist()用来把数据以序列化的形式缓存,默认情况下会缓存在JVM的堆空间中。如果缓存的数据太多,内存中放不下,Spark会自动利用最近最少使用的缓存策略把最老的分区从内存中移除。
unpersist()用于手动把持久化的RDD从缓存中移除。
Spark学习笔记2:RDD编程的更多相关文章
- Spark学习笔记3——RDD(下)
目录 Spark学习笔记3--RDD(下) 向Spark传递函数 通过匿名内部类 通过具名类传递 通过带参数的 Java 函数类传递 通过 lambda 表达式传递(仅限于 Java 8 及以上) 常 ...
- Spark学习笔记2——RDD(上)
目录 Spark学习笔记2--RDD(上) RDD是什么? 例子 创建 RDD 并行化方式 读取外部数据集方式 RDD 操作 转化操作 行动操作 惰性求值 Spark学习笔记2--RDD(上) 笔记摘 ...
- Spark学习笔记之RDD中的Transformation和Action函数
总算可以开始写第一篇技术博客了,就从学习Spark开始吧.之前阅读了很多关于Spark的文章,对Spark的工作机制及编程模型有了一定了解,下面把Spark中对RDD的常用操作函数做一下总结,以pys ...
- Spark学习笔记11面向对象编程
面向对象编程 11.1 object类 11.1.1定义一个简单的类 11.1.2 field的getter与setter 定义类包含,定义类的field及方法.其格式如下 class Cla ...
- Spark菜鸟学习营Day3 RDD编程进阶
Spark菜鸟学习营Day3 RDD编程进阶 RDD代码简化 对于昨天练习的代码,我们可以从几个方面来简化: 使用fluent风格写法,可以减少对于中间变量的定义. 使用lambda表示式来替换对象写 ...
- spark学习笔记总结-spark入门资料精化
Spark学习笔记 Spark简介 spark 可以很容易和yarn结合,直接调用HDFS.Hbase上面的数据,和hadoop结合.配置很容易. spark发展迅猛,框架比hadoop更加灵活实用. ...
- Spark学习笔记0——简单了解和技术架构
目录 Spark学习笔记0--简单了解和技术架构 什么是Spark 技术架构和软件栈 Spark Core Spark SQL Spark Streaming MLlib GraphX 集群管理器 受 ...
- Spark学习笔记之SparkRDD
Spark学习笔记之SparkRDD 一. 基本概念 RDD(resilient distributed datasets)弹性分布式数据集. 来自于两方面 ① 内存集合和外部存储系统 ② ...
- Spark学习笔记-GraphX-1
Spark学习笔记-GraphX-1 标签: SparkGraphGraphX图计算 2014-09-29 13:04 2339人阅读 评论(0) 收藏 举报 分类: Spark(8) 版权声明: ...
- Spark学习笔记1——第一个Spark程序:单词数统计
Spark学习笔记1--第一个Spark程序:单词数统计 笔记摘抄自 [美] Holden Karau 等著的<Spark快速大数据分析> 添加依赖 通过 Maven 添加 Spark-c ...
随机推荐
- WebGL编程指南理论分析之物体层次模型(局部运动)
书中340页,开始讲到层次模型(关节模型),也就是整个物体,可以自由控制其各部位单独运动,就像关节一样,互不干扰或者有一定关联. 就像图中,左右键控制整个物体(arm1和arm2)的Y轴旋转,上下键控 ...
- NBUT 1223 Friends number 2010辽宁省赛
Time limit 1000 ms Memory limit 131072 kB Paula and Tai are couple. There are many stories betwee ...
- 【opencv基础】opencv和dlib库中rectangle类型之间的转换
前言 最近使用dlib库的同时也会用到opencv,特别是由于对dlib库的画图函数不熟悉,都想着转换到opencv进行show.本文介绍一下两种开源库中rectangle类型之间的转换. 类型说明 ...
- Ubuntu中敲写c语言步骤
1.进入Ubuntu界面 1.1按快捷键 Ctrl + Alt + T: 1.2 安装vim:输入 sudo apt-get install vim: 1.3 安装gcc:输入 sudo apt-ge ...
- PHPEmailer使用简介(以qq邮箱为例)
1.从网上下载PHPEmailer: 2.确保PHP环境支持sockets扩展,还要开启openssl,如下图: 3.配置QQ邮箱 1.开启SMTP服务 2.验证密保 3.获取授权码(这个就是IMAP ...
- [Boolan-C++学习笔记]第二周整理
1.对于String类型的类(含有指针) 其中的指针成员能够灵活的申请存储空间,但指针操作又带来内存泄漏的风险,变更指针的操作需要尤为谨慎. 要点在于写好BigThree 构造函数 { 完成成员初始化 ...
- WinHex简介
WinHex是一个专门用来对付各种日常紧急情况的小工具.它可以用来检查和修复各种文件.恢复删除文件.硬盘损坏造成的数据丢失等.同时它还可以让你看到其他程序隐藏起来的文件和数据.得到 ZDNetSoft ...
- cglib 简单 代理示例-1
引用包cglib-xxx.jar非Maven项目还需要手动引用包asm-xxx.jar业务类(不需要定义接口)cglib代理类(实现接口MethodInterceptor) 异常信息(项目只引用了cg ...
- idea快捷键 好的网址收藏
http://blog.csdn.net/u010800804/article/details/48491395http://blog.csdn.net/wei83523408/article/det ...
- web 纯 javascript 的MVC 实现的简单实践
现在javascript是越来越火了,好多javascript框架随之产生,大大简化了我们的开发,一般的开发模式大家是比较喜欢MVC 的model controller view 这种模式 方便了我们 ...