
spark教程(九)-操作数据库
数据库也是 spark 数据源创建 df 的一种方式,因为比较重要,所以单独算一节。
本文以 postgres 为例
安装 JDBC
首先需要 安装 postgres 的客户端驱动,即 JDBC 驱动,这是官方下载地址,JDBC,根据数据库版本下载对应的驱动
上传至 spark 目录下的 jars 目录
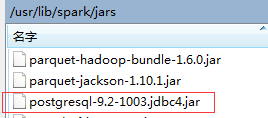
并设置环境变量
export SPARK_CLASSPATH = /usr/lib/spark/jars
编程模板
如何操作数据库,不同的版本方法不同,网上的教程五花八门,往往尝试不成功。
其实我们可以看 spark 自带的样例, 路径为 /usr/lib/spark/examples/src/main/python/sql 【编码时,sparkSession 需要声明 spark jars 的驱动路径,代码调用 API JDBC To Other Databases】
我从 datasource.py 中找到了基本的读写方法,其他自己可以看看
def jdbc_dataset_example(spark):

    # $example on:jdbc_dataset$

    # Note: JDBC loading and saving can be achieved via either the load/save or jdbc methods

    # Loading data from a JDBC source

    jdbcDF = spark.read \

        .format("jdbc") \

        .option("url", "jdbc:postgresql:dbserver") \

        .option("dbtable", "schema.tablename") \

        .option("user", "username") \

        .option("password", "password") \

        .load()

    jdbcDF2 = spark.read \

        .jdbc("jdbc:postgresql:dbserver", "schema.tablename",

              properties={"user": "username", "password": "password"})

    # Specifying dataframe column data types on read

    jdbcDF3 = spark.read \

        .format("jdbc") \

        .option("url", "jdbc:postgresql:dbserver") \

        .option("dbtable", "schema.tablename") \

        .option("user", "username") \

        .option("password", "password") \

        .option("customSchema", "id DECIMAL(38, 0), name STRING") \

        .load()


    # Saving data to a JDBC source

    jdbcDF.write \

        .format("jdbc") \

        .option("url", "jdbc:postgresql:dbserver") \

        .option("dbtable", "schema.tablename") \

        .option("user", "username") \

        .option("password", "password") \

        .save()

    jdbcDF2.write \

        .jdbc("jdbc:postgresql:dbserver", "schema.tablename",

              properties={"user": "username", "password": "password"})

    # Specifying create table column data types on write

    jdbcDF.write \

        .option("createTableColumnTypes", "name CHAR(64), comments VARCHAR(1024)") \

        .jdbc("jdbc:postgresql:dbserver", "schema.tablename",

              properties={"user": "username", "password": "password"})

    # $example off:jdbc_dataset$
实战案例
仅供参考,请确保 spark 能连接上数据库
from pyspark.sql import SparkSession

import os

# 获取 环境变量 SPARK_CLASSPATH, 当然需要你事先设定了 该变量

# 如果没有设定 SPARK_CLASSPATH, 得到 后面的值 /usr/lib/spark/jars/*

sparkClassPath = os.getenv('SPARK_CLASSPATH', '/usr/lib/spark/jars/*')

### 创建 sparkSession

# spark.driver.extraClassPath 设定了 jdbc 驱动的路径

spark = SparkSession \

    .builder \

    .appName("Python Spark SQL basic example") \

    .master("local") \

    .config("spark.driver.extraClassPath", sparkClassPath) \

    .getOrCreate()

### 连接数据库并读取表

# airDF 已经是个 DataFrame

airDF = spark.read \

    .format("jdbc") \

    .option("url", "jdbc:postgresql://172.16.89.80:5432/postgres") \

    .option("driver", "org.postgresql.Driver") \

    .option("dbtable", "road_point002") \

    .option("user", "postgres") \

    .option("password", "postgres") \

    .load()

### 打印schema

airDF.printSchema()     # df 的表结构,我们看到的就是 列名即格式等

### 只打印前20条 -- dsl 方式

airDF.select('id', 'road_number', 'speed_t').show() # id, road_number, speed_t 列名

### 把 df 转成 table -- sql 方式

def func(x):

    print(x)

airDF.registerTempTable('pg')

spark.sql("select * from pg limit 20").foreach(func)

### 存储为 RDBMS、xml、json等格式

## 存到数据库

airDF.write.jdbc("jdbc:postgresql://172.16.89.80:5432/postgres" ,

                 table = "test",mode="append", properties={"user": "postgres", "password": "postgres"})       # 写入数据库

## 存为 json

airDF.write.format('json').save('jsoin_path')       # 存入分区文件

airDF.coalesce(1).write.format('json').save('filtered.json')  # 存入单个文件,不建议使用
spark教程(九)-操作数据库的更多相关文章
- Python教程:操作数据库,MySql的安装详解
各位志同道合的同仁请点击上方关注 本教程是基于Python语言的深入学习.本次主要介绍MySql数据库软件的安装.不限制语言语法,对MySql数据库安装有疑惑的各位同仁都可以查看一下. 如想查看学习P ...
- Spring Boot教程(二十九)使用JdbcTemplate操作数据库
使用JdbcTemplate操作数据库 Spring的JdbcTemplate是自动配置的,你可以直接使用@Autowired来注入到你自己的bean中来使用. 举例:我们在创建User表,包含属性n ...
- Spark Streaming通过JDBC操作数据库
本文记录了学习使用Spark Streaming通过JDBC操作数据库的过程,源数据从Kafka中读取. Kafka从0.10版本提供了一种新的消费者API,和0.8不同,因此Spark Stream ...
- HelloDjango 系列教程:第 04 篇:Django 迁移、操作数据库
文中涉及的示例代码,已同步更新到 HelloGitHub-Team 仓库 我们已经编写了博客数据库模型的代码,但那还只是 Python 代码而已,django 还没有把它翻译成数据库语言,因此实际上这 ...
- Python学习(二十九)—— pymysql操作数据库优化
转载自:http://www.cnblogs.com/liwenzhou/articles/8283687.html 我们之前使用pymysql操作数据库的操作都是写死在视图函数中的,并且很多都是重复 ...
- python3入门教程(二)操作数据库(一)
概述 最近在准备写一个爬虫的练手项目,基本想法是把某新闻网站的内容分类爬取下来,保存至数据库,再通过接口对外输出(提供后台查询接口).那么问题就来了,python到底是怎么去操作数据库的呢?我们今天就 ...
- Android学习之基础知识九 — 数据存储(持久化技术)之使用LitePal操作数据库
上一节学习了使用SQLiteDatabase来操作SQLite数据库的方法,接下来我们开始接触第一个开源库:LitePal.LitePal是一款开源的Android数据库框架,它采用了对象关系映射(O ...
- 使用JdbcTemplate操作数据库(二十九)
使用JdbcTemplate操作数据库 Spring的JdbcTemplate是自动配置的,你可以直接使用@Autowired来注入到你自己的bean中来使用. 举例:我们在创建User表,包含属性n ...
- 第二百八十九节,MySQL数据库-ORM之sqlalchemy模块操作数据库
MySQL数据库-ORM之sqlalchemy模块操作数据库 sqlalchemy第三方模块 sqlalchemysqlalchemy是Python编程语言下的一款ORM框架,该框架建立在数据库API ...
随机推荐
- Word文档怎么从第二页加页码
1.首先将光标放到首页的最后位置 2.“页面布局”—“分隔符”—“下一页” 3.“插入”—“页码”—选一种样式的页码 4.将光标定位到第二页的页脚处,“设计”—取消“链接到前一条页眉” 5.将第二页的 ...
- TCP输入 之 tcp_data_queue
tcp_data_queue作用为数据段的接收处理,其中分为多种情况: (1) 无数据,释放skb,返回: (2) 预期接收的数据段,a. 进行0窗口判断:b. 进程上下文,复制数据到用户空间:c. ...
- [学习笔记] Tangent Distance
Tangent Distance 简介 切空间距离可以用在KNN方法中度量距离,其解决的是图像经过有限变换之后还能否被分类正确,例如.对一张数字为5的手写数字图片,将其膨胀后得到图像p1,此时KNN还 ...
- Win10怎样显示此电脑
1.在桌面空白处右击鼠标,在出现的选项框中选择“个性化”按钮: 2.在打开的页面中选择左侧的“主题”选项,在右侧选择“桌面图标设置”: 3.在弹出的小窗口中勾选“计算机”,点击“确定”,回到桌面即有此 ...
- 操作系统-Windows:UWP(Universal Windows Platform)
ylbtech-操作系统-Windows:UWP(Universal Windows Platform) 1.返回顶部 1. UWP即Windows 10中的Universal Windows Pla ...
- 使用谷歌提供的SwipeRefreshLayout下拉控件进行下拉刷新的实现数据的刷新
package com.loaderman.swiperefreshdemo; import android.os.Bundle; import android.os.Handler; import ...
- CentOS6.8安装Oracle11g
===== 这中间还有很多细节问题该文档中并没有说明和指出: 1.如/tmp目录必须单独分出来,不然oracle在以后的使用中会逐渐变慢 2.官网说的512M内存即可,这里纠正下,如果只是测试安装那还 ...
- AES256位加密
目录 1. 算法简介 2. 算法流程 2.1 扩展密钥 2.2 轮密钥加 2.3 字节代替 2.4 行位移 2.5 列混淆 3. 总结 附录A 运算示例 1.算法简介高级加密标准(英 ...
- 使用URLOS 五分钟安装rTorrent (轻量级优秀BT/PT客户端)
rTorrent是一个非常简洁.优秀.非常轻量的BT客户端,它使用ncurses库以C++编写,将 rTorrent 用在安装有 GNU Screen 和 Secure Shell 的低端系统上作为远 ...
- TensorFlow实战第八课(卷积神经网络CNN)
首先我们来简单的了解一下什么是卷积神经网路(Convolutional Neural Network) 卷积神经网络是近些年逐步兴起的一种人工神经网络结构, 因为利用卷积神经网络在图像和语音识别方面能 ...