
(二) Keras 非线性回归
视频学习来源
https://www.bilibili.com/video/av40787141?from=search&seid=17003307842787199553
笔记
Keras 非线性回归
import keras

import numpy as np

import matplotlib.pyplot as plt

#Sequential按序列构成的模型

from keras.models import Sequential

#Dense全连接层

from keras.layers import Dense
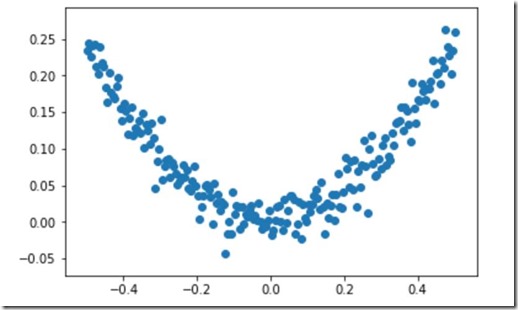
#使用numpy生成200个随机点

x_data=np.linspace(-0.5,0.5,200)  #均匀分布

noise=np.random.normal(0,0.02,x_data.shape)  #均值为0,方差为0.02

y_data=np.square(x_data)+noise

#显示随机点

plt.scatter(x_data,y_data)

plt.show()
#构建一个顺序模型

model=Sequential()

#在模型中添加一个全连接层

model.add(Dense(units=1,input_dim=1))

#sgd:stochastic gradient descent 随机梯度下降算法

#mse:mean square error 均方误差

model.compile(optimizer='sgd',loss='mse')

#训练3000次

for step in range(3000):

    #每次训练一个批次

    cost=model.train_on_batch(x_data,y_data)

    #每500个batch打印一次cost值

    if step%500==0:

        print('cost:',cost)

#x_data输入网络中,得到预测值y_pred

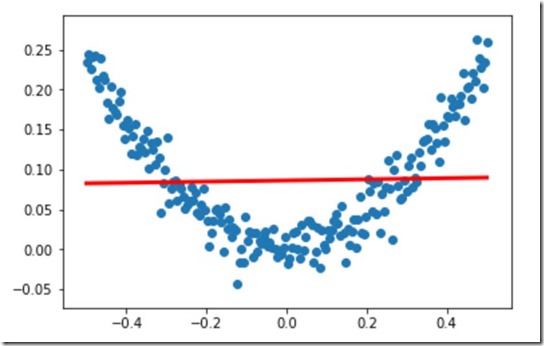
y_pred=model.predict(x_data)

#显示随机点

plt.scatter(x_data,y_data)

#显示预测结果

plt.plot(x_data,y_pred,'r-',lw=3)

plt.show()
cost: 0.018438313
cost: 0.006655791
cost: 0.0058503654
cost: 0.0057009794
cost: 0.0056732716
cost: 0.005668133
加入隐藏层
#导入SGD,(后面要修改SGD的值)

from keras.optimizers import SGD
#构建一个顺序模型

model=Sequential()

#在模型中添加  1-10-1  ,一个输入,一个输出,中间10个隐藏层

model.add(Dense(units=10,input_dim=1))   #1-10部分

model.add(Dense(units=1)) #10-1部分 等效 model.add(Dense(units=1,input_dim=10))

#增大sgd算法的学习率,默认值为0.01,

#查看函数默认值可在jupyter中shift+Tab+Tab,前提是已经导入

sgd=SGD(lr=0.3)   #学习速率0.3

#sgd:stochastic gradient descent 随机梯度下降算法

#mse:mean square error 均方误差

model.compile(optimizer=sgd,loss='mse')   #和上面不同的是没有引号

#训练3000次

for step in range(3000):

    #每次训练一个批次

    cost=model.train_on_batch(x_data,y_data)

    #每500个batch打印一次cost值

    if step%500==0:

        print('cost:',cost)

#x_data输入网络中,得到预测值y_pred

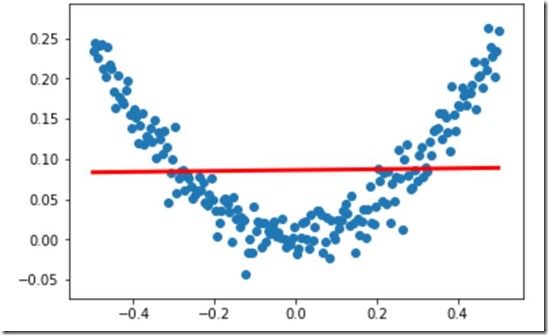
y_pred=model.predict(x_data)

#显示随机点

plt.scatter(x_data,y_data)

#显示预测结果

plt.plot(x_data,y_pred,'r-',lw=3)

plt.show()
cost: 0.1012776
cost: 0.005666962
cost: 0.005666963
cost: 0.0056669624
cost: 0.005666963
cost: 0.005666963
设置激活函数
#设置激活函数,默认的激活函数为none也就是输入=输出,线性

from keras.layers import Dense,Activation
#设置激活函数方式1

#激活函数为tanh

#构建一个顺序模型

model=Sequential()

#在模型中添加  1-10-1  ,一个输入,一个输出,中间10个隐藏层

model.add(Dense(units=10,input_dim=1))   #1-10部分

model.add(Activation('tanh'))  #双曲正切函数

model.add(Dense(units=1)) #10-1部分 等效 model.add(Dense(units=1,input_dim=10))

model.add(Activation('tanh'))  #双曲正切函数

#增大sgd算法的学习率,默认值为0.01,

#查看函数默认值可在jupyter中shift+Tab+Tab,前提是已经导入

sgd=SGD(lr=0.3)   #学习速率0.3

#sgd:stochastic gradient descent 随机梯度下降算法

#mse:mean square error 均方误差

model.compile(optimizer=sgd,loss='mse')   #和上面不同的是没有引号

#训练3000次

for step in range(3000):

    #每次训练一个批次

    cost=model.train_on_batch(x_data,y_data)

    #每500个batch打印一次cost值

    if step%500==0:

        print('cost:',cost)

#x_data输入网络中,得到预测值y_pred

y_pred=model.predict(x_data)

#显示随机点

plt.scatter(x_data,y_data)

#显示预测结果

plt.plot(x_data,y_pred,'r-',lw=3)

plt.show()
cost: 0.049393196
cost: 0.003914159
cost: 0.0011130853
cost: 0.00090270495
cost: 0.00040989672
cost: 0.00045533947

#设置激活函数方式2

#激活函数为relu

#jupyter中 注释为 ctrl+/

#构建一个顺序模型

model=Sequential()

#在模型中添加  1-10-1  ,一个输入,一个输出,中间10个隐藏层

model.add(Dense(units=10,input_dim=1,activation='relu'))   #1-10部分

model.add(Dense(units=1,activation='relu'))#10-1部分 等效 model.add(Dense(units=1,input_dim=10))

#增大sgd算法的学习率,默认值为0.01,

#查看函数默认值可在jupyter中shift+Tab+Tab,前提是已经导入

sgd=SGD(lr=0.3)   #学习速率0.3

#sgd:stochastic gradient descent 随机梯度下降算法

#mse:mean square error 均方误差

model.compile(optimizer=sgd,loss='mse')   #和上面不同的是没有引号

#训练3000次

for step in range(3000):

    #每次训练一个批次

    cost=model.train_on_batch(x_data,y_data)

    #每500个batch打印一次cost值

    if step%500==0:

        print('cost:',cost)

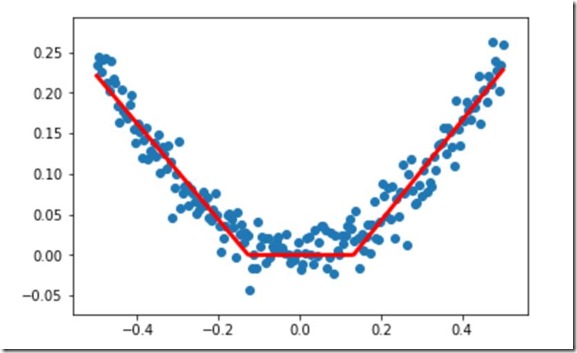
#x_data输入网络中,得到预测值y_pred

y_pred=model.predict(x_data)

#显示随机点

plt.scatter(x_data,y_data)

#显示预测结果

plt.plot(x_data,y_pred,'r-',lw=3)

plt.show()
cost: 0.0066929995
cost: 0.0004892901
cost: 0.00047061846
cost: 0.00046780292
cost: 0.00046706214
cost: 0.00046700903
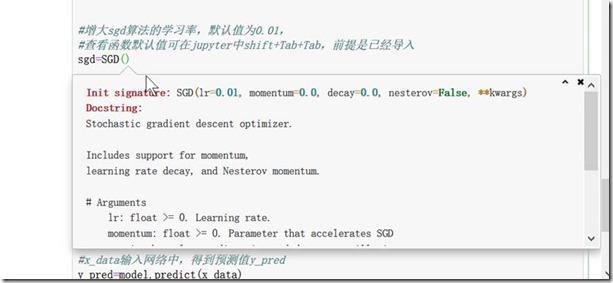
shift+Tab+Tab 效果如下
(二) Keras 非线性回归的更多相关文章
- Keras 构建DNN 对用户名检测判断是否为非法用户名(从数据预处理到模型在线预测)
一. 数据集的准备与预处理 1 . 收集dataset (大量用户名--包含正常用户名与非法用户名) 包含两个txt文件 legal_name.txt ilegal_name.txt. 如下图所 ...
- 在Keras模型中one-hot编码,Embedding层,使用预训练的词向量/处理图片
最近看了吴恩达老师的深度学习课程,又看了python深度学习这本书,对深度学习有了大概的了解,但是在实战的时候, 还是会有一些细枝末节没有完全弄懂,这篇文章就用来总结一下用keras实现深度学习算法的 ...
- 文本分类:Keras+RNN vs传统机器学习
摘要:本文通过Keras实现了一个RNN文本分类学习的案例,并详细介绍了循环神经网络原理知识及与机器学习对比. 本文分享自华为云社区<基于Keras+RNN的文本分类vs基于传统机器学习的文本分 ...
- 几个可用于数据挖掘和统计分析的java库
http://itindex.net/blog/2015/01/09/1420751820000.html WEKA:WEKA是一个可用于数据挖掘任务的机器学习算法集合.该算法可以直接应用到数据集或从 ...
- Java第三方工具库/包汇总
一.科学计算或矩阵运算库 科学计算包: JMathLib是一个用于计算复杂数学表达式并能够图形化显示计算结果的Java开源类库.它是Matlab.Octave.FreeMat.Scilab的一个克隆, ...
- 深度学习:Keras入门(二)之卷积神经网络(CNN)
说明:这篇文章需要有一些相关的基础知识,否则看起来可能比较吃力. 1.卷积与神经元 1.1 什么是卷积? 简单来说,卷积(或内积)就是一种先把对应位置相乘然后再把结果相加的运算.(具体含义或者数学公式 ...
- keras实现简单性别识别(二分类问题)
keras实现简单性别识别(二分类问题) 第一步:准备好需要的库 tensorflow 1.4.0 h5py 2.7.0 hdf5 1.8.15.1 Keras 2.0.8 opencv-p ...
- keras系列︱Application中五款已训练模型、VGG16框架(Sequential式、Model式)解读(二)
引自:http://blog.csdn.net/sinat_26917383/article/details/72859145 中文文档:http://keras-cn.readthedocs.io/ ...
- 1.keras实现-->自己训练卷积模型实现猫狗二分类(CNN)
原数据集:包含 25000张猫狗图像,两个类别各有12500 新数据集:猫.狗 (照片大小不一样) 训练集:各1000个样本 验证集:各500个样本 测试集:各500个样本 1= 狗,0= 猫 # 将 ...
随机推荐
- 国内开源社区巨作AspectCore-Framework入门
前些天和张队(善友),lemon(浩洋),斌哥(项斌)等MVP大咖一块儿吃饭,大家聊到了lemon名下的AOP这个项目,我这小白听得一脸懵逼,后面回来做了一下功课,查了下资料,在lemon的Githu ...
- Netty源码—七、内存释放
Netty本身在内存分配上支持堆内存和直接内存,我们一般选用直接内存,这也是默认的配置.所以要理解Netty内存的释放我们得先看下直接内存的释放. Java直接内存释放 我们先来看下直接内存是怎么使用 ...
- 卷积神经网络之VGG
2014年,牛津大学计算机视觉组(Visual Geometry Group)和Google DeepMind公司的研究员一起研发出了新的深度卷积神经网络:VGGNet,并取得了ILSVRC2014比 ...
- C#EF中,使用类似于SQL中的% 模糊查询
最近在做项目的时候需要使用到模糊查询,但是后台使用EF写的 而不是ADO或者是Dapper,如果是这样的话,我们就可以使用Sql语句直接进行模糊查询 现在我们需要在LINQ中使用类似于模糊查询 在EF ...
- 第12章 X.509证书库的Fluent API - IdentityModel 中文文档(v1.0.0)
存储X.509证书的常见位置是Windows X.509证书存储区.商店的原始API有点神秘(在.NET Framework和.NET Core之间也略有变化). X509类是一个简化的API从所述存 ...
- SAP HUM 锁住一个HU?
SAP HUM 锁住一个HU? 1)SAP HUM 不能锁一个已发货的HU! 如下的HU 180141205000已经发货过账, HUMO, 执行, 2)一个WHSE状态的HU就可以被锁定.比如HU ...
- Android之Lottie动画详解
文章大纲 一.Lottie介绍二.Lottie实战三.项目源码下载四.参考文章 一.Lottie介绍 1. 什么是Lottie Lottie是Android和iOS的移动库,用于解析Adobe ...
- Liunx小白须知
最近在学习Liunx,从装虚拟机到敲命令出了一些问题,95%的问题从搜索引擎都可以找到.本来想写个虚拟机安装步骤结果忘记截图了,不过没事,网上一大把.写写博文勒就是记录下自己的成长,虽然现在还是个小白 ...
- 认识音频格式-Au (NeXT/Sun)
音频格式比较多, Au音频格式是一种被sun微处理器公司发明的一种简单的音频编码格式.日后一直在NEXT系统上使用,后面就演变成了一种标准的音频编码格式.目前很多音频设备上都支持这种编码格式.这种编码 ...
- sqlserver数据库备份时出现3241问题
工作中需要将生产上的数据库备份到测试数据库一份,然后同步生产环境进行测试.但是在将数据库还原的过程中,遇到了下面的问题: 说是,介质簇结构不正确,猜测应该是sqlserver的版本不一致的问题,然后查 ...