
python爬取大众点评并写入mongodb数据库和redis数据库
抓取大众点评首页左侧信息,如图:
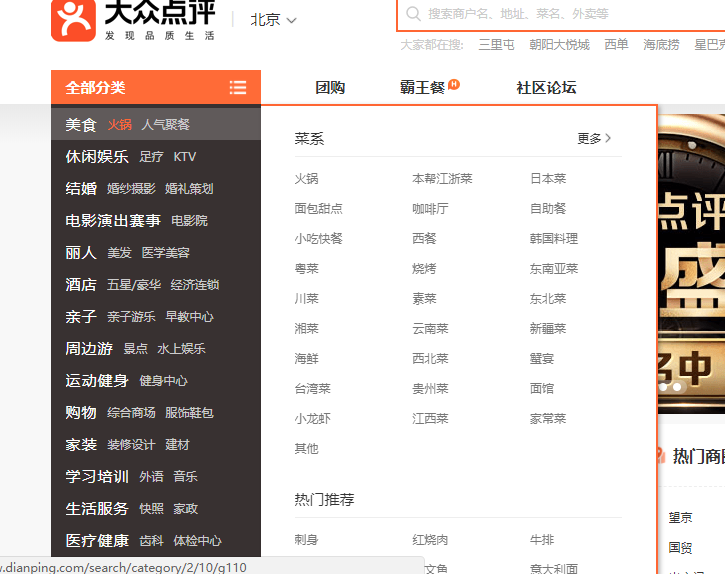
我们要实现把中文名字都存到mongodb,而每个链接存入redis数据库。
因为将数据存到mongodb时每一个信息都会有一个对应的id,那样就方便我们存入redis可以不出错。
# -*- coding: utf-8 -*-

import re

from urllib.request import urlopen

from urllib.request import Request

from bs4 import BeautifulSoup

from lxml import etree

import pymongo

client = pymongo.MongoClient(host="127.0.0.1")

db = client.dianping            #库名dianping

collection = db.classification          #表名classification

import redis        #导入redis数据库

r = redis.Redis(host='127.0.0.1', port=6379, db=0)

# client = pymongo.MongoClient(host="192.168.60.112")

# myip = client['myip']  # 给数据库命名

def secClassFind(selector, classid):

    secItems = selector.xpath('//div[@class="sec-items"]/a')

    for secItem in secItems:

        url = secItem.get('href')       #得到url

        title = secItem.text

        classid = collection.insert({'classname': title, 'pid': classid})

        classurl = '%s,%s' % (classid, url) #拼串

        r.lpush('classurl', classurl)   #入库

def Public(url):

    headers = {'User-Agent': 'Mozilla/5.0 (Windows; U; Windows NT 6.1; en-US; rv:1.9.1.6) Gecko/20091201 Firefox/3.5.6'}    #协议头

    req_timeout = 5

    req = Request(url=url, headers=headers)

    f = urlopen(req, None, req_timeout)

    s = f.read()

    s = s.decode("utf-8")

    # beautifulsoup提取

    soup = BeautifulSoup(s, 'html.parser')

    links = soup.find_all(name='li', class_="first-item")

    for link in links:

        selector = etree.HTML(str(link))

        # indexTitleUrls = selector.xpath('//a[@class="index-title"]/@href')

        # # 获取一级类别url和title

        # for titleurl in indexTitleUrls:

        #     print(titleurl)

        indexTitles = selector.xpath('//a[@class="index-title"]/text()')

        for title in indexTitles:

            # 第二级url

            print(title)

            classid = collection.insert({'classname': title, 'pid': None})

            secClassFind(selector, classid)

            print('---------')

        # secItems = selector.xpath('//div[@class="sec-items"]/a')

        # for secItem in secItems:

        #     print(secItem.get('href'))

        #     print(secItem.text)

        print('-----------------------------')

        #

        # myip.collection.insert({'name':secItem.text})

        # r.lpush('mylist', secItem.get('href'))

        # collection.find_one({'_id': ObjectId('5a14c8916d123842bcea5835')})  # connection = pymongo.MongoClient(host="192.168.60.112")  # 连接MongDB数据库

# post_info = connection.myip  # 指定数据库名称(yande_test),没有则创建

# post_sub = post_info.test  # 获取集合名:test

Public('http://www.dianping.com/')
python爬取大众点评并写入mongodb数据库和redis数据库的更多相关文章
- python爬取大众点评
拖了好久的代码 1.首先进入页面确定自己要抓取的数据(我们要抓取的是左侧分类栏-----包括美食.火锅)先爬取第一级分类(美食.婚纱摄影.电影),之后根据第一级链接爬取第二层(火锅).要注意第二级的p ...
- Python 爬取大众点评 50 页数据,最好吃的成都火锅竟是它!
前言 文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者: 胡萝卜酱 PS:如有需要Python学习资料的小伙伴可以加点击下方链 ...
- 用Python爬取大众点评数据,推荐火锅店里最受欢迎的食品
前言 文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者:有趣的Python PS:如有需要Python学习资料的小伙伴可以加点 ...
- python爬虫实战---爬取大众点评评论
python爬虫实战—爬取大众点评评论(加密字体) 1.首先打开一个店铺找到评论 很多人学习python,不知道从何学起.很多人学习python,掌握了基本语法过后,不知道在哪里寻找案例上手.很多已经 ...
- python爬虫爬取大众点评并导入redis
直接上代码,导入redis的中文编码没有解决,日后解决了会第一时间上代码!新手上路,多多包涵! # -*- coding: utf-8 -*- import re import requests fr ...
- python 爬取段子网段子写入文件
import requests import re 进入网址 for i in range(1,5): page_url = requests.get(f"http://duanziwang ...
- 利用Python爬取豆瓣电影
目标:使用Python爬取豆瓣电影并保存MongoDB数据库中 我们先来看一下通过浏览器的方式来筛选某些特定的电影: 我们把URL来复制出来分析分析: https://movie.douban.com ...
- Python爬取豆瓣音乐存储MongoDB数据库(Python爬虫实战1)
1. 爬虫设计的技术 1)数据获取,通过http获取网站的数据,如urllib,urllib2,requests等模块: 2)数据提取,将web站点所获取的数据进行处理,获取所需要的数据,常使用的技 ...
- Python:将爬取的网页数据写入Excel文件中
Python:将爬取的网页数据写入Excel文件中 通过网络爬虫爬取信息后,我们一般是将内容存入txt文件或者数据库中,也可以写入Excel文件中,这里介绍关于使用Excel文件保存爬取到的网页数据的 ...
随机推荐
- poj 3431 Expedition 优先队列
poj 3431 Expedition 优先队列 题目链接: http://poj.org/problem?id=2431 思路: 优先队列.对于一段能够达到的距离,优先选择其中能够加油最多的站点,这 ...
- 高精速撸project A*B
啊这个乘法我真的想不起来了 所以我跑去看了之前交的代码 那个时候的我真纯真啊,用cin cout都不关同步的 哪像现在,随手先写个inline void in(),能getchar()就不scanf, ...
- 防止UI穿透操作到游戏场景
#if UNITY_EDITOR || UNITY_STANDALONE_WIN if (EventSystem.current.IsPointerOverGameObject()) { return ...
- Django模型中value函数运用
values(*fields) 这个方法返回的是ValuesQuerySet,是QuerySet 的子类,也就是说,你可以用QuerySet里的方法. 需要注意的是,返回的不是list,不要直接当li ...
- Linux安装Nginx以及简单理解
1.Nginx简单介绍 ①.Nginx:一个高性能的HTTP和反向代理服务器,高并发处理很不错. ②.反向代理:在计算机世界里,由于单个服务器的处理客户端(用户)请求能力有一个极限,当用户的接入请求蜂 ...
- 黑马day16 jquery&属性过滤选择器
属性过滤选择器的过滤规则是通过元素的属性来获取对应的元素 .[attribute] 使用方法: $("div[id]") ; 返回值 集合元素 说明:匹配包括给定属性的元素.样 ...
- UVA 10465 Homer Simpson(全然背包: 二维目标条件)
UVA 10465 Homer Simpson(全然背包: 二维目标条件) http://uva.onlinejudge.org/index.php? option=com_onlinejudge&a ...
- python内置函数(四)
python内部提供了非常多内建函数. 以下让我们从a-z開始学习python的内建函数 1.1 id(object) 返回对象的id(身份),返回的这个是一个整数(integer)是唯一的,在这个对 ...
- tiny210(s5pv210)移植u-boot(基于 2014.4 版本号)——NAND 8位硬件ECC
这节我们实现nand的ecc,保存环境变量到nand flash 中.然后把我们之前的led灯烧写到nand flash 中.开机启动.在 tiny210.h 中定义宏 CONFIG_S5PV210_ ...
- Vue深度学习(6)- 组件
使用组件 在Vue中,可以用 Vue.extend() 创建一个组件构造器: var MyComponent = Vue.extend({ template:'..........' //选项 }) ...