
Python3分析sitemap.xml抓取导出全站链接
最近网站从HTTPS转为HTTP,更换了网址,旧网址做了301重定向,折腾有点大,于是在百度站长平台提交网址,不管是主动推送还是手动提交,前提都是要整理网站的链接,手动添加太麻烦,效率低,于是就想写个脚本直接抓取全站链接并导出,本文就和大家一起分享如何使用python3实现抓取链接导出。
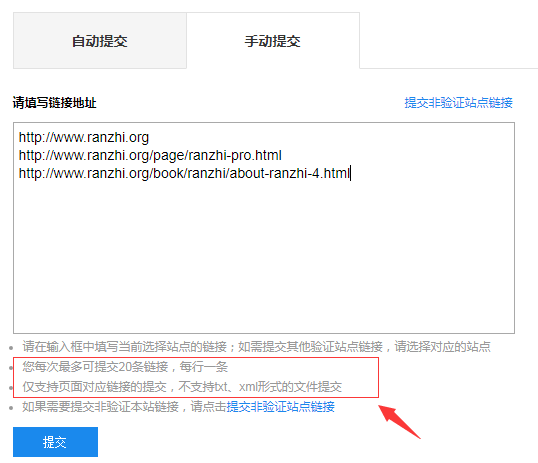
首先网站要有网站地图sitemap.xml文件地址,其次我这里用的是python3版本,如果你的环境是python2,需要对代码进行调整,因为python2和python3很多地方差别还是挺大的。
下面是python 3代码,将里面的链接地址换成你自己的网址即可:
#coding=utf-8

import urllib

import urllib.request import re

url='http://www.ranzhi.org/sitemap.xml'

html=urllib.request.urlopen(url).read()

html=html.decode('utf-8')

r=re.compile(r'(http://www.ranzhi.org.*?\.html)')

big=re.findall(r,html)

for i in big:

    print(i)

    op_xml_txt=open('xml.txt','a')

    op_xml_txt.write('%s\n'%i)
我们能来看一下运行结果:
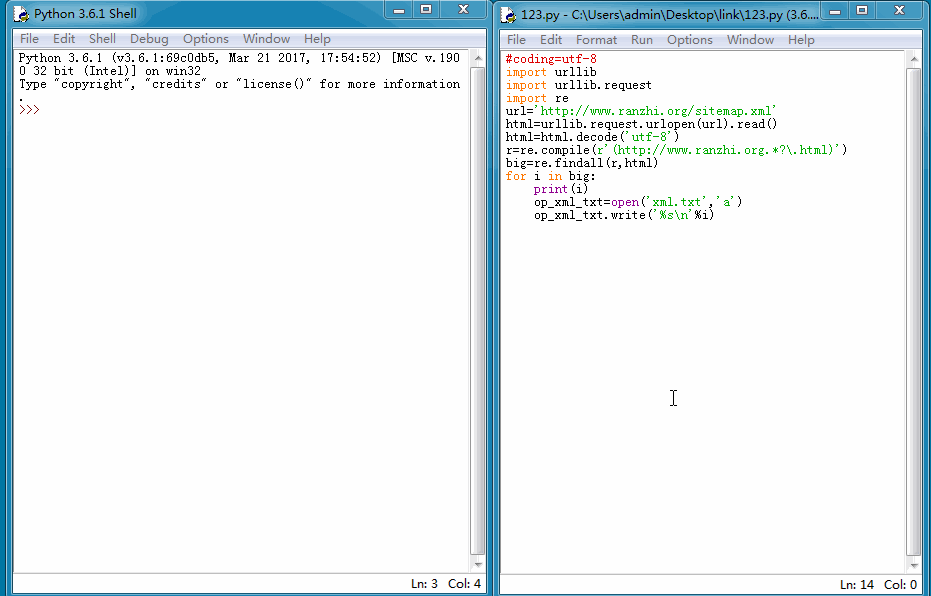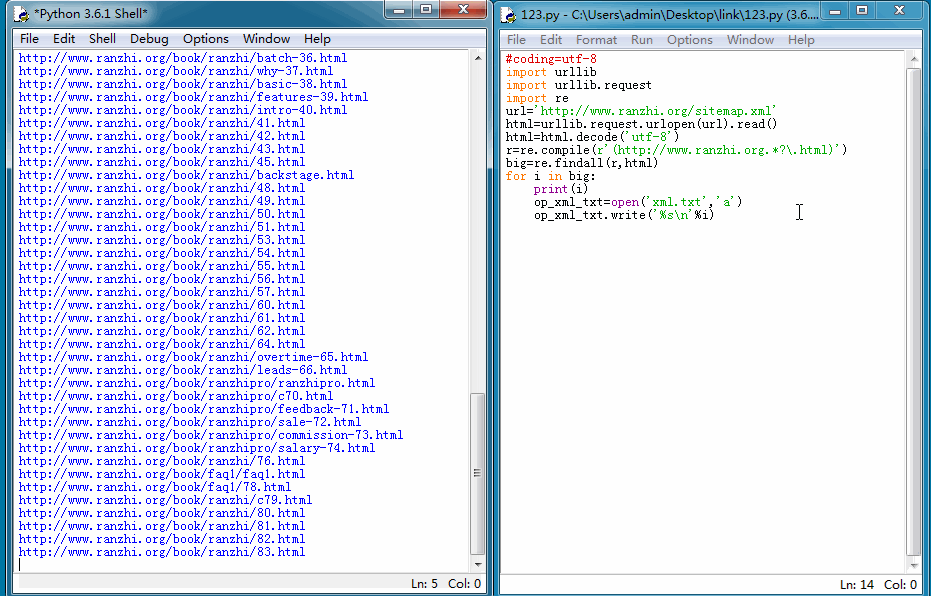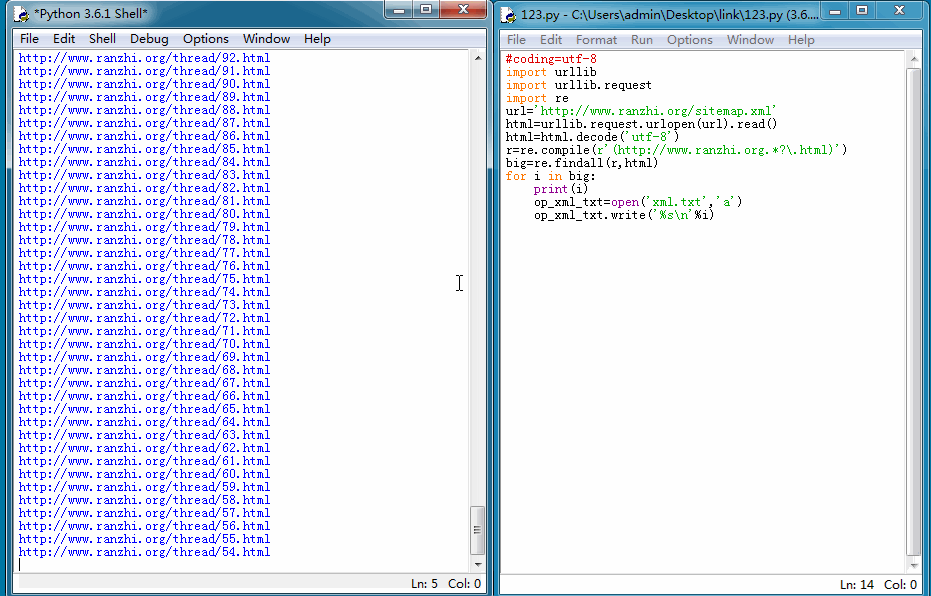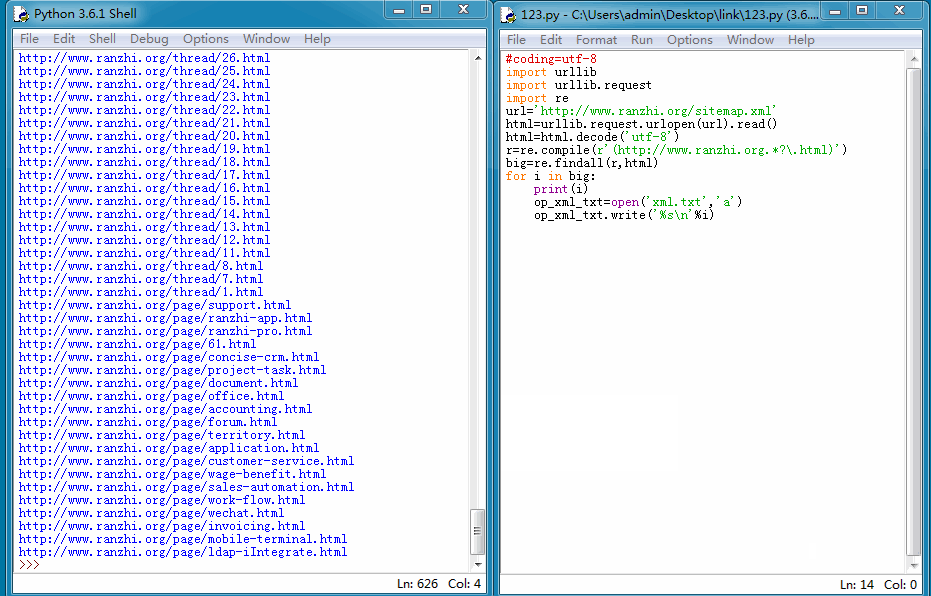
导出TXT格式文件后,再在百度站长平台手动提交就方便的多了。当然我们也可以使用更快的主动推送方式,因为我的然之网站是用PHP+mysql开发的,所以我们这里使用PHP脚本将上面抓取的链接再处理下,然后主动推送给百度,一遍加快爬虫抓取时间。
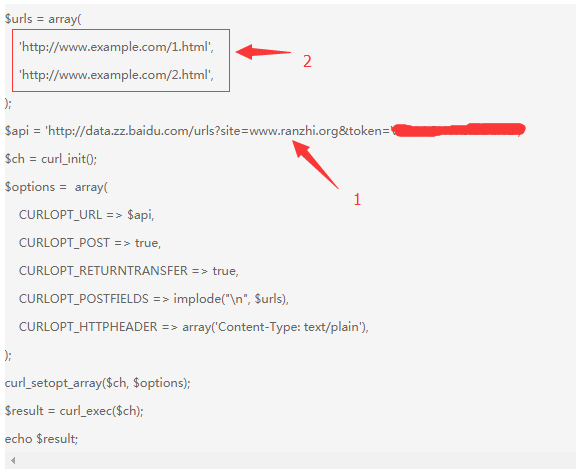
上面1是你的站点的主动推送API,这个可以在百度站长平台获取;2是要主动推送的网站地址,这里就可以用到我们上面抓取的全站链接了。将链接地址整理放到该数组中,运行一下个这个PHP脚本,就可以了。一键提交,及高效便捷,又能缩短爬虫爬去时间,有助于网站页面收录。
我们在平时的SEO或服务器运维工作中,时常会将重复工作自动化,复杂工作间变化,有助于提升效率,如果大家在操作过充中有何问题可以一起分享交流讨论。

Python3分析sitemap.xml抓取导出全站链接的更多相关文章
- python爬虫之分析Ajax请求抓取抓取今日头条街拍美图(七)
python爬虫之分析Ajax请求抓取抓取今日头条街拍美图 一.分析网站 1.进入浏览器,搜索今日头条,在搜索栏搜索街拍,然后选择图集这一栏. 2.按F12打开开发者工具,刷新网页,这时网页回弹到综合 ...
- python爬虫---实现项目(二) 分析Ajax请求抓取数据
这次我们来继续深入爬虫数据,有些网页通过请求的html代码不能直接拿到数据,我们所需的数据是通过ajax渲染到页面上去的,这次我们来看看如何分析ajax 我们这次所使用的网络库还是上一节的Reques ...
- python3 - 通过BeautifulSoup 4抓取百度百科人物相关链接
导入需要的模块 需要安装BeautifulSoup from urllib.request import urlopen, HTTPError, URLError from bs4 import Be ...
- 控制台js常用解决方案,字符串替换和抓取列表页链接
抓取列表页链接 由于测试站没有jquery所以,我用了原生的js var obj = document.getElementsByClassName('class1'); for(let i = 0; ...
- Python3利用BeautifulSoup4批量抓取站点图片的代码
边学边写代码,记录下来.这段代码用于批量抓取主站下所有子网页中符合特定尺寸要求的的图片文件,支持中断. 原理很简单:使用BeautifulSoup4分析网页,获取网页<a/>和<im ...
- 我也来学着写写WINDOWS服务-解析xml抓取数据并插入数据库
项目告一段落,快到一年时间开发了两个系统,一个客户已经在试用,一个进入客户测试阶段,中间突然被项目经理(更喜欢叫他W工)分派一个每隔两小时用windows服务去抓取客户提供的外网xml,解析该xml, ...
- 分析ajax请求抓取今日头条关键字美图
# 目标:抓取今日头条关键字美图 # 思路: # 一.分析目标站点 # 二.构造ajax请求,用requests请求到索引页的内容,正则+BeautifulSoup得到索引url # 三.对索引url ...
- Python3的requests类抓取中文页面出现乱码的解决办法
这种乱码现象基本上都是编码造成的,我们要转到我们想要的编码,先po一个知识点,嵩天老师在Python网络爬虫与信息提取说到过的:response.encoding是指从HTTP的header中猜测 ...
- python学习(26)分析ajax请求抓取今日头条cosplay小姐姐图片
分析ajax请求格式,模拟发送http请求,从而获取网页代码,进而分析取出需要的数据和图片.这里分析ajax请求,获取cosplay美女图片. 登陆今日头条,点击搜索,输入cosplay 下面查看浏览 ...
随机推荐
- Java 多线程详解(二)------如何创建进程和线程
Java 多线程详解(一)------概念的引入:http://www.cnblogs.com/ysocean/p/6882988.html 在上一篇博客中,我们已经介绍了并发和并行的区别,以及进程和 ...
- Debian系统简要说明
Debian这个是我最喜欢也是比较熟悉的一个系统了,BD下做个简要说明 一,APT以及dpkg常见用法如下:功能具体语句 软件源设置 /etc/apt/sources.list 更新软件源数据 ...
- 关于bootstrap中cropper的截图上传问题
之前做一个关于截图的东东,搞了好久终于弄好了,其主要关键是把前端截图的数据(x坐标,y坐标,宽度,高度和旋转角度)传到后台,然后在后台对图片做相关处理,记录一下方便以后查看. 后台配置为ssm. Ja ...
- 读书笔记-你不知道的JavaScript(上)
本文首发在我的个人博客:http://muyunyun.cn/ <你不知道的JavaScript>系列丛书给出了很多颠覆以往对JavaScript认知的点, 读完上卷,受益匪浅,于是对其精 ...
- lucene全文搜索之四:创建索引搜索器、6种文档搜索器实现以及搜索结果分析(结合IKAnalyzer分词器的搜索器)基于lucene5.5.3
前言: 前面几章已经很详细的讲解了如何创建索引器对索引进行增删查(没有更新操作).如何管理索引目录以及如何使用分词器,上一章讲解了如何生成索引字段和创建索引文档,并把创建的索引文档保存到索引目录,到这 ...
- 关于Dubbo分布式服务
这篇文章写的详细,可参考 http://shiyanjun.cn/archives/1075.html
- java小白进阶安卓第一天
- 快来领取一场专门讲解UTF-8与UTF-16编码算法的GitChat活动的免费名额
微信扫一扫,可打开该GitChat活动页面 字符编码是计算机世界里最基础.最重要.最令人困惑的一个主题之一.不过,在计算机教材中却往往浮光掠影般地草草带过,甚至连一本专门进行深入介绍的专著都找不到(对 ...
- linux exec操作文件描述符
linux每一个打开文件都会关联一个文件描述符,需要的时候我们可以使用exec命令指定一个大于3的数字作为文件 linux默认文件描述符 每打开一个shell就会打开默认的三个文件描述符描0,1,2, ...
- go的基本概念
go的基础结构主要由下面的几个部分组成 1:包的声明 2:引入包 3:函数 4:变量 5:语句表达式 6注释 package main import "fmt" func main ...