
Centos7完全分布式搭建Hadoop2.7.3
(一)软件准备
1,hadoop-2.7.3.tar.gz(包)
2,三台机器装有cetos7的机子
(二)安装步骤
1,给每台机子配相同的用户
进入root : su root
创建用户s: useradd s
修改用户密码:passwd s
2.关闭防火墙及修改每台机的hosts(root 下)
vim /etc/hosts 如:(三台机子都一样)
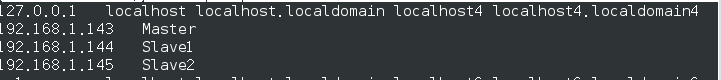
vim /etc/hostsname:如修改后参看各自的hostname



关闭防火墙:
systemctl stop firewalld.service
禁用防火墙:systemctl disable firewalld.service
查看防火墙状态firewall-cmd --state
重启 reboot
3,为每台机的用户s配置ssh,以用户s身份登录 (一定要相同的用户,因为ssh通信默认使用相同用户身份访问另一台机子)
1,root 用户下修改: vim /etc/ssh/sshd_config,设置这三项后,执行service sshd restart
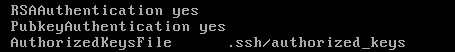
2,退出root,在用户s下操作
生成密钥对: ssh-keygen -t dsa(一路回车即可)
转入ssh目录下:cd .ssh
导入公钥: cat id_dsa.pub >> authorized_keys
修改authorized_keys权限:chmod 644
authorized_keys (修改权限,保证自己免密码能登入)
验证 ssh Master (在三台机都执行相同的操作)
3,实现master-slave免密码登录
在master 上执行: cat ~/.ssh/id_dsa.pub | ssh s@Slave1 'cat - >> ~/.ssh/authorized_keys'
cat ~/.ssh/id_dsa.pub | ssh s@Slave2 'cat - >> ~/.ssh/authorized_keys '
验证 :ssh Slave1
(三 )配置Hadoop集群
1,解压hadoop和建立文件
root用户下:tar zxvf /home/hadoop/hadoop-2.7.3.tar.gz -C /usr/
重命名:mv hadoop-2.7.3 hadoop
授权给s: chown -R s /usr/hadoop
2,创建hdfs相关文件(三台机子都需要操作)
创建存储hadoop数据文件的目录: mkdir /home/hadoopdir
存储临时文件,如pid:mkdir /home/hadoopdir/tmp
创建dfs系统使用的dfs系统名称hdfs-site.xml使用:mkdir /home/hadoopdir/dfs/name
创建dfs系统使用的数据文件hdfs-site.xml文件使用:mkdir /home/hadoopdir/dfs/data
授权给s: chown -R s /home/hadoopdir
3,配置环境变量(三台机子都需要操作)
root用户下:vim /etc/profile 添加如图: 保存退出后:source /etc/profile
验证:hadoop version(这里要修改 /usr/hadoop/etc/hadoop/hadoop-env.sh,即export JAVA_HOME=/usr/lib/jvm/jre)

4,配置hadoop文件内容
4.1 修改core-site.xml
<configuration>

       <property>

                <name>fs.defaultFS</name>

                <value>hdfs://Master:9000</value>

       </property>

       <property>

                <name>io.file.buffer.size</name>

                <value>131072</value>

        </property>

       <property>

               <name>hadoop.tmp.dir</name>

               <value>file:/home/hadoopdir/tmp/</value>

               <description>A base for other temporary   directories.</description>

       </property>

        <property>

               <name>hadoop.proxyuser.hadoop.hosts</name>

               <value>*</value>

       </property>

       <property>

               <name>hadoop.proxyuser.hadoop.groups</name>

               <value>*</value>

       </property>

</configuration>
4.2 修改hdfs-site.xml文件
<configuration>

     <property>

             <name>dfs.namenode.name.dir</name>

             <value>file:///home/hadoopdir/dfs/name</value>

       </property>

      <property>

              <name>dfs.datanode.data.dir</name>

              <value>file:///home/hadoopdir/dfs/data</value>

       </property>

       <property>

               <name>dfs.replication</name>

               <value>2</value>

        </property>

        <property>

                 <name>dfs.webhdfs.enabled</name>

                  <value>true</value>

         </property>

</configuration>
4.3 修改mapred-site.xml
<configuration>

<property>

      <name>mapreduce.framework.name</name>

          <value>yarn</value>

           </property>

          <property>

                  <name>mapreduce.jobhistory.address</name>

                  <value>Master:10020</value>

          </property>

          <property>

                <name>mapreduce.jobhistory.webapp.address</name>

                <value>Master:19888</value>

       </property>

 <property>

                <name>mapreduce.jobtracker.http.address</name>

                <value>Master:50030</value>

       </property>

 <property>

                <name>mapred.job.tracker</name>

                <value>Master:9001</value>

       </property>

</configuration>
4.4 修改 yarn-site.xml
<configuration>

<!-- Site specific YARN configuration properties -->

        <property>

               <name>yarn.nodemanager.aux-services</name>

               <value>mapreduce_shuffle</value>

        </property>

        <property>

<name>yarn.nodemanager.aux-services.mapreduce.shuffle.class</name>

               <value>org.apache.hadoop.mapred.ShuffleHandler</value>

        </property>

<property>

               <name>yarn.resourcemanager.hostname</name>

               <value>Master</value>

       </property>

        <property>

               <name>yarn.resourcemanager.address</name>

               <value>Master:8032</value>

       </property>

       <property>

               <name>yarn.resourcemanager.scheduler.address</name>

               <value>Master:8030</value>

       </property>

       <property>

            <name>yarn.resourcemanager.resource-tracker.address</name>

             <value>Master:8031</value>

      </property>

      <property>

              <name>yarn.resourcemanager.admin.address</name>

               <value>Master:8033</value>

       </property>

       <property>

               <name>yarn.resourcemanager.webapp.address</name>

               <value>Master:8088</value>

       </property>

</configuration>
4.5,修改 slaves文件

5,搭建集群(普通用户s)
格式hadoop文件:hadoop namenode -format (最后出现“util.ExitUtil: Exiting with status 0”,表示成功)
发送dfs内容给Slave1:scp -r /home/hadoopdir/dfs/* Slave1:/home/hadoopdir/dfs
发给dfs内容给Slave2:scp -r /home/hadoopdir/dfs/* Slave2:/home/hadoopdir/dfs
发送hadoop文件给数据节点:scp -r /usr/hadoop/* Slave1:/usr/hadoop/ scp -r /usr/hadoop/* Slave2:/usr/hadoop/
6,启动集群
./sbin/start-all.sh
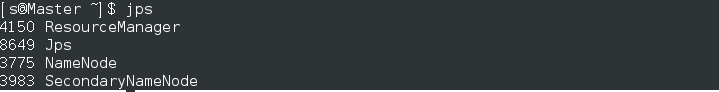
1,jps(centos 7 默认没有,可以参照这里安装)查看:Master和Slave中分别出现如下所示:

2,离开安全模式(master): hadoop dfsadmin safemode leave
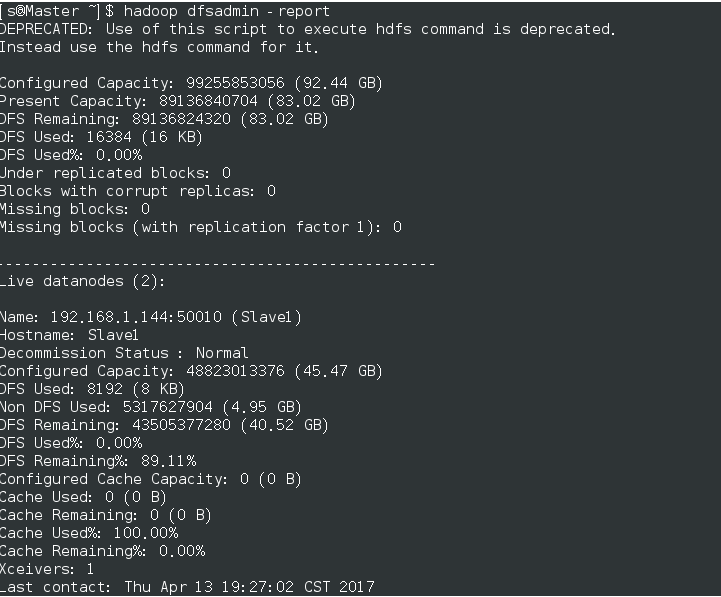
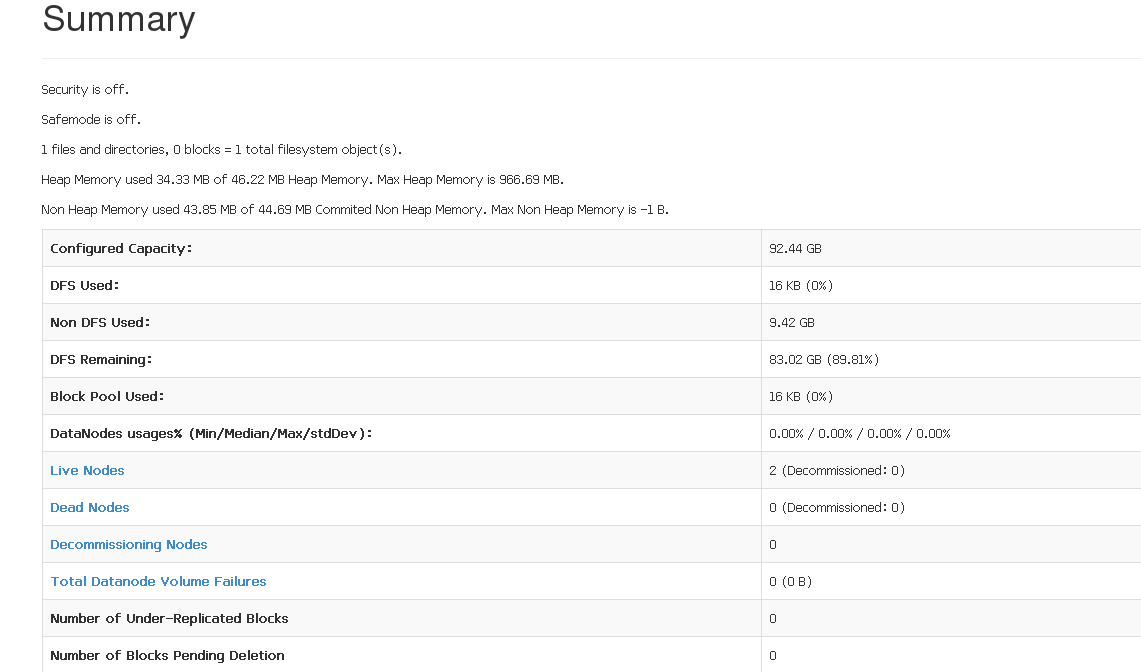
查看结果:hadoop dfsadmin -report,如图
3,登录网页查看:http://Master:50070 (查看live node) 查看yarn环境(http://Master/8088)
(四) 参考网页:
3,SSH集群搭建
Centos7完全分布式搭建Hadoop2.7.3的更多相关文章
- hbase2.1.9 centos7 完全分布式 搭建随记
hbase2.1.9 centos7 完全分布式 搭建随记 这里是当初在三个ECS节点上搭建hadoop+zookeeper+hbase+solr的主要步骤,文章内容未经过润色,请参考的同学搭配其他博 ...
- zookeeper3.5.5 centos7 完全分布式 搭建随记
zookeeper3.5.5 centos7 完全分布式 搭建随记 这里是当初在三个ECS节点上搭建hadoop+zookeeper+hbase+solr的主要步骤,文章内容未经过润色,请参考的同学搭 ...
- 大数据环境完全分布式搭建 hadoop2.4.1
(如果想要安装视频及相关软件可以博私聊我 qq 731487514) hadoop2.0已经发布了稳定版本了,增加了很多特性,比如HDFS HA.YARN等.最新的hadoop-2.4.1又增加了YA ...
- centos7搭建hadoop2.10完全分布式
本篇介绍在centos7中大家hadoop2.10完全分布式,首先准备4台机器:1台nn(namenode);3台dn(datanode) IP hostname 进程 192.168.30.141 ...
- hadoop2.8 集群 1 (伪分布式搭建)
简介: 关于完整分布式请参考: hadoop2.8 ha 集群搭建 [七台机器的集群] Hadoop:(hadoop2.8) Hadoop是一个由Apache基金会所开发的分布式系统基础架构.用户 ...
- Hadoop2.7.7 centos7 完全分布式 配置与问题随记
Hadoop2.7.7 centos7 完全分布式 配置与问题随记 这里是当初在三个ECS节点上搭建hadoop+zookeeper+hbase+solr的主要步骤,文章内容未经过润色,请参考的同学搭 ...
- Docker中自动化搭建Hadoop2.6完全分布式集群
这一节将在<Dockerfile完成Hadoop2.6的伪分布式搭建>的基础上搭建一个完全分布式的Hadoop集群. 1. 搭建集群中需要用到的文件 [root@centos-docker ...
- Dockerfile完成Hadoop2.6的伪分布式搭建
在 <Docker中搭建Hadoop-2.6单机伪分布式集群>中在容器中操作来搭建伪分布式的Hadoop集群,这一节中将主要通过Dokcerfile 来完成这项工作. 1 获取一个简单的D ...
- 32位Ubuntu12.04搭建Hadoop2.5.1完全分布式环境
准备工作 1.准备安装环境: 4台PC,均安装32位Ubuntu12.04操作系统,统一用户名和密码 交换机1台 网线5根,4根分别用于PC与交换机相连,1根网线连接交换机和实验室网口 2.使用ifc ...
随机推荐
- iOS 调试心得
修复 bug 占用我们日常开发的大部分时间,熟练的使用调试工具可以给我们节约大部分的时间. LLDB 的常用命令 expression expresion 是一个非常常用的命令,我们可以通过这个命令来 ...
- JAVA面试题和答案
本文我们将要讨论Java面试中的各种不同类型的面试题,它们可以让雇主测试应聘者的Java和通用的面向对象编程的能力.下面的章节分为上下两篇,第一篇将要讨论面向对象编程和它的特点,关于Java和它的功能 ...
- 【iOS】7.4 定位服务->2.1.1 定位 - 官方框架CoreLocation: 请求用户授权
本文并非最终版本,如果想要关注更新或更正的内容请关注文集,联系方式详见文末,如有疏忽和遗漏,欢迎指正. 本文相关目录: ================== 所属文集:[iOS]07 设备工具 === ...
- 修改Delphi 10.1.2 edit控件在android的复制、剪切和粘贴样式
Delphi 10.1.2 edit控件在android默认的复制.剪切和粘贴样式太丑,经悟能-DelphiTeacher的提示,用最简单的代码修改后稍有改观. 默认的样式: 修改后的样式: 修改FM ...
- resin远程调试配置,connection refused问题解决
http://john521.iteye.com/blog/1879805 这篇博客中讲的很好. 我在配置的过程中遇到了几个问题,记录一下: 1. 调试服务器监听的端口号,百度的开发机都限制了端口在某 ...
- 菜鸟Scrum敏捷实践系列(一)用户故事概念
菜鸟Scrum敏捷实践系列索引 菜鸟Scrum敏捷实践系列(一)用户故事概念 菜鸟Scrum敏捷实践系列(二)用户故事验收 菜鸟Scrum敏捷实践系列(三)用户故事的组织---功能架构的规划 敏捷开发 ...
- Java实现读取文章中重复出现的中文字符串
在上个星期阿里巴巴一面的时候,最后面试官问我如何把一篇文章中重复出现的词或者句子找出来,当时太紧张,答的不是很好.今天有时间再来亲手实现一遍.其实说白了也就是字符串的处理,所以难度并不是很大. 以下是 ...
- 手动编写JQUERY插件
就拿一个简单的示例来说,鼠标点击输入框,提示文字消息,鼠标移开,再显示提示文字. <script type="text/javascript"> //编写插件 (fun ...
- centos6.7搭建DHCP服务器
centos6.7搭建DHCP服务 2017-03-24 09:47:16 系统环境: centos6.7 安装之前首先使用rpm –qa | grep dhcp查看系统中是否已安装了dhcp软件包. ...
- WPF+AE开发小结--TOCControl右键菜单删除图层
1.WPF项目中添加toccontrol控件,如何添加,网上有很多方法,可自行搜索,这里不再赘述,代码如下 <Window x:Class="AE.MainWindow" x ...