
大话Spark(8)-源码之DAGScheduler
DAGScheduler的主要作用有2个:
一、把job划分成多个Stage(Stage内部并行运行,整个作业按照Stage的顺序依次执行)
二、提交任务
以下分别介绍下DAGScheduler是如何做这2件事情的,然后再跟源码看下DAGScheduler的实现。
一、如何把Job划分成多个Stage
1) 回顾下宽依赖和窄依赖
窄依赖:父RDD的每个分区只被子RDD的一个分区使用。(map,filter,union操作等)
宽依赖:父RDD的分区可能被多个子RDD的分区使用。(reduceByKey,groupByKey等)
如下图所示,左侧的算子为窄依赖, 右侧为宽依赖
 
窄依赖可以支持在同一个集群Executor上,以管道形式顺序执行多条命令,例如在执行了map后,紧接着执行filter。分区内的计算收敛,不需要依赖所有分区的数据,可以并行地在不同节点进行计算。所以它的失败回复也更有效,因为它只需要重新计算丢失的parent partition即可。最重要的是窄依赖没有shuffle过程,而宽依赖由于父RDD的分区可能被多个子RDD的分区使用,所以一定伴随着shuffle操作。
2) DAGScheduler 如何把job划分成多个Stage
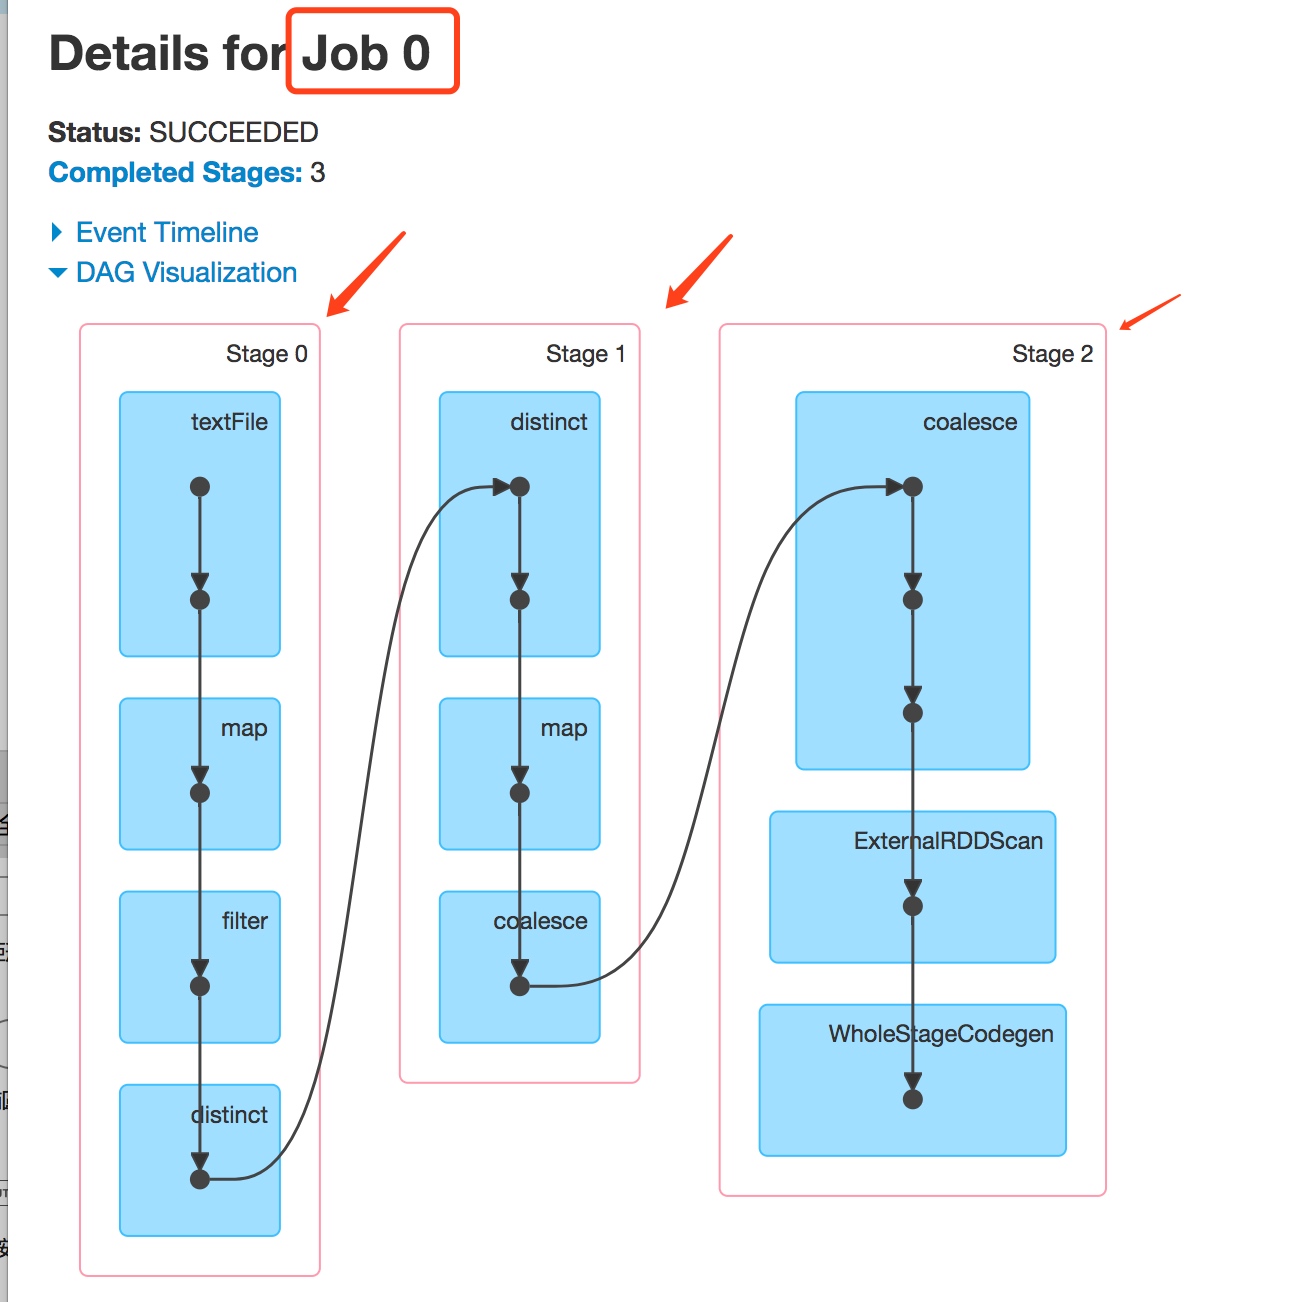
DAGScheduler会把job划分成多个Stage,如下图sparkui上的截图所示,job 0 被划分成了3个stage
DAGScheduler划分Stage的过程如下:
DAGScheduler会从触发action操作的那个RDD开始往前倒推,首先会为最后一个RDD创建一个stage,然后往前倒推的时候,如果发现对某个RDD是宽依赖(产生Shuffle),那么就会将宽依赖的那个RDD创建一个新的stage,那个RDD就是新的stage的最后一个RDD。然后依次类推,继续往前倒推,根据窄依赖或者宽依赖进行stage的划分,直到所有的RDD全部遍历完成为止。
3) wordcount的Stage划分
在前面大话spark(3)-一图深入理解WordCount程序在Spark中的执行过程中,我画过一张wordcount作业的Stage的划分的图,如下:
 
可以看出上图中,第一个stage的3个task并行执行,遇到reduceByKey这个产生shuffle的操作开始划分出新的Stage。但是其实这张图是不准确的。
其实对于每一种有shuffle的操作,比如groupByKey、reduceByKey、countByKey的底层都对应了三个RDD:MapPartitionsRDD、ShuffleRdd、MapPartitionsRDD
(宽依赖shuffle生成的rdd为ShuffleRdd)
其中Shuffle发生在第一个RDD和第二个RDD之间,前面说过如果发现对某个RDD是宽依赖(产生Shuffle),那么就会将宽依赖的那个RDD创建一个新的stage
所以说上图中 reduceByKey操作其实对应了3个RDD,其中第一个RDD会被划分到Stage1中!
4) DAGScheduler划分Stage源码
RDD类中所有的action算子触发计算都会调用sc.runjob方法, 而sc.runjob方法底层都会调用到SparkContext中的dagscheduler对象的runJob方法。
例如count这个action操作
def count(): Long = sc.runJob(this, Utils.getIteratorSize _).sum
一直追着runJob方法往底层看最终调用dagScheduler.runJob,传入调用这个方法的rdd
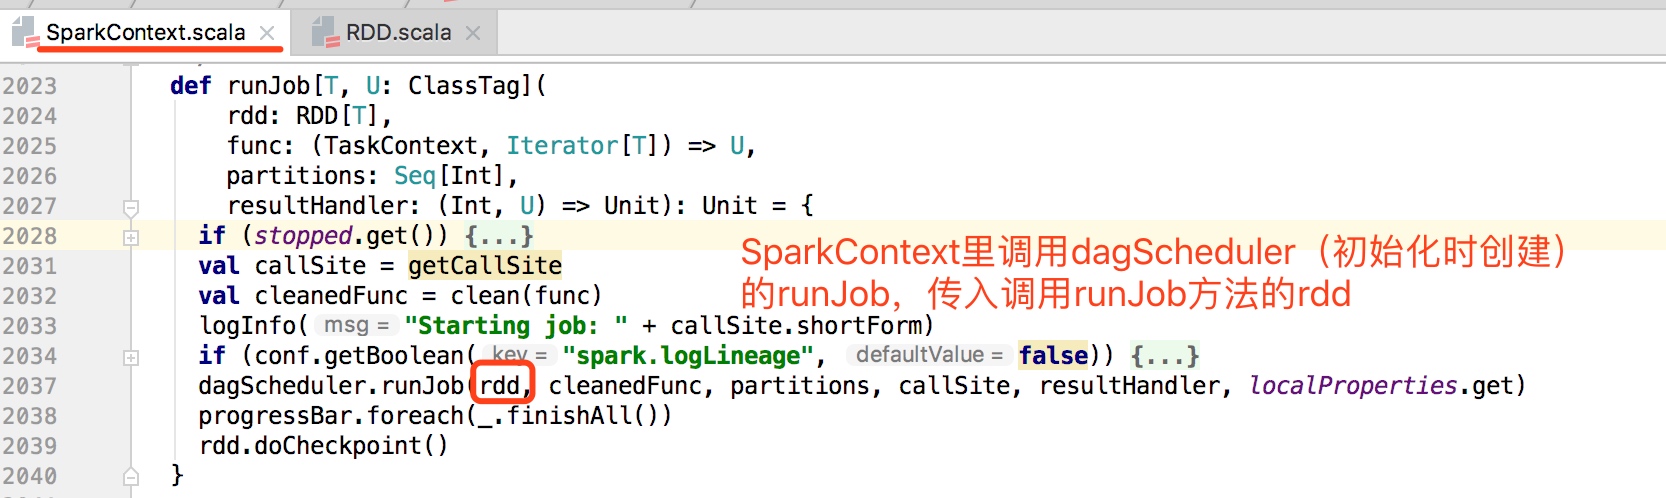 
dagScheduler.runJob内部调用submitJob提交当前的action到scheduler
submitJob内部调用DAGSchedulerEventProcessLoop发送JobSubmitted的信息,
在JobSubmitted内部最终调用dagScheduler的handleJobSubmitted(dagScheduler的核心入口)。
handleJobSubmitted方法如下:
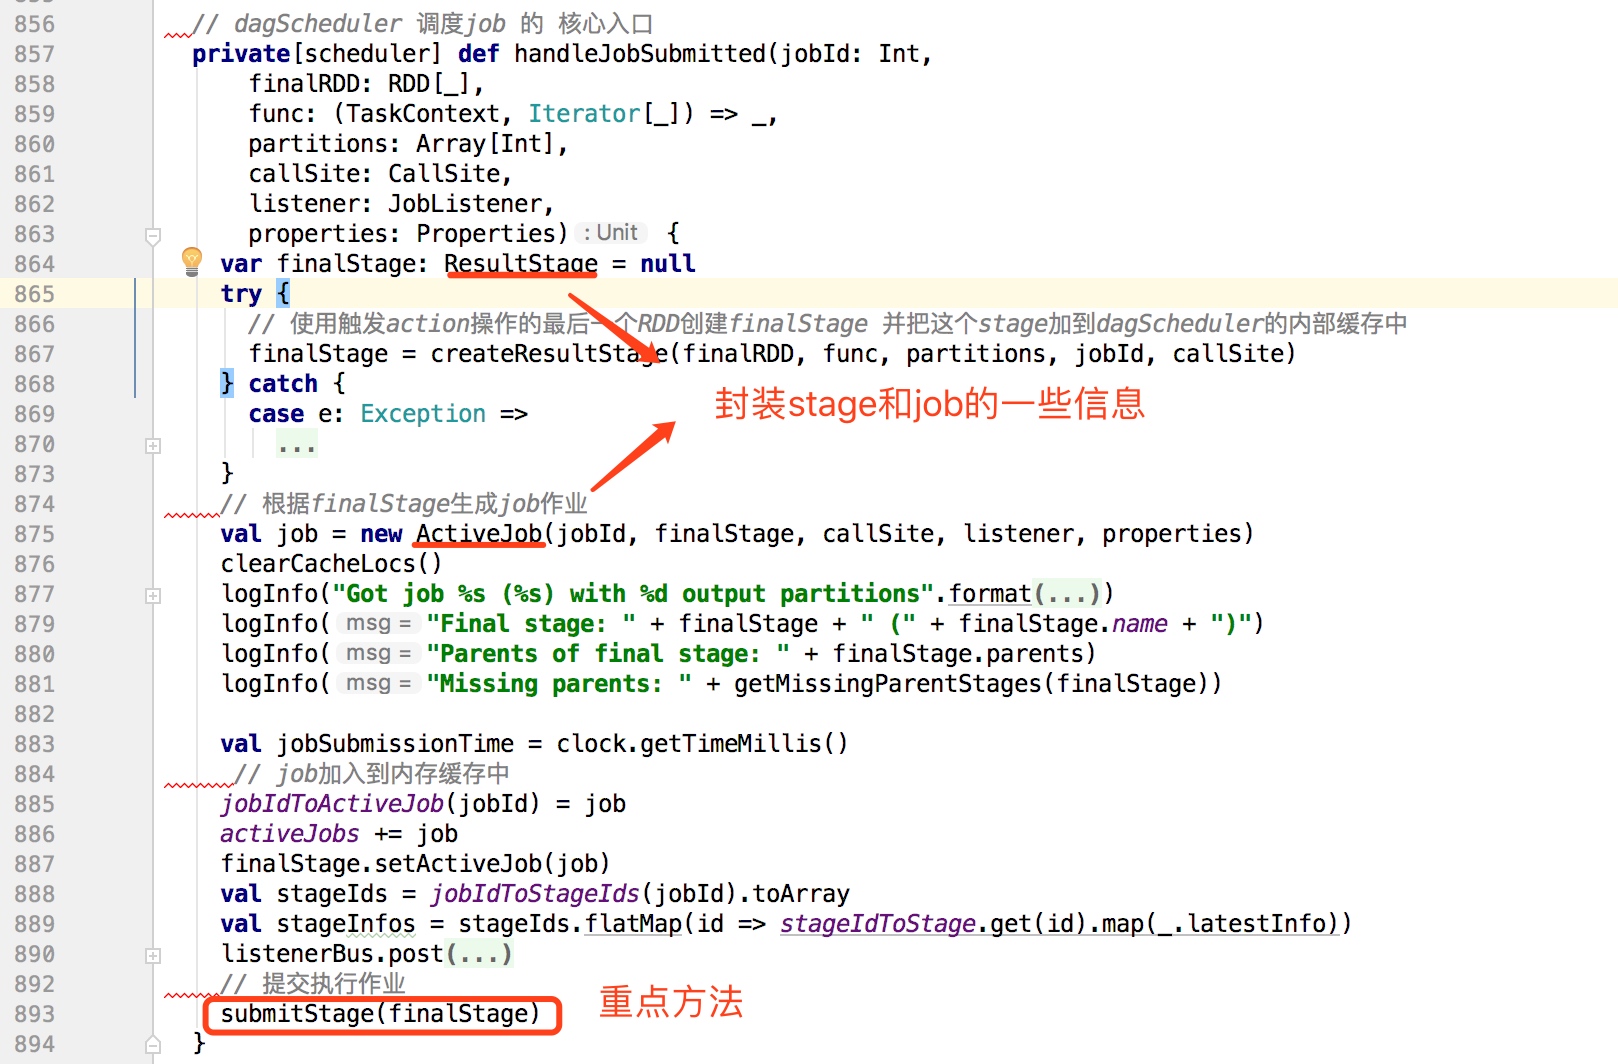 
上面代码中submitStage提交作业,其内代码如下:
 
submitStage方法中调用getMissingParentStages方法获取finalStage的父stage,
如果不存在,则使用submitMissingTasks方法提交执行;
如果存在,则把该stage放到waitingStages中,同时递归调用submitStage。通过该算法把存在父stage的stage放入waitingStages中,不存在的作为作业运行的入口。
其中最重要的getMissingParentStages中是stage划分的核心代码,如下:
 
这里就是前面说到的stage划分的方式,查看最后一个rdd的依赖,如果是窄依赖,则不创建新的stage,如果是宽依赖,则用getOrCreateShuffledMapStage方法创建新的rdd,依次往前推。
所以Stage的划分算法最核心的两个方法为submitStage何getMissingParentStage
二、提交任务
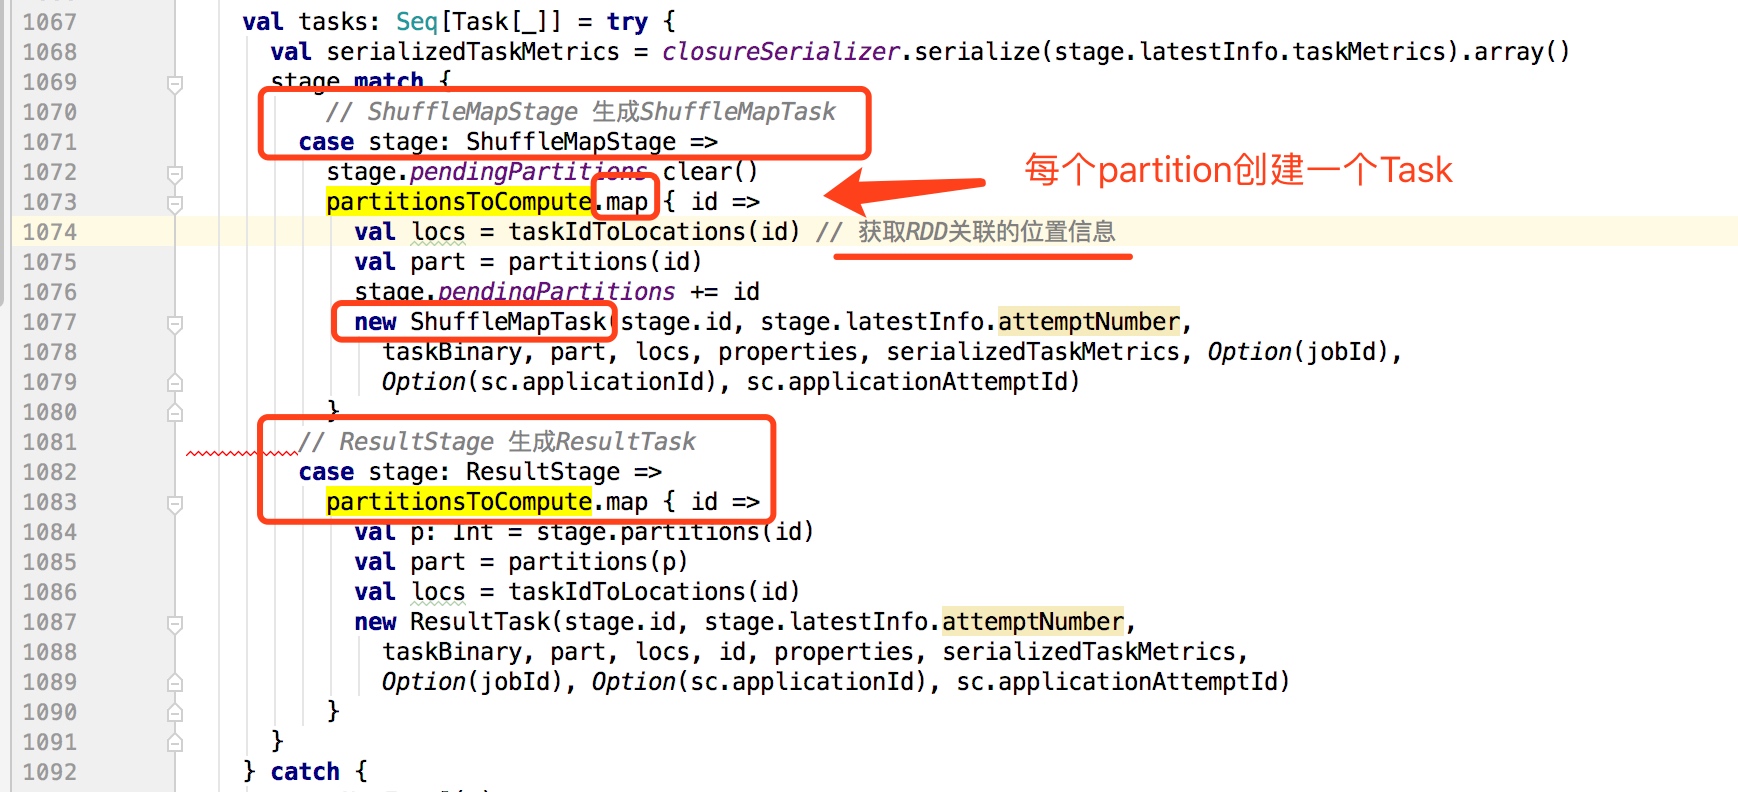
当Stage提交运行后,在DAGScheduler的submitMissingTasks方法中,会根据Stage的Partition个数拆分对应个数任务,这些任务组成一个TaskSet提交到TaskScheduler进行处理。
对于ResultStage(最后一个Stage)生成ResultTask,对于ShuffleMapStage生成ShuffleMapTask。
每一个TaskSet包含对应Stage的所有task,这些Task的处理逻辑完全一样,不同的是对应处理的数据,而这些数据是对应其数据分片的(Partition)。
submitMissingTasks如下:
 
 
大话Spark(8)-源码之DAGScheduler的更多相关文章
- 大话Spark(6)-源码之SparkContext原理剖析
SparkContext是整个spark程序通往集群的唯一通道,他是程序的起点,也是程序的终点. 我们的每一个spark个程序都需要先创建SparkContext,接着调用SparkContext的方 ...
- 大话Spark(7)-源码之Master主备切换
Master作为Spark Standalone模式中的核心,如果Master出现异常,则整个集群的运行情况和资源都无法进行管理,整个集群将处于无法工作的状态. Spark在设计的时候考虑到了这种情况 ...
- 大话Spark(9)-源码之TaskScheduler
上篇文章讲到DAGScheduler会把job划分为多个Stage,每个Stage中都会创建一批Task,然后把Task封装为TaskSet提交到TaskScheduler. 这里我们来一起看下Tas ...
- (升级版)Spark从入门到精通(Scala编程、案例实战、高级特性、Spark内核源码剖析、Hadoop高端)
本课程主要讲解目前大数据领域最热门.最火爆.最有前景的技术——Spark.在本课程中,会从浅入深,基于大量案例实战,深度剖析和讲解Spark,并且会包含完全从企业真实复杂业务需求中抽取出的案例实战.课 ...
- Spark Streaming源码解读之JobScheduler内幕实现和深度思考
本期内容 : JobScheduler内幕实现 JobScheduler深度思考 JobScheduler 是整个Spark Streaming调度的核心,需要设置多线程,一条用于接收数据不断的循环, ...
- spark最新源码下载并导入到开发环境下助推高质量代码(Scala IDEA for Eclipse和IntelliJ IDEA皆适用)(以spark2.2.0源码包为例)(图文详解)
不多说,直接上干货! 前言 其实啊,无论你是初学者还是具备了有一定spark编程经验,都需要对spark源码足够重视起来. 本人,肺腑之己见,想要成为大数据的大牛和顶尖专家,多结合源码和操练编程. ...
- 使用 IntelliJ IDEA 导入 Spark 最新源码及编译 Spark 源代码(博主强烈推荐)
前言 其实啊,无论你是初学者还是具备了有一定spark编程经验,都需要对spark源码足够重视起来. 本人,肺腑之己见,想要成为大数据的大牛和顶尖专家,多结合源码和操练编程. 准备工作 1.sca ...
- 第十一篇:Spark SQL 源码分析之 External DataSource外部数据源
上周Spark1.2刚发布,周末在家没事,把这个特性给了解一下,顺便分析下源码,看一看这个特性是如何设计及实现的. /** Spark SQL源码分析系列文章*/ (Ps: External Data ...
- 第十篇:Spark SQL 源码分析之 In-Memory Columnar Storage源码分析之 query
/** Spark SQL源码分析系列文章*/ 前面讲到了Spark SQL In-Memory Columnar Storage的存储结构是基于列存储的. 那么基于以上存储结构,我们查询cache在 ...
随机推荐
- 一个Java基础练习
今天在群里又有一个朋友问到了这样一个练习,我索性将代码贴到这里,下次须要的朋友能够来这里看. 用到知识点:数组.集合.IO流 问题描写叙述:在例如以下图所看到的的一个txt文件里读取数据到内存,然后统 ...
- VS NuGet使用
通过这个可以自动联网下载内容! 很方便! 工具->NuGet包管理工具->程序包管理器控制台
- DG应用日志相关操作
应用archive log: recover managed standby database disconnect; 应用redo logfile: recover managed stan ...
- 今日SGU 5.8
SGU 109 题意:一个n*n的矩形,起点在1,1然后每次给你一个操作,走ki步,然后你可以删除任意一个点这次步走不到的,删了就不能再走了,然后问构造这种操作,使得最后删除n*n-1个点 剩下一个点 ...
- 今日SGU 5.3
SGU 107 题意:输入一个N,表示N位数字里面有多少个的平方数的结尾9位是987654321 收获:打表,你发现相同位数的数相乘结果的最后几位,就和那两个相乘的数最后几位相乘一样,比如3416*8 ...
- Mysql学习总结(17)——MySQL数据库表设计优化
1.选择优化的数据类型 MySQL支持很多种不同的数据类型,并且选择正确的数据类型对于获得高性能至关重要.不管选择何种类型,下面的简单原则都会有助于做出更好的选择: (1).更小通常更好 一般来说,要 ...
- IIS6/7/8 WEBserver不能訪问grf报表模板文件的问题
通过 IE不能訪问到 .grf 报表文件,这是由于 IIS6/7/8对訪问的扩展名做了限制,除了已经定义的扩展名之外.其它的扩展名都不能訪问.这跟 IIS5 不一样,IIS5 对全部的扩展名都不做限制 ...
- C++的class的样例
私有就是仅仅可以通过内部调用,在类外面是不可以使用私有成员的 简单的写一个 Class A { public: //你能够通过公有的函数去訪问私有成员 Demo() //能够在这使 ...
- apache activemq Failed to bind to server socket 61616
windows环境上: 首先 nestat -ano | findstr "61616" 查看是否有进程,有的话kill掉, 若没有发现,查看windows Internet Co ...
- Android app : use html or native?
Android app可分为两种:网络(html)应用程序和原生(native)应用程序 首先,我们先来讨论下如何判断一个app是html实现还是native实现. 设置-->>开发者选项 ...