
SparkSql学习笔记(包含IDEA编写的本地代码)
Spark SQL and DataFrame
1.为什么要用Spark Sql
原来我们使用Hive,是将Hive Sql 转换成Map Reduce 然后提交到集群上去执行,大大简化了编写MapReduce的程序的复杂性,由于MapReduce这种计算模型执行效率比较慢,所以Spark Sql的应运而生,它是将SparkSql转换成RDD,然后提交到集群执行,执行效率非常的快。
Spark Sql的有点:1、易整合 2、统一的数据访问方式 3、兼容Hvie 4、标准的数据连接
2、DataFrames
什么是DataFrames?
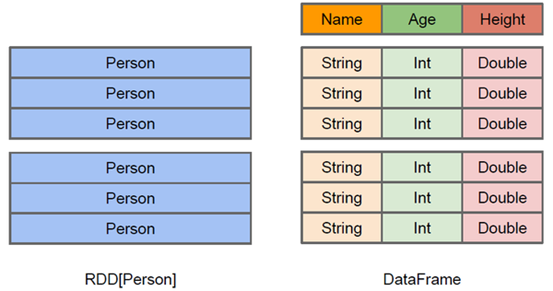
与RDD类似,DataFrames也是一个分布式数据容器,然而DataFrame更像是传统数据库的二维表格,除了数据以外,还记录数据的结构信息,即schema。同时,与Hive类似,DataFrame与支持嵌套数据类型(struct、array和map)。从API的易用性上看,DataFrame API提供的是一套高层的关系操作,比函数式的RDD API要更加友好,门槛更低。由于与R和Pandas的DataFrame类似,Spark DataFrame很好地继承了传统单机数据分析的开发体验。
创建DataFrames
在Spark SQL中SQLContext是创建DataFrames和执行SQL的入口,在spark-1。5.2中已经内置了一个sqlContext。
1.在本地创建一个文件,有三列,分别是id、name、age,用空格分隔,然后上传到hdfs上
hdfs dfs -put person.txt /
2.在spark shell执行下面命令,读取数据,将每一行的数据使用列分隔符分割
val lineRDD = sc.textFile("hdfs://hadoop01:9000/person.txt").map(_.split(" "))
3.定义case class(相当于表的schema)
case class Person(id:Int, name:String, age:Int)
4.将RDD和case class关联
val personRDD = lineRDD.map(x => Person(x(0).toInt, x(1), x(2).toInt))
5.将RDD转换成DataFrame
val personDF = personRDD.toDF
6.对DataFrame进行处理
personDF.show
代码:
object SparkSqlTest {

  def main(args: Array[String]): Unit = {

    val conf = new SparkConf().setMaster("local").setAppName("SQL-1")

    val sc = new SparkContext(conf)

    fun1(sc)

  }

  //定义case class 相当于表的schema

  case class Person(id:Int,name:String,age:Int)

  def fun1(sc:SparkContext): Unit ={

    val sqlContext = new SQLContext(sc)
  // 位置一般情况下是换成HDFS文件路径

    val lineRdd = sc.textFile("D:\\data\\person.txt").map(_.split(" "))

    val personRdd = lineRdd.map(x=>Person(x(0).toInt,x(1),x(2).toInt))

    import sqlContext.implicits._

    val personDF = personRdd.toDF

    //注册表

    personDF.registerTempTable("person_df")

    //传入sql

    val df = sqlContext.sql("select * from person_df order by age desc")

    //将结果以JSON的方式存储到指定位置

    df.write.json("D:\\data\\personOut")

    sc.stop()

  }
DataFrame 常用操作
DSL风格语法(个人理解短小精悍的含义)
     // 查看DataFrame部分列中的内容

    df.select(personDF.col("name")).show()

    df.select(col = "age").show()

    df.select("id").show()

    // 打印DataFrame的Schema信息

    df.printSchema()

    //查询所有的name 和 age ,并将 age+2

    df.select(df("id"),df("name"),df("age")+2).show()

    //查询所有年龄大于20的

    df.filter(df("age")>20).show()

    // 按年龄分组并统计相同年龄人数

    df.groupBy("age").count().show()
SQL风格语法(前提:需要将DataFrame注册成表)
//注册成表

 personDF.registerTempTable("person_df")

// 查询年龄最大的两位 并用对象接接收

    val persons = sqlContext.sql("select * from person_df order by age desc limit 2")

    persons.foreach(x=>print(x(0),x(1),x(2)))
通过StructType直接指定Schema
  /*通过StructType直接指定Schema*/

   def fun2(sc: SparkContext): Unit = {

     val sqlContext = new SQLContext(sc)

     val personRDD = sc.textFile("D:\\data\\person.txt").map(_.split(" "))

     // 通过StructType直接指定每个字段的Schema

     val schema = StructType(List(StructField("id", IntegerType, true), StructField("name", StringType, true), StructField("age", IntegerType)))

     //将rdd映射到RowRDD

     val rowRdd = personRDD.map(x=>Row(x(0).toInt,x(1).trim,x(2).toInt))

     //将schema信息应用到rowRdd上

     val dataFrame = sqlContext.createDataFrame(rowRdd,schema)

     //注册

     dataFrame.registerTempTable("person_struct")

     sqlContext.sql("select * from person_struct").show()

     sc.stop()

   }
连接数据源
 /*连接mysql数据源*/

   def fun3(sc:SparkContext): Unit ={

     val sqlContext = new SQLContext(sc)

     val jdbcDF = sqlContext.read.format("jdbc").options(Map("url"->"jdbc:mysql://192.168.180.100:3306/bigdata","driver"->"com.mysql.jdbc.Driver","dbtable"->"person","user"->"root","password"->"123456")).load()

     jdbcDF.show()

     sc.stop()

   }
再回写到数据库中
  // 写入数据库

     val personTextRdd = sc.textFile("D:\\data\\person.txt").map(_.split(" ")).map(x=>Row(x(0).toInt,x(1),x(2).toInt))

     val schema = StructType(List(StructField("id", IntegerType), StructField("name", StringType), StructField("age", IntegerType)))

     val personDataFrame = sqlContext.createDataFrame(personTextRdd,schema)

     val prop = new Properties()

     prop.put("user","root")

     prop.put("password","123456")

     //写入数据库

     personDataFrame.write.mode("append").jdbc("jdbc:mysql://192.168.180.100:3306/bigdata","bigdata.person",prop)

     sc.stop()
SparkSql学习笔记(包含IDEA编写的本地代码)的更多相关文章
- AM335x(TQ335x)学习笔记——触摸屏驱动编写
前面几篇文章已经通过配置DTS的方式完成了多个驱动的移植,接下来我们解决TQ335x的触摸驱动问题.由于种种原因,TQ335x的触摸屏驱动是以模块方式提供的,且Linux官方内核中也没有带该触摸屏的驱 ...
- SparkSQL学习笔记
概述 冠状病毒来临,宅在家中给国家做贡献之际,写一篇随笔记录SparkSQL的学习笔记,目的有二,一是记录整理之前的知识作为备忘录,二是分享技术,大家共同进步,有问题也希望大家不吝赐教.总体而言,大数 ...
- Android学习笔记(第一篇)编写第一个程序Hello World+Activity
PS:终于开始正式的搞Android了...无人带的一介菜鸟,我还是自己默默的努力吧... 学习内容: 1.编写第一个Hello World程序.. 学习Android,那么就需要有一个编译器来集 ...
- 【大数据】SparkSql学习笔记
第1章 Spark SQL概述 1.1 什么是Spark SQL Spark SQL是Spark用来处理结构化数据的一个模块,它提供了2个编程抽象:DataFrame和 DataSet,并且作为分布式 ...
- <深入理解JavaScript>学习笔记(1)_编写高质量JavaScript代码的基本要点
注:本文是拜读了 深入理解JavaScript 之后深有感悟,故做次笔记方便之后查看. JQuery是一个很强大的JavaScript 类库,在我刚刚接触JavaScript的就开始用了. JQuer ...
- ROS学习笔记三:编写第一个ROS节点程序
在编写第一个ROS节点程序之前需要创建工作空间(workspace)和功能包(package). 1 创建工作空间(workspace) 创建一个catkin_ws: #注意:如果使用sudo一次 ...
- CSS学习笔记——包含块 containing block
以下内容翻译自CSS 2.1官方文档.网址:https://www.w3.org/TR/CSS2/visudet.html#strut 有时,一个元素的盒子的位置和尺寸根据一个确定的矩形计算,这个确定 ...
- jquery学习笔记-----插件开发的编写总结
一.对jQuery对象的扩展 ;(function($){ $.fn.extend( { fun1:abc,fun2:1bc … } ) })(jQuery) 这里采用立即执行模式,即不用调用也能执 ...
- EntityFramework Core 学习笔记 —— 包含与排除属性
原文地址:https://docs.efproject.net/en/latest/modeling/included-properties.html 在模型中包含一个属性意味着 EF 拥有了这个属性 ...
随机推荐
- Surging实践经验
背景 在去年9月份的时候,我入职一家做航空软件产品的公司.当时公司部门领导决定构建一个技术平台(或称为技术中台),通过该技术平台进而孵化各个业务系统.说白了就是需要通过一个分布式框架或是微服务框架提高 ...
- Wireshark着色规则
wireshark抓包蓝色和红色 在默认情况下 蓝色适合红色相反的方向 绿色背景的是HTTP包灰色背景的是TCP包.黑色背景的是TCP错误包或者校验和错误的包 有时候wireshark抓的包还有颜色区 ...
- 【iOS】duplicate symbols for architecture x86_64
今天遇到了这个问题,错误如下: duplicate symbol _OBJC_IVAR_$_BCViewController.bank in: /Users/***/Library/Developer ...
- poj 2524 Ubiquitous Religions(简单并查集)
对与知道并查集的人来说这题太水了,裸的并查集,如果你要给别人讲述并查集可以使用这个题当做例题,代码中我使用了路径压缩,还是有一定优化作用的. #include <stdio.h> #inc ...
- JDBC连接池-C3P0连接
JDBC连接池-C3P0连接 c3p0连接池的学习英语好的看英文原版 c3p0 - JDBC3 Connection and Statement Pooling 使用c3p0连接池 三种方 ...
- Mysql的行级锁与表级锁
在计算机科学中,锁是在执行多线程时用于强行限制资源访问的同步机制,即用于在并发控制中保证对互斥要求的满足. 在DBMS中,可以按照锁的粒度把数据库锁分为行级锁(INNODB引擎).表级锁(MYISAM ...
- python基础--基于套接字进行文件传输、异常处理、socketserver模块
异常处理: 什么是异常处理: 程序在运行过程中出现了不可预知的错误,并且该错误没有对应的处理机制,那么就会以异常的形式表现出来,造成的影响就是整个程序无法再正常运行 异常的结构: 异常的类型.异常的信 ...
- JAVA jobs
Java岗位1, SpringMVC, spring, mybaits2, 高并发编程3, mysql或者oracle SQL调优及函数,存储过程,JOB调度
- spark学习(10)-RDD的介绍和常用算子
RDD(弹性分布式数据集,里面并不存储真正要计算的数据,你对RDD的操作,他会在Driver端转换成Task,下发到Executor计算分散在多台集群上的数据) RDD是一个代理,你对代理进行操作,他 ...
- HTML/CSS:图片居中(水平居中和垂直居中)
css图片居中(水平居中和垂直居中) css图片居中分css图片水平居中和垂直居中两种情况,有时候还需要图片同时水平垂直居中, 下面分几种居中情况分别介绍: css图片水平居中 1.利用margin: ...