
ZooKeeper初步
ZooKeeper 简介:
顾名思义 zookeeper 就是动物园管理员,他是用来管 hadoop(大象)、Hive(蜜蜂)、pig(小猪)的管理员, Apache Hbase 和 Apache Solr 的分布式集群都用到了 zookeeper;Zookeeper: 是一个分布式的、开源的程序协调服务,是 hadoop 项目下的一个子项目。他提供的主要功能包括:配置管理、名字服务、分布式锁、集群管理。
ZooKeeper 的作用:
在我们的应用中除了代码外,还有一些就是各种配置。比如数据库连接等。一般我们都是使用配置文件的方式,在代码中引入这些配置文件。当我们只有一种配置,只有一台服务器,并且不经常修改的时候,使用配置文件是一个很好的做法,但是如果我们配置非常多,有很多服务器都需要这个配置,这时使用配置文件就不是个好主意了。这个时候往往需要寻找一种集中管理配置的方法,我们在这个集中的地方修改了配置,所有对这个配置感兴趣的都可以获得变更。Zookeeper 就是这种服务,它使用 Zab 这种一致性协议来提供一致性。现在有很多开源项目使用 Zookeeper 来维护配置,比如在 HBase 中,客户端就是连接一个Zookeeper,获得必要的 HBase 集群的配置信息,然后才可以进一步操作。还有在开源的消息队列 Kafka 中,也使用 Zookeeper 来维护 broker 的信息。在 Alibaba 开源的 SOA 框架 Dubbo中也广泛的使用 Zookeeper 管理一些配置来实现服务治理。
名字服务 :
名字服务这个就很好理解了。比如为了通过网络访问一个系统,我们得知道对方的 IP地址,但是 IP 地址对人非常不友好,这个时候我们就需要使用域名来访问。但是计算机是不能是域名的。怎么办呢?如果我们每台机器里都备有一份域名到 IP 地址的映射,这个倒是能解决一部分问题,但是如果域名对应的 IP 发生变化了又该怎么办呢?于是我们有了DNS 这个东西。我们只需要访问一个大家熟知的(known)的点,它就会告诉你这个域名对应的 IP 是什么。在我们的应用中也会存在很多这类问题,特别是在我们的服务特别多的时候,如果我们在本地保存服务的地址的时候将非常不方便,但是如果我们只需要访问一个大家都熟知的访问点,这里提供统一的入口,那么维护起来将方便得多了。
分布式锁 :
其实在第一篇文章中已经介绍了 Zookeeper 是一个分布式协调服务。这样我们就可以利用 Zookeeper 来协调多个分布式进程之间的活动。比如在一个分布式环境中,为了提高可靠性,我们的集群的每台服务器上都部署着同样的服务。但是,一件事情如果集群中的每个服务器都进行的话,那相互之间就要协调,编程起来将非常复杂。而如果我们只让一个服务进行操作,那又存在单点。通常还有一种做法就是使用分布式锁,在某个时刻只让一个服务去干活,当这台服务出问题的时候锁释放,立即 fail over 到另外的服务。这在很多分布式系统中都是这么做,这种设计有一个更好听的名字叫 Leader Election(leader 选举)。比如 HBase 的 Master 就是采用这种机制。但要注意的是分布式锁跟同一个进程的锁还是有区别的,所以使用的时候要比同一个进程里的锁更谨慎的使用。
集群管理:
在分布式的集群中,经常会由于各种原因,比如硬件故障,软件故障,网络问题,有些节点会进进出出。有新的节点加入进来,也有老的节点退出集群。这个时候,集群中其他机器需要感知到这种变化,然后根据这种变化做出对应的决策。比如我们是一个分布式存储系统,有一个中央控制节点负责存储的分配,当有新的存储进来的时候我们要根据现在集群目前的状态来分配存储节点。这个时候我们就需要动态感知到集群目前的状态。还有,比如一个分布式的 SOA 架构中,服务是一个集群提供的,当消费者访问某个服务时,就需要采用某种机制发现现在有哪些节点可以提供该服务(这也称之为服务发现,比如 Alibaba 开源的SOA 框架 Dubbo 就采用了 Zookeeper 作为服务发现的底层机制)。还有开源的 Kafka 队列就采用了 Zookeeper 作为 Cosnumer 的上下线管理。
Zookeeper 的存储结构:
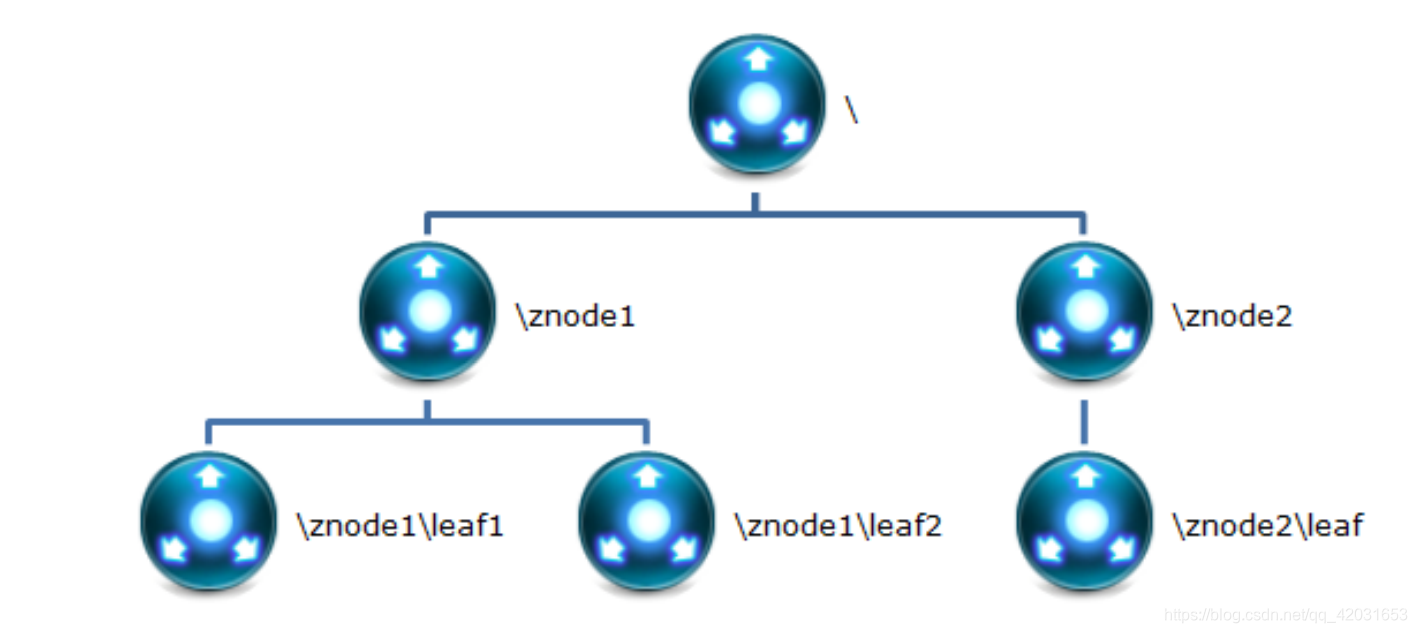
Znode :
在 Zookeeper 中,znode 是一个跟 Unix 文件系统路径相似的节点,可以往这个节点存储或获取数据。
Zookeeper 底层是一套数据结构。这个存储结构是一个树形结构,其上的每一个节点,我们称之为“znode”
zookeeper 中的数据是按照“树”结构进行存储的。而且 znode 节点还分为 4 中不同的类型。
每一个 znode 默认能够存储 1MB 的数据(对于记录状态性质的数据来说,够了可以使用 zkCli 命令,登录到 zookeeper 上,并通过 ls、create、delete、get、set 等命令操作这些 znode 节点
安装单机版 :
安装 Linux
安装 JDK
上传 Zookeeper
解压 Zookeeper 压缩包
[root@localhost temp]# tar -zxf zookeeper-3.4.6.tar.gz

[root@localhost temp]# cp zookeeper-3.4.6 /usr/local/zookeeper -r
Zookeeper 目录结构:
1. bin:放置运行脚本和工具脚本,如果是 Linux 环境还会有有 zookeeper 的运行日志 zookeeper.out
2. conf:zookeeper 默认读取配置的目录,里面会有默认的配置文件
3. contrib:zookeeper 的拓展功能
4. dist-maven:zookeeper 的 maven 打包目录
5. docs:zookeeper 相关的文档
6. lib:zookeeper 核心的 jar
7. recipes:zookeeper 分布式相关的 jar 包
8. src:zookeeper 源码
配置 Zookeeper:
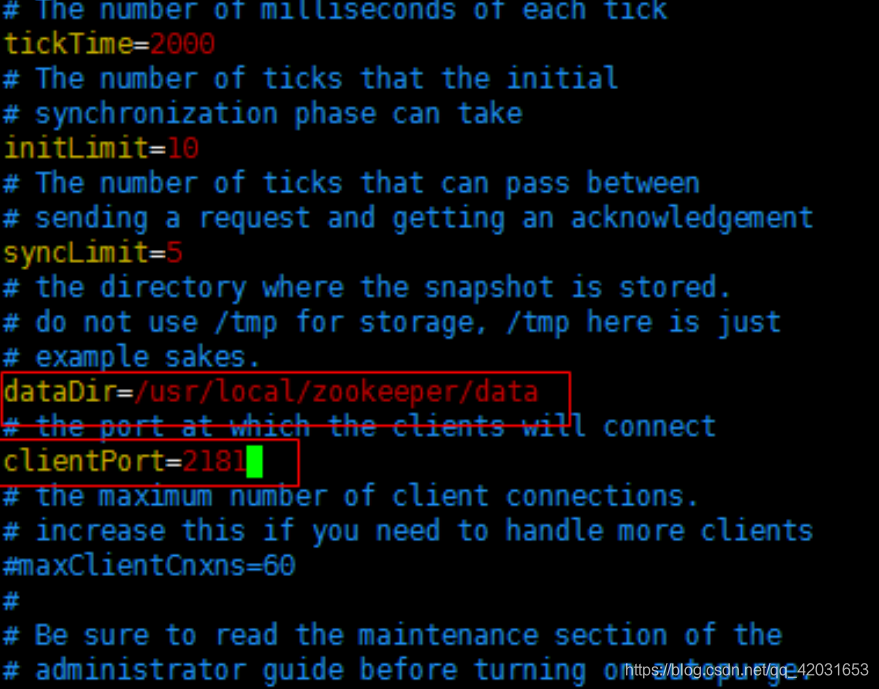
Zookeeper 在启动时默认的去 conf 目录下查找一个名称为 zoo.cfg 的配置文件在 zookeeper 应用目录中有子目录 conf。其中有配置文件模板:zoo_sample.cfg cp zoo_sample.cfg zoo.cfg。zookeeper 应用中的配置文件为 conf/zoo.cfg。修改配置文件zoo.cfg - 设置数据缓存路径
启动 Zookeeper :
默认加载配置文件:./zkServer.sh start:默认的会去 conf 目录下加载 zoo.cfg 配置文件。
指定加载配置文件:./zkServer.sh start 配置文件的路径。
安装集群版:
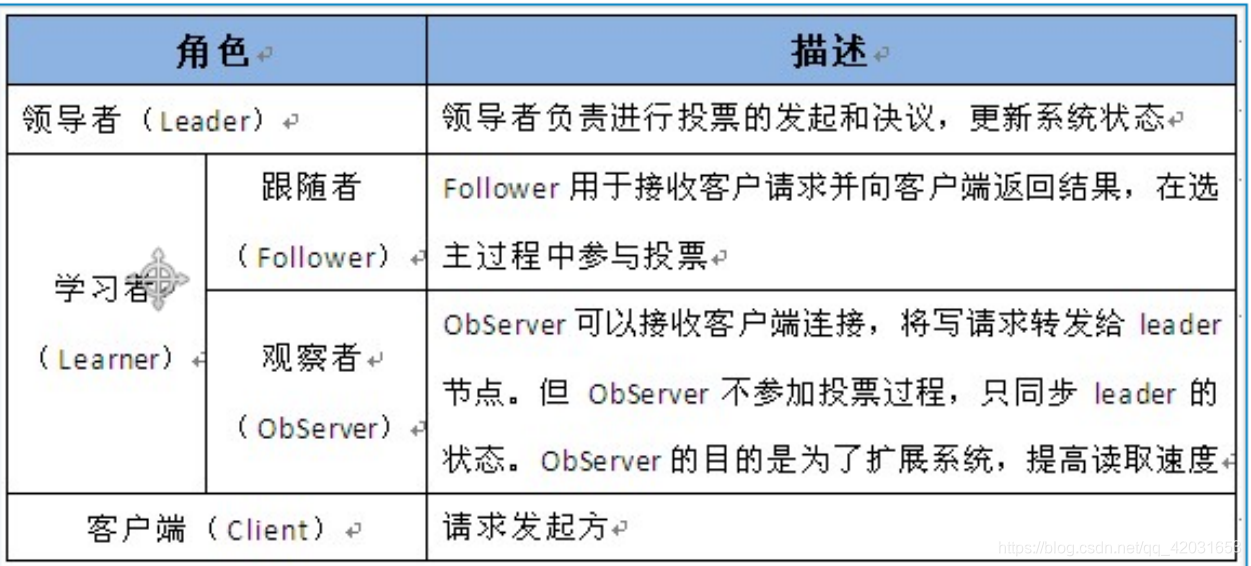
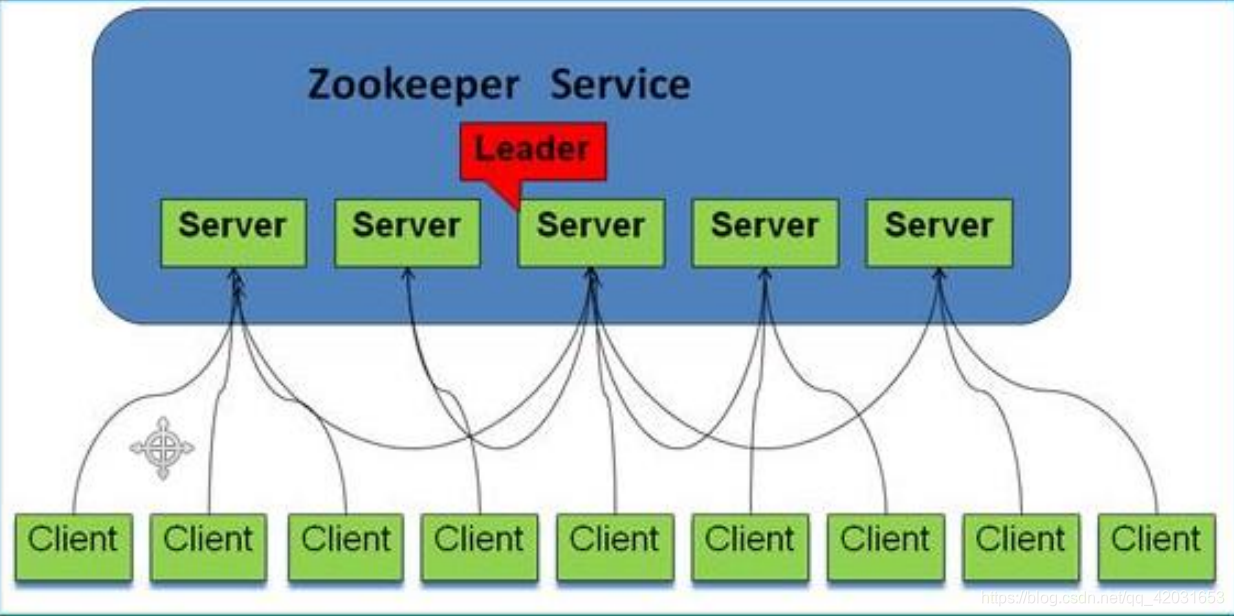
Zookeeper 集群中的角色:
设计目的:
1.最终一致性:client 不论连接到哪个 Server,展示给它都是同一个视图,这是 zookeeper最重要的性能。
2 .可靠性:具有简单、健壮、良好的性能,如果消息 m 被到一台服务器接受,那么它将被所有的服务器接受。
3 .实时性:Zookeeper 保证客户端将在一个时间间隔范围内获得服务器的更新信息,或者服务器失效的信息。但由于网络延时等原因,Zookeeper 不能保证两个客户端能同时得到 刚更新的数据,如果需要最新数据,应该在读数据之前调用 sync()接口。
4 .等待无关(wait-free):慢的或者失效的 client 不得干预快速的 client 的请求,使得每个 client 都能有效的等待。
5.原子性:更新只能成功或者失败,没有中间状态。
6 .顺序性:包括全局有序和偏序两种:全局有序是指如果在一台服务器上消息 a 在消息
b 前发布,则在所有 Server 上消息 a 都将在消息 b 前被发布;偏序是指如果一个消息 b 在消息 a 后被同一个发送者发布,a 必将排在 b 前面。
集群安装:
使用 3 个 Zookeeper 应用搭建一个伪集群。应用部署位置是:192.168.70.143。服务监听端口分别为:2181、2182、2183。投票选举端口分别为 2881/3881、2882/3882、2883/3883。
tar -zxf zookeeper-3.4.6.tar.gz
将解压后的 Zookeeper 应用目录重命名,便于管理
mv zookeeper-3.4.12 zookeeper01
提供数据缓存目录:
在 zookeeper01 应用目录中,创建 data 目录,用于缓存应用运行数据
cd zookeeper01
mkdir data
复制应用 :
复制两份 Zookeeper 应用。用于模拟集群中的 3 个节点。
cp -r zookeeper01 zookeeper02
cp -r zookeeper01 zookeeper03
提供配置文件:
在 zookeeper 应用目录中有子目录 conf。其中有配置文件模板:zoo_sample.cfg
cp zoo_sample.cfg zoo.cfg
zookeeper 应用中的配置文件为 conf/zoo.cfg。
修改配置文件 zoo.cfg - 设置数据缓存路径:
dataDir 参数值为应用运行缓存数据保存目录。是 3.2.3 步骤中创建的目录。使用绝对路径赋值。不同的应用路径不同。
提供应用唯一标识:
在 Zookeeper 集群中,每个节点需要一个唯一标识。这个唯一标识要求是自然数。且唯一标识保存位置是:$dataDir/myid。其中 dataDir 为配置文件 zoo.cfg 中的配置参数
在 data 目录中创建文件 myid : touch myid为应用提供唯一标识。本环境中使用 1、2、3 作为每个节点的唯一标识。
vi myid
简化方式为: echo [唯一标识] >> myid。 echo 命令为回声命令,系统会将命令发送的数据返回。 '>>'为定位,代表系统回声数据指定发送到什么位置。 此命令代表系统回声数据发送到 myid 文件中。 如果没有文件则创建文件。
修改配置文件 zoo.cfg - 设置服务、投票、选举端口:
vi zoo.cfg
clientPort=2181 #服务端口根据应用做对应修改,zk01-2181,zk02-2182,zk03-2183

server.1=192.168.70.143:2881:3881

server.2=192.168.70.143:2882:3882

server.3=192.168.70.143:2883:3883
启动 ZooKeeper 应用:
bin/zkServer.sh start
ZooKeeper 集群搭建后,至少需要启动两个应用才能提供服务。因需要选举出主服务节点。启动所有 ZooKeeper 节点后,可使用命令 bin/zkServer.sh status 来查看节点状态。如下:
Mode: leader - 主机
Mode: follower - 备份机
关闭 ZooKeeper 应用 :
bin/zkServer.sh stop 命令为关闭 ZooKeeper 应用的命令。
控制台访问 ZooKeeper 应用 :
bin/zkCli.sh -server 192.168.199.175:2181
命令格式为: zkCli.sh -server host:port。默认连接 localhost:2181。
ZooKeeper初步的更多相关文章
- Zookeeper初步了解
Zookeeper初步了解: Zookeeper实现了许多复杂的事情,例如实现了Zookeeper Atomic Broadcasting Protocal来广播状态信息的变化,Fast Paxas ...
- zookeeper 初步学习
配置文件: tickTime:这个时间是作为 Zookeeper 服务器之间或客户端与服务器之间维持心跳的时间间隔,也就是每个 tickTime 时间就会发送一个心跳. dataDir:顾名思义就是 ...
- Zookeeper的安装和初步使用
1. Zookeeper集群角色 Zookeeper集群的角色: Leader 和 follower (Observer) zk集群最好配成奇数个节点 只要集群中有半数以上节点存活,集群就能提供 ...
- ZooKeeper1 利用虚拟机搭建自己的ZooKeeper集群
前言: 前段时间自己参考网上的文章,梳理了一下基于分布式环境部署的业务系统在解决数据一致性问题上的方案,其中有一个方案是使用ZooKeeper,加之在大数据处理中,ZooKeeper确实起 ...
- zookeeper入门讲解事例
zookeeper使用和原理探究(一) zookeeper介绍zookeeper是一个为分布式应用提供一致性服务的软件,它是开源的Hadoop项目中的一个子项目,并且根据google发表的<Th ...
- 分布式消息系统Kafka初步
终于可以写kafka的文章了,Mina的相关文章我已经做了索引,在我的博客中置顶了,大家可以方便的找到.从这一篇开始分布式消息系统的入门. 在我们大量使用分布式数据库.分布式计算集群的时候,是否会遇到 ...
- 基于ZooKeeper的分布式Session实现(转)
1. 认识ZooKeeper ZooKeeper—— “动物园管理员”.动物园里当然有好多的动物,游客可以根据动物园提供的向导图到不同的场馆观赏各种类型的动物,而不是像走在原始丛林里,心惊胆颤的被 ...
- zookeeper使用和原理探究(一)
zookeeper介绍zookeeper是一个为分布式应用提供一致性服务的软件,它是开源的Hadoop项目中的一个子项目,并且根据google发表的<The Chubby lock serv ...
- Zookeeper+Kafka+Storm+HDFS实践
Kafka是一种高吞吐量的分布式发布订阅消息系统,它可以处理消费者规模的网站中的所有动作流数据. Hadoop一般用在离线的分析计算中,而storm区别于hadoop,用在实时的流式计算中,被广泛用来 ...
随机推荐
- SysTick系统定时器
1.SysTick定时器介绍 SysTick定时器也叫SysTick滴答定时器,它是Cortex-M3内核的一个 外设,被嵌入在 NVIC 中.它是一个24 位向下递减的定时器,每计数一 次所需时间为 ...
- Redis必备面试题《基础篇》
Date:2019-11-12 读前思考: 面试官会问什么样的问题? 所问的问题背后真实的套路是什么? 喜欢问Redis哪些问题? 如何顺畅回答面试问的问题?吊打面试官. 1.什么是Redis? Re ...
- java-optional-快速使用-教程
前言: 在公司中开发项目时碰到一个从Java8引入的一个Optional类,以前jdk版本使用的比较低,没有使用过,于是我在网上浏览了一些文档写篇文章学习总结一下,希望没有用过的朋友们都能够快速学习到 ...
- Python 基础之socket编程(一)
Python 基础之socket编程(一) 可以进行通信玩儿了,感觉不错不错,网络通信就像打电话,我说一句你听一句之后,你再说一句,我听一句,就这样.....下去了.不扯淡了,来来来,看看今天都搞了点 ...
- 【Swift】UNNotificationServiceExtension
一.简介 An object that modifies the content of a remote notification before it's delivered to the user. ...
- Apache Spark 3.0 预览版正式发布,多项重大功能发布
2019年11月08日 数砖的 Xingbo Jiang 大佬给社区发了一封邮件,宣布 Apache Spark 3.0 预览版正式发布,这个版本主要是为了对即将发布的 Apache Spark 3. ...
- ASP.NET Core 1.0: 指定Static File中的文件作为default page
指定一个网站的default page是很容易的事情.譬如IIS Management中,可以通过default page来指定,而默认的index.html, index.htm之类,则早已经被设置 ...
- 斐波那契数列的实现(C语言)
int fibonacci(int positon){ if(position==1||position==2){ return 1; } return fibonacci(position-1)+f ...
- 06_K-近邻算法
k-近邻算法 算法介绍 定义: 如果一个样本在特征空间中的k个最相似(即特征空间中最邻近)的样本中的大多数属于某一类别,则该样本也属于这个类别. 计算距离公式:欧式距离 (两点之间距离) 需要做标准化 ...
- 力扣(LeetCode)移除元素 个人题解
给定一个数组 nums 和一个值 val,你需要原地移除所有数值等于 val 的元素,返回移除后数组的新长度. 不要使用额外的数组空间,你必须在原地修改输入数组并在使用 O(1) 额外空间的条件下完成 ...