前期准备
操作系统
hadoop目前对linux操作系统支持是最好的,可以部署2000个节点的服务器集群;在hadoop2.2以后,开始支持windows操作系统,但是兼容性没有linux好。因此,建议在MAC OS或者linux(CentOS或者Unbuntu)操作系统上安装。
安装java
hadoop2.6以前的版本,需要jdk1.6以上的版本;从hadoop2.7开始,则需要jdk1.7以上的版本。
对于linux操作系统用户
tar zxvf jdk-8u161-linux-x64.tar.gz -C /opt
接着就需要配置环境变量
编辑环境变量文件,添加如下代码
$ vim /etc/profile
export JAVA_HOME=/opt/jdk1.8.0_161
export PATH=$PATH:$JAVA_HOME/bin
对于MacOS操作系统用户
接着就需要配置环境变量
编辑环境变量文件,添加如下代码
$ vim /etc/profile
export JAVA_HOME=/Library/Java/JavaVirtualMachines/jdk1.8.0_161.jdk/Contents/Home
export PATH=$PATH:$JAVA_HOME/bin
检查java是否安装成功
$ java -version
输入上面的命令后,会输出java的基本信息
安装Hadoop
hadoop的安装方式有三种,本地模式、伪分布模式和完全分布模式。三种模式安装步骤有少许区别,本文介绍伪分布模式,也是开发环境最常用的方式。
通过
官方网站下载hadoop版本,建议安装2.6版本,此版本相对更稳定,也是使用最为广泛的版本。
$ tar zxvf hadoop-2.6.0.tar.gz -C /opt
配置环境变量
$vim /etc/profile
export HADOOP_HOME=/opt/hadoop-2.6.0
export HADOOP_CONF_DIR=$HADOOP_HOME/etc/hadoop
export PATH=$PATH:$HADOOP_HOME/bin:$HADOOP_HOME/sbin
hadoop配置文件
/opt/hadoop-2.6.0/hadoop-env.sh:
export JAVA_HOME=使用你上面配置的java_home路径
export HADOOP_OPTS=-Djava.net.preferIPv4Stack=true
/opt/hadoop-2.6.0/core-site.xml:
<configuration>
<property>
<name>fs.defaultFS</name>
<value>hdfs://localhost:9000</value>
</property>
<property>
<name>hadoop.tmp.dir</name>
<value>/opt/hadoop-2.6.0/tmp</value>
</property>
<property>
<name>fs.trash.interval</name>
<value>1440</value>
<!--垃圾保存一天-->
</property>
/opt/hadoop-2.6.0/hdfs-site.xml:
<configuration> <property> <name>dfs.replication</name> <value>1</value> </property> </configuration>
/opt/hadoop-2.6.0/mapred-site.xml
<configuration>
<property>
<name>mapreduce.framework.name</name>
<value>yarn</value>
</property>
</configuration>
/opt/hadoop-2.6.0/yarn-site.xml
<configuration>
<property>
<name>yarn.log-aggregation-enable</name>
<value>true</value>
</property>
<property>
<name>yarn.log.server.url</name>
<value>http://localhost:19888/jobhistory/job/</value>
</property>
<property>
<name>yarn.nodemanager.aux-services</name>
<value>mapreduce_shuffle</value>
</property>
<property>
<!-- 设置HDFS可以使用硬盘的百分比,对于硬盘小的人很重要 -->
<name>yarn.nodemanager.disk-health-checker.max-disk-utilization-per-disk-percentage</name>
<value>99.0</value>
</property>
</configuration>
SSH免密码登录
检查一下,是否可以对本地进行免密码登录
$ ssh localhost
如果你在ssh本地时,需要输入密码,那么按以下步骤,配置免密码登录
$ ssh-keygen -t rsa -P '' -f ~/.ssh/id_rsa $ cat ~/.ssh/id_rsa.pub >> ~/.ssh/authorized_keys $ chmod 0600 ~/.ssh/authorized_keys
格式化hdfs目录
$ hdfs namenode -format
该命令执行后,只会格式化你的/opt/hadoop-2.6.0/tmp目录
启动HDFS
$ start-dfs.sh
启动hdfs后,会生成日志文件,在$HADOOP_HOME/logs目录下
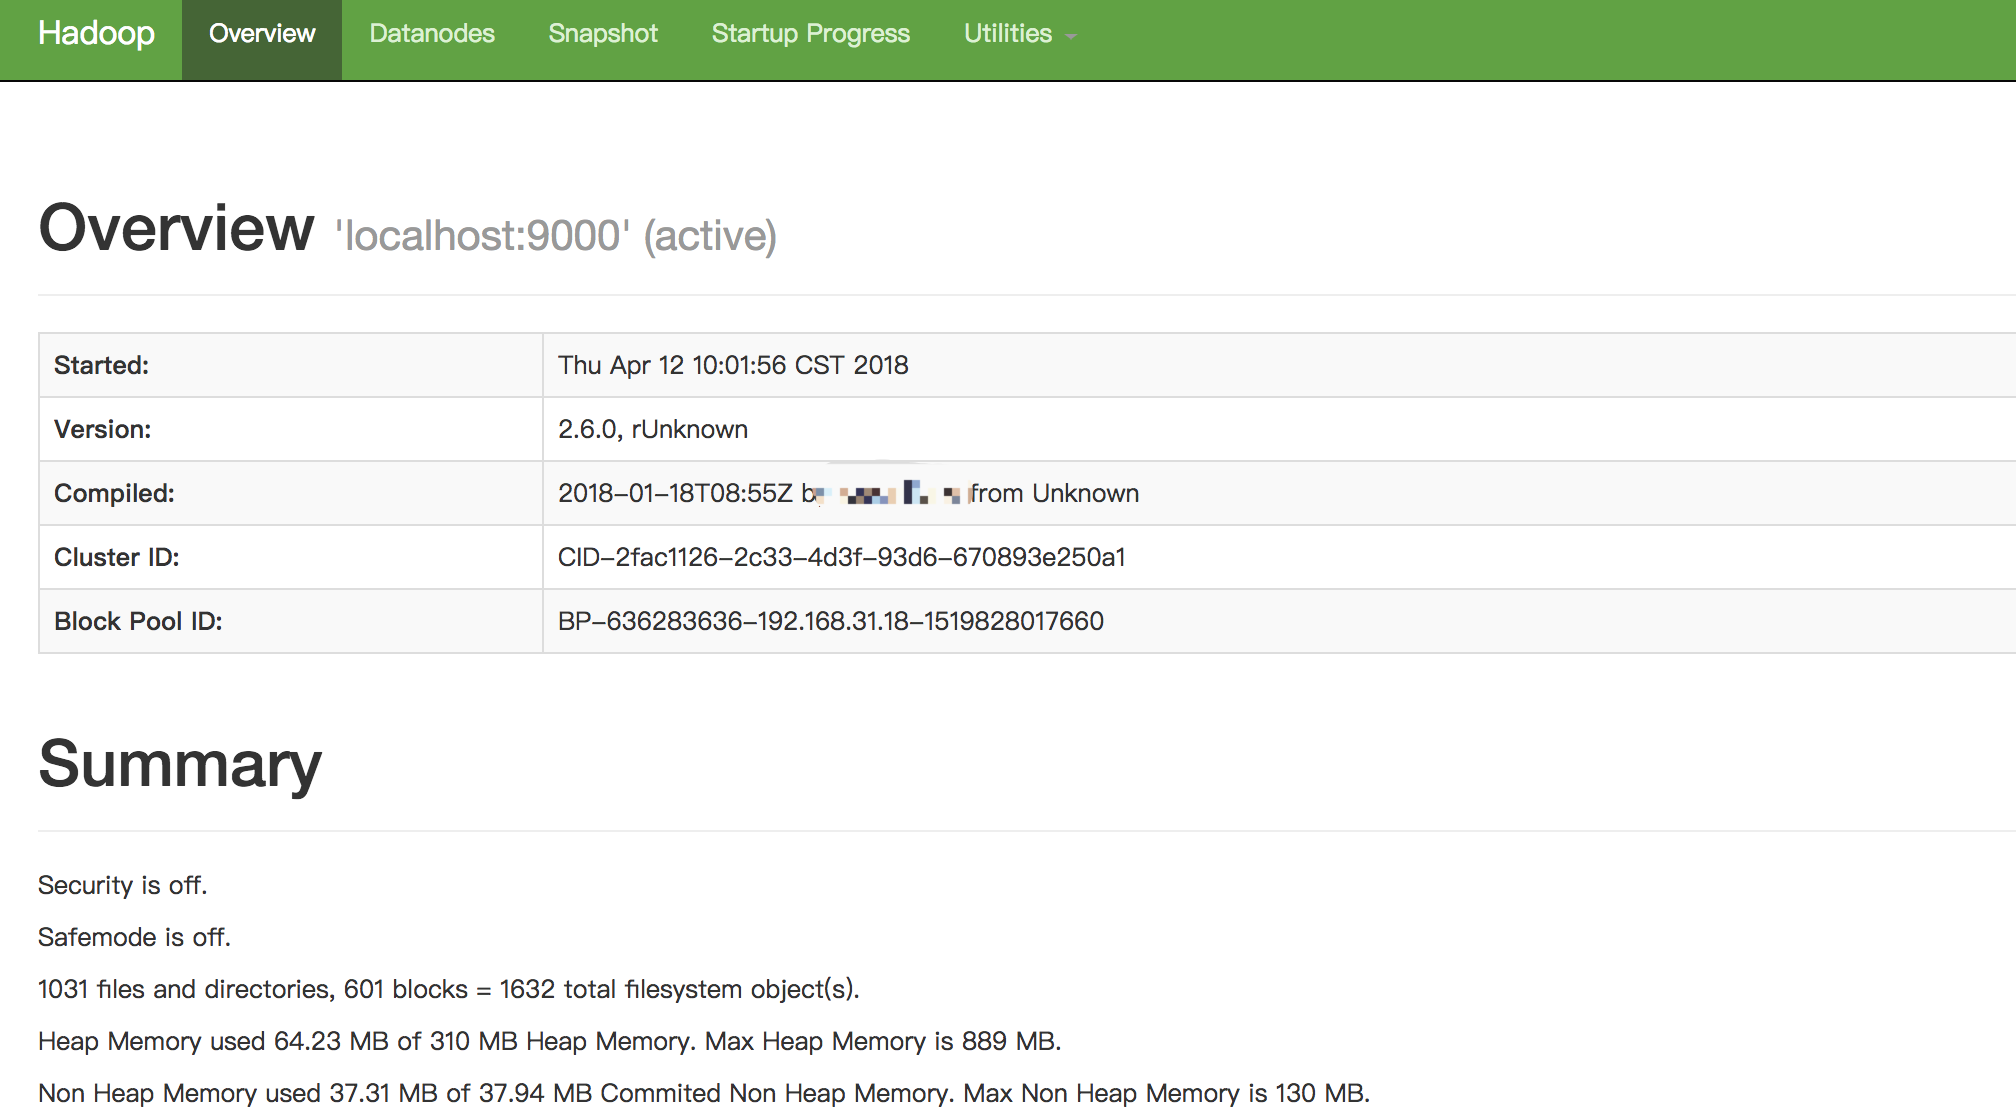
如果启动成功,你可以通过浏览器打开http://localhost:50070/,查看hdfs的相关信息
如果你想停止hdfs,请输入以下命令
$ stop-dfs.sh
启动yarn
$ start-yarn.sh
启动yarn后,会生成日志文件,在$HADOOP_HOME/logs目录下
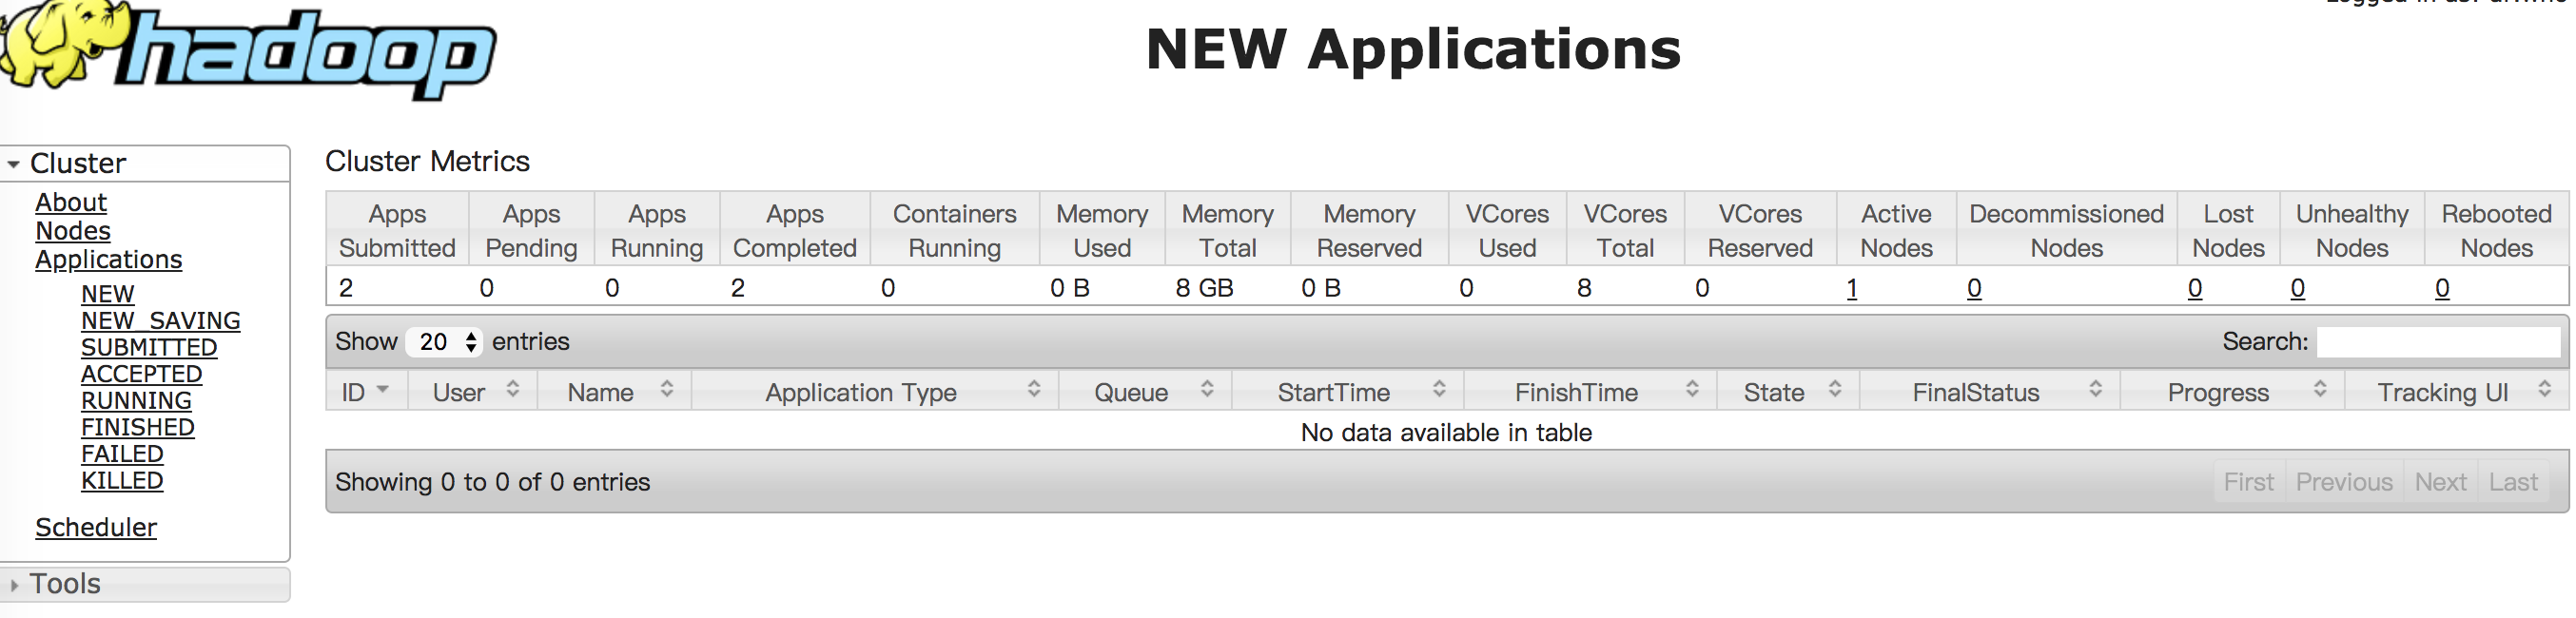
如果启动成功,你可以通过浏览器打开http://localhost:8088/,查看yarn的相关信息
如果你想停止yarn,请输入以下命令
$ stop-yarn.sh
启动JobHistory
$ mr-jobhistory-daemon.sh start historyserver
启动JobHistory后,会生成日志文件,在$HADOOP_HOME/logs目录下
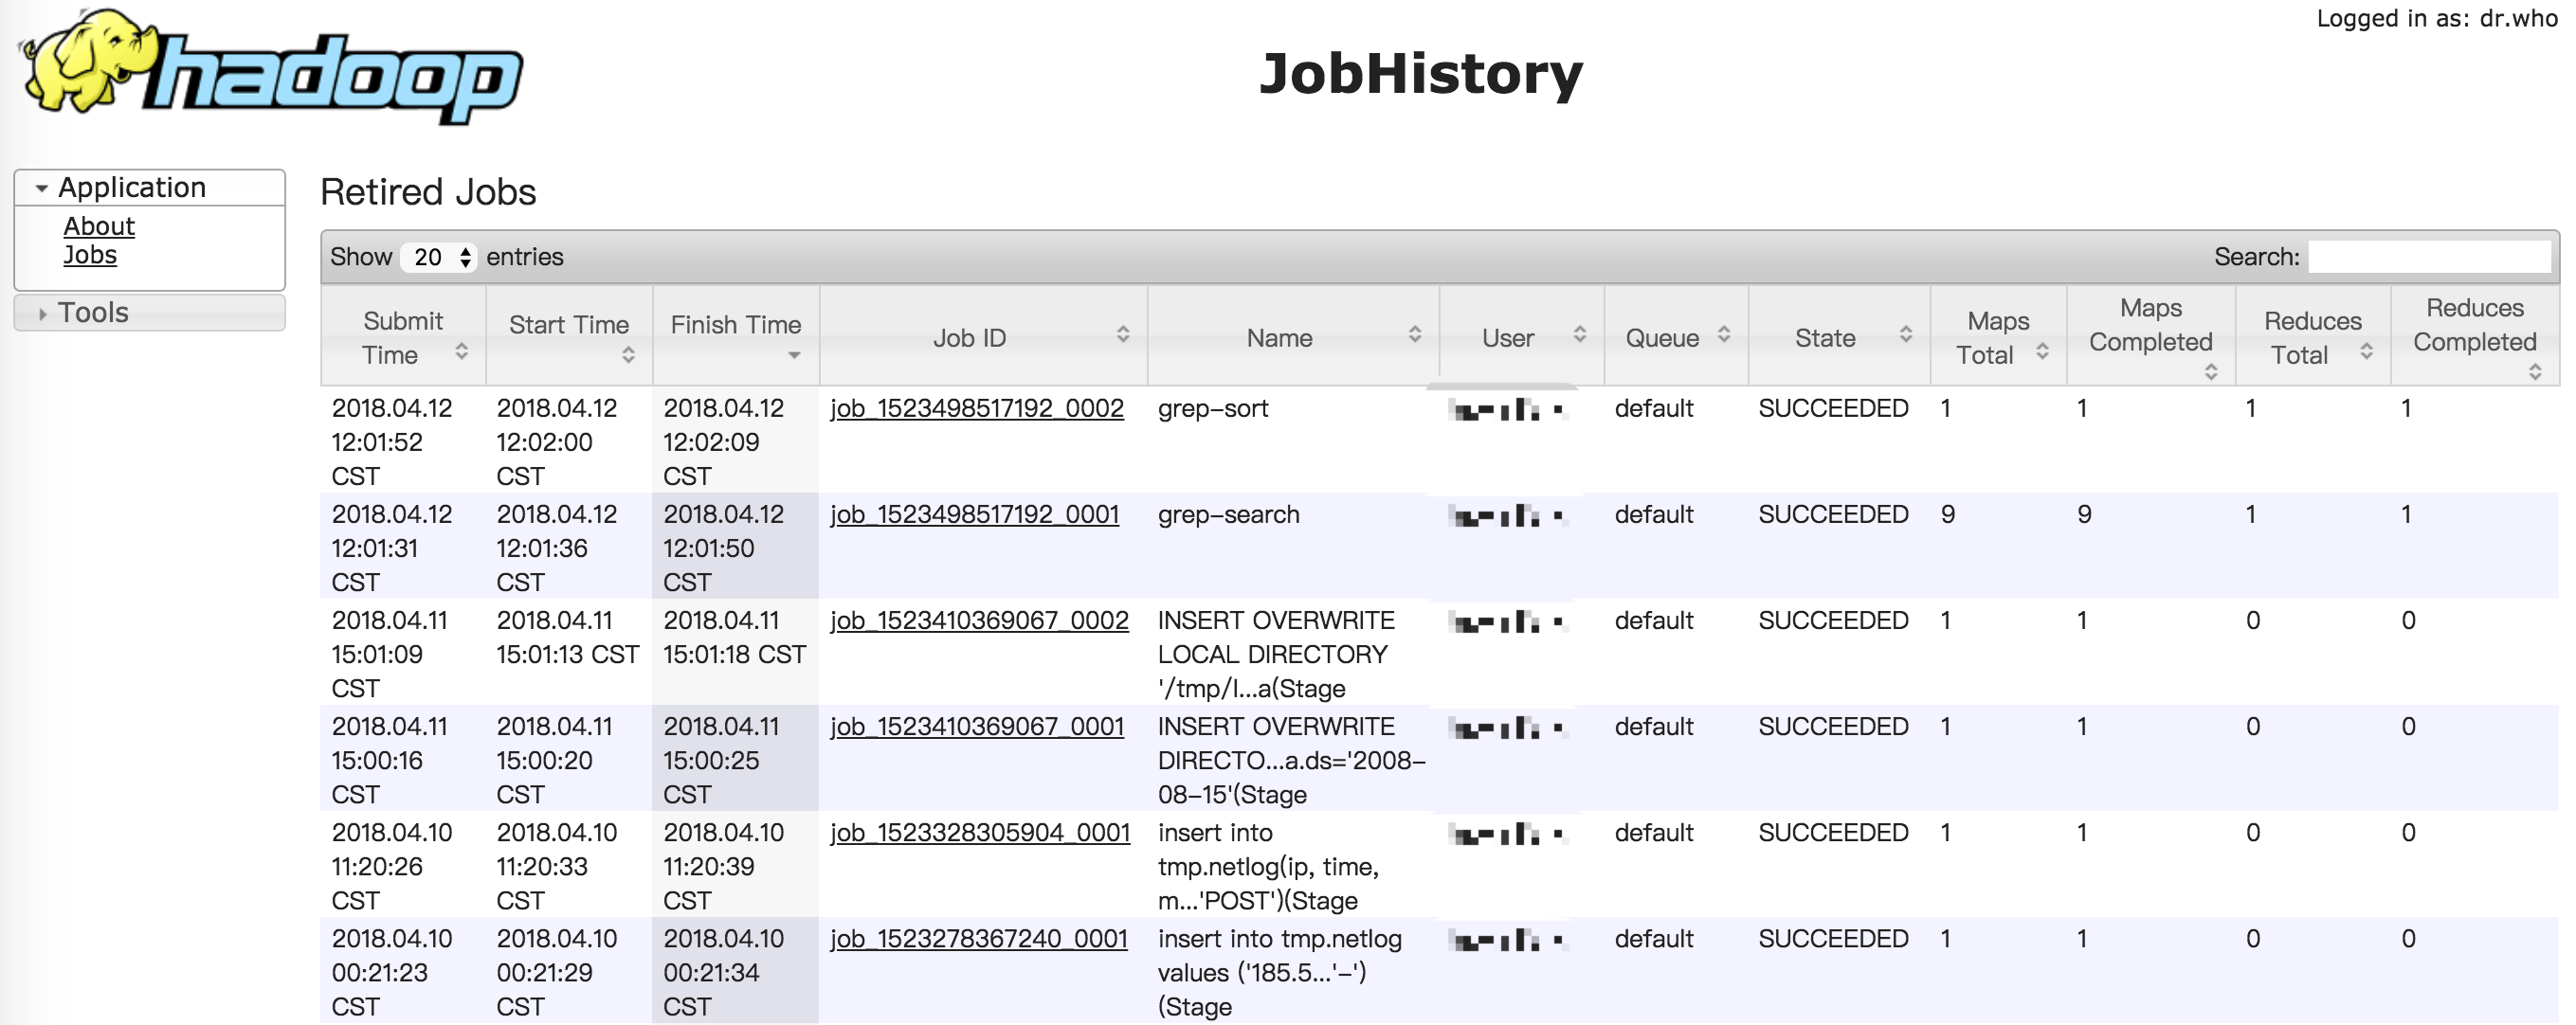
如果启动成功,你可以通过浏览器打开http://localhost:19888/,查看jobhistory的相关信息
如果你想停止JobHistory,请输入以下命令
$ mr-jobhistory-daemon.sh stop historyserver
测试hadoop
成功安装完hadoop后,我们可以通过一些命令来感受一下hadoop
创建目录
$ hdfs dfs -mkdir /tmp/input
上传本地文件到hdfs $ hdfs dfs -put $HADOOP_HOME/etc/hadoop/*.xml /tmp/input
使用MapReduce来计算我们刚才上传文件的以dfs开头的单词个数
$ hadoop jar $HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-examples-2.6.0.jar grep /tmp/input /tmp/output 'dfs[a-z.]+'
查看MapReduce的结果
可以把hdfs上的结果文件下载到本地后查看
$ hdfs dfs -get /tmp/output output $ cat output/*
也可以通过hdfs查看命令直接查看
$ hdfs dfs -cat /tmp/output/part-r-00000
通过查询http://localhost:8088/,你会发现刚才执行MapReduce任务的历史记录


- windows下大数据开发环境搭建(2)——Hadoop环境搭建
一.所需环境 ·Java 8 二.Hadoop下载 http://hadoop.apache.org/releases.html 三.配置环境变量 HADOOP_HOME: C:\hadoop- Pa ...
- windows下大数据开发环境搭建(4)——Spark环境搭建
一.所需环境 · Java 8 · Python 2.6+ · Scala · Hadoop 2.7+ 二.Spark下载与解压 http://spark.apache.org/downloads.h ...
- windows下大数据开发环境搭建(1)——Java环境搭建
一.Java 8下载 https://www.oracle.com/technetwork/java/javase/downloads/jdk8-downloads-2133151.html 下载之后 ...
- windows下大数据开发环境搭建(3)——Scala环境搭建
一.所需环境 ·Java 8 二.下载Scala https://www.scala-lang.org/download/ 三.配置环境变量 SCALA_HOME: C:\scala Path: ...
- 大数据开发,Hadoop Spark太重?你试试esProc SPL
摘要:由于目标和现实的错位,对很多用户来讲,Hadoop成了一个在技术.应用和成本上都很沉重的产品. 本文分享自华为云社区<Hadoop Spark太重,esProc SPL很轻>,作者: ...
- 搭建Hadoop+Python的大数据开发环境
实验环境 CentOS镜像为CentOS-7-x86_64-Everything-1804.iso 虚机配置 节点名称 IP地址 子网掩码 CPU/内存 磁盘 安装方式 master 192.168. ...
- windows下大数据开发环境搭建(1)——Hadoop环境搭建
所需环境 jdk 8 Hadoop下载 http://hadoop.apache.org/releases.html 配置环境变量 HADOOP_HOME: C:\hadoop-2.7.7 Path: ...
- 小白入门AI教程:教你快速搭建大数据平台『Hadoop+Spark』
Apache Spark 简介 Apache Spark 是专为大规模数据处理而设计的快速通用的计算引擎.Spark是UC Berkeley AMP lab (加州大学伯克利分校的AMP实验室)所开源 ...
- Eclipse和PyDev搭建完美Python开发环境 Windows篇
1,安装Python Python是一个跨平台语言,Python从3.0的版本的语法很多不兼容2版本,官网找到最新的版本并下载:http://www.python.org, 因为之前的一个项目是2版本 ...
随机推荐
- 解决ionic 启动页面图片没有显示及启动页出现黑白屏
1.ionic 正确打包完app, 并且按照正常的步骤配置config.xml文件之后 ,启动页面还是不能正常的显示出来,而是黑了一下之后,就进入首页了 原因很有可能就是你没有装cordova-plu ...
- unity,C#,游戏面试笔试真题
最开始的两家公司笔试面试题目 一家公司是学校聘请研究教育方面VR课件的公司,面试没几天,就收到了面试通过的消息,后面因为通过了另一家游戏公司而拒绝了. 另一家公司是一家游戏外企,在春熙路,当时笔试还可 ...
- Mybatis与SQL Server类型转换遇到的坑
一. MyBatis SQL语句遇到的性能问题 1. 场景还原 假设我们有一张User表,其中包含userId.userName.gender字段,其中userId的数据类型为char(20),此时我 ...
- MySQL之PXC集群搭建
一.PXC 介绍 1.1 PXC 简介 PXC 是一套 MySQL 高可用集群解决方案,与传统的基于主从复制模式的集群架构相比 PXC 最突出特点就是解决了诟病已久的数据复制延迟问题,基本上可以达到实 ...
- xcode7中搭建python开发环境
1. 双击打开Xcode 2. 点击File->New->New Project 3. 在左边的面板选择Other,右边选择External Build Sytem,点击Next 4. 输 ...
- P2762 太空飞行计划问题 最大权闭合子图
link:https://www.luogu.org/problemnew/show/P2762 题意 承担实验赚钱,但是要花去对应仪器的费用,仪器可能共用.求最大的收益和对应的选择方案. 思路 这道 ...
- CodeForces 979 D Kuro and GCD and XOR and SUM
Kuro and GCD and XOR and SUM 题意:给你一个空数组. 然后有2个操作, 1是往这个数组里面插入某个值, 2.给你一个x, k, s.要求在数组中找到一个v,使得k|gcd( ...
- 2018中国大学生程序设计竞赛 - 网络选拔赛 hdu6438 Buy and Resell 买入卖出问题 贪心
Buy and Resell Time Limit: 2000/1000 MS (Java/Others) Memory Limit: 65536/65536 K (Java/Others)To ...
- CF1005D Polycarp and Div 3 思维
Polycarp and Div 3 time limit per test 3 seconds memory limit per test 256 megabytes input standard ...
- Caused by: com.fasterxml.jackson.databind.exc.InvalidDefinitionException: No serializer found for class org.apache.catalina.connector.CoyoteWriter and no properties discovered to create BeanSerializer
一.什么是序列化In computer science, in the context of data storage, serialization is the process of transla ...